Welche Aktie gewinnt?
Geben Sie zwei Ticker ein — DUEL vergleicht sie anhand von 8 Fundamentalfaktoren aus SEC-EDGAR-Daten und zeigt in Sekunden den relativen Sieger.
DUEL testenWas DUEL kann
Zwei Aktien vergleichen
Vergleichen Sie beliebige zwei börsennotierte US-Unternehmen in Sekunden.
8 Fundamentalfaktoren
Umsatzwachstum, ROIC, operative Cashflow-Marge und mehr — basierend auf SEC-Daten.
Relativer Vergleich
Keine absolute Bewertung, sondern die Antwort: welche Aktie ist gerade stärker.
Kostenlos + PRO
5 kostenlose Duelle pro Tag, mit PRO unbegrenzt und eigene Gewichtung.
So funktioniert's
Zwei Ticker eingeben
Auf DUEL klicken
Ergebnis und Analyse ansehen
Methodik-Artikel
Cash-Konversion, Verschuldungsdiagnostik und Pfade der Kapitalverwendung – Befunde aus SEC-Einreichungen nicht-finanzieller US-amerikanischer Large-Cap-Peers. Deskriptive Methodenforschung. Keine Anlageberatung.
Zusammenfassung
Ein einzelner Faktor-Score sagt einem Anleger, wer stärker ist. Er sagt ihm nicht, ob diese Stärke auf beiden Seiten des Vergleichs auf dieselbe Weise zustande kommt, und auch nicht, ob sich das Bild dieses Jahres dem des Vorjahres annähert oder sich davon entfernt. Dieser Beitrag geht einer engeren, stärker diagnostischen Frage nach: Stimmt bei zehn nicht-finanziellen Peer-Paaren aus acht GICS-Sektoren das statische Faktorniveau eines Unternehmens überein mit (a) einem strukturellen Diagnose-Flag zu seiner Rechnungslegung (Papiergewinne, nicht positives Eigenkapital, Investitionssog, kein Sicherheitspolster), (b) der Richtung, in die sich seine Margen- und Wachstumsfaktoren gegenüber dem Vorjahr bewegen, und (c) der Verwendung seines tatsächlichen Cashflows in den zurückliegenden drei Geschäftsjahren? Wir kombinieren acht aus SEC-Daten abgeleitete Faktoren, vier binäre Diagnose-Flags, jährliche Vorperioden-Deltas, die unmittelbar aus aufeinanderfolgenden 10-K-Berichten berechnet werden, eine Sektor-Positionierungskarte auf Basis derselben Faktorfamilie sowie ein dreijähriges Kapitalverwendungs-Ledger (Dividenden, Aktienrückkäufe, M&A, Aktienausgabe, Nettoverschuldung, Barmittel) für zwanzig Unternehmen. Drei Befunde stechen heraus. Erstens sagt ein Papiergewinn-Flag weder ein verlorenes Duell noch eine sich verschlechternde Cash-Story voraus – die beiden klarsten Fälle in diesem Panel (Coca-Cola, Chevron) haben ihren paarweisen Vergleich beide gewonnen und ihre operative Cash-Konversion gegenüber dem Vorjahr beide verbessert; das Flag gibt also Auskunft über die Struktur der Rechnungslegung, nicht über die Entwicklung und nicht darüber, wer gewinnt. Zweitens ist nicht positives Eigenkapital nicht eine Geschichte, sondern zwei: McDonald's und Starbucks tragen dasselbe Flag und gehen aus einem identischen 50–50-Duell hervor, doch ihre Vorperioden-Deltas verlaufen in entgegengesetzte Richtungen, und nur eines der beiden Paare ist tatsächlich unterscheidbar, sobald das Debt/Equity-Verhältnis selbst nicht verfügbar ist. Drittens klärt das dreijährige Kapitalverwendungs-Ledger regelmäßig eine Frage, die ein einzelner Faktor-Snapshot offenlässt – nämlich ob eine ausgewiesene Free-Cashflow-Marge diskretionäre Kapitalrückführung, Reinvestition oder ein strukturell dünnes Polster angesichts einer Cash-Burn-Entwicklung widerspiegelt. Wir verstehen dies als deskriptive Peer-Diagnostik auf Basis öffentlicher Einreichungen und nicht als Übung in Renditeprognose oder Markt-Timing, und diese Grenze benennen wir durchgängig ausdrücklich.
1. Einleitung
Der relative, paarweise Vergleich zweier Unternehmen anhand derselben, aus SEC-Daten abgeleiteten Faktoren – Gegenstand eines Begleitbeitrags auf dieser Website – löst ein bestimmtes Problem: Er neutralisiert das sektor- und makroökonomische Rauschen, das jede isolierte Kennzahl verzerrt, sodass der Leser Signal mit Signal vergleicht und nicht Niveau mit Niveau. Ein zweiter Begleitbeitrag hat gezeigt, dass die acht Faktoren hinter diesem Vergleich keine acht voneinander unabhängigen Informationen darstellen; in einer Hauptkomponentenanalyse auf dem ursprünglichen Acht-Faktoren-Set verdichten sie sich auf vier empirisch unterscheidbare Komponenten – Cash-Konversion, Kapitaleffizienz, Wachstum und Accrual-Qualität. Im aktuellen Faktorset ist der Forderungsumschlag (Receivables Turnover) inzwischen durch Debt/Equity ersetzt worden, das das Produkt als fünfte, gesondert ausgewiesene Gruppe behandelt, neben denselben vier. Diese aktuelle Taxonomie aus fünf Gruppen – Growth (Wachstum), Margin Conversion (Konversion der Marge in Cash), Capital Efficiency (Kapitaleffizienz), Accrual Quality (Accrual-Qualität) und Financial Strength (Finanzkraft) – verwenden wir in diesem Beitrag überall dort, wo Faktoren gruppiert werden, auch bei der Lesart der Lücken im Relative Price Chart in Abschnitt 6.5. Beide Beiträge beantworten die Frage, wie viel Gewicht jeder Faktor tragen sollte und wie sich die beiden Unternehmen auf diesem Faktorset derzeit zueinander verhalten.
Keiner der beiden Beiträge beantwortet eine dritte, ebenso praxisrelevante Frage: Ist das Bild stimmig? Ein Unternehmen kann eine attraktive operative Marge ausweisen, während seine Cash-Konversion weit dahinter zurückbleibt – ein Muster, das unabhängig davon, auf welcher Seite eines Duells das Unternehmen steht, für sich genommen eine Markierung verdient. Ein Unternehmen kann ein Debt/Equity-Verhältnis von exakt null zeigen, nicht weil es keine Verschuldung trägt, sondern weil sein Buchwert des Eigenkapitals selbst negativ geworden ist und die Kennzahl gar nicht berechnet werden kann. Die in diesem Jahr ausgewiesene FCF-Marge eines Unternehmens kann das Ergebnis einer echten Verbesserung gegenüber dem Vorjahresbericht sein – oder einer echten Verschlechterung, die durch ein kleineres Rückkaufprogramm überdeckt wird. Nichts davon ist aus einem einzelnen Querschnitts-Score ersichtlich. Alles wird sichtbar, sobald vier Dinge für dasselbe Paar nebeneinandergestellt werden: die statischen Faktorniveaus, eine kleine Zahl struktureller Diagnose-Flags, die Richtung derselben Faktoren gegenüber dem Vorjahr laut vorherigem 10-K und die Verwendung des tatsächlichen Cashflows des Unternehmens in den letzten drei Geschäftsjahren.
Der Beitrag dieses Papiers besteht darin, diese vierteilige Diagnostik – Flags, Vorperioden-Deltas, Geometrie der Positionierungskarte und dreijährige Kapitalverwendung – in einem deskriptiven Rahmen zu formalisieren und ihn nicht an einer einzelnen Fallstudie, sondern an einem bewusst heterogenen Querschnitt aus zehn nicht-finanziellen Peer-Paaren anzuwenden. Wir behaupten nicht, dass die resultierenden Diagnosen Renditen prognostizieren, und wir erheben auch keinen Anspruch auf eine vollständige Taxonomie aller Muster, die die Berichte eines Unternehmens hervorbringen können. Wir behaupten, dass die vier Bausteine zusammen gelesen dem Leser eines Paarvergleichs mehr bieten als die Summe ihrer Teile: Sie erlauben ihm nicht nur zu fragen, „wer ist stärker“, sondern auch, „ist die Geschichte dieses Unternehmens in sich stimmig, und wird sie mit der Zeit stimmiger oder weniger stimmig“.
2. Verwandte Literatur
Die Literatur zur Accrual-Qualität beginnt mit Sloan (1996), der zeigte, dass die Accrual-Komponente der Gewinne systematisch weniger persistent ist als die Cash-Komponente und dass der Markt auf diese Unterscheidung unterreagiert. Dechow, Ge und Schrand (2010) geben einen Überblick über die breitere Literatur zur Gewinnqualität und die vielen Proxys – Accruals, Glättung, Zeitnähe, Persistenz –, die aus diesem Ausgangspunkt hervorgegangen sind; unser Papiergewinn-Flag (operative Cash-Marge, Operating Cash Margin, OCM, unterhalb eines festen Bruchteils der operativen Marge, OM) und unser Faktor Sloan Ratio stehen mitten in dieser Tradition, werden jedoch auf der Ebene eines einzelnen Peer-Vergleichs angewandt und nicht in einer Querschnittsregression. Ohlson (1995) und der Residualgewinn-Ansatz, wie ihn Penman in Financial Statement Analysis zusammenführt, begründen es, den Buchwert des Eigenkapitals und sein Vorzeichen als eigenständig aussagekräftig zu behandeln und nicht als Nenner, den man als gegeben hinnimmt; unser Flag für nicht positives Eigenkapital ist eine unmittelbare, bewusst grobe Anwendung dieser Idee – wenn der Nenner einer Verschuldungskennzahl negativ geworden ist, hört die Kennzahl auf, ein Verschuldungssignal zu sein, und wird zu einem Signal anderer Art (über aufgelaufene Verluste oder anhaltend hohe Rückkaufintensität), das der Leser benannt sehen sollte, statt dass es stillschweigend ausgeblendet wird. Lev und Nissim (2006) greifen die Accrual-Anomalie mit neueren Daten und granulareren Accrual-Komponenten erneut auf und bekräftigen, dass der ökonomische Gehalt von Accruals über ihre Teilkomponenten hinweg nicht einheitlich ist – eine Vorsicht, die wir auf unser eigenes Accrual-Flag auf Basis einer einzelnen Kennzahl übertragen, das wir als grobes Raster und nicht als vollständige Diagnose behandeln.
Auf der Ausschüttungsseite dokumentieren Grullon und Michaely (2002, 2004) die langfristige Substitution von Dividenden durch Aktienrückkäufe in der US-amerikanischen Ausschüttungspolitik und deren Implikationen dafür, wie ein Markt die Kürzung oder Erhöhung der einen oder der anderen Ausschüttungsform lesen sollte; das begründet, unser dreijähriges Kapitalverwendungs-Ledger als vollständige Buchungsidentität zu lesen (Free Cashflow gegenüber Dividenden, Rückkäufen, M&A, Aktienausgabe und Nettoverschuldung), statt Rückkäufe oder Dividenden isoliert zu betrachten. Die breitere Literatur zu Finanzierungsrestriktionen (in unterschiedlicher Form zusammengefasst, etwa bei Almeida, Campello und Weisbach zum Wert von Liquidität) liegt unserer Behandlung zugrunde, den Barmittelbestand eines Cash verbrennenden Unternehmens, geteilt durch seine Burn Rate, als Runway-Signal und nicht als Bewertungssignal zu lesen.
Schließlich orientieren wir uns ausdrücklich an der Literatur zu XBRL und zur SEC-Berichterstattung, soweit sie Lücken in der Tag-Abdeckung behandelt: Nicht jedes Unternehmen kennzeichnet jedes Konzept identisch, „Mergers and Acquisitions“ und „Operating Income“ insbesondere werden von den berichtenden Unternehmen mit deutlich unterschiedlicher Granularität getaggt, und ein fehlender Tag ist eine Tatsache zur Datenverfügbarkeit in der XBRL-Einreichung eines bestimmten Unternehmens, kein Beleg dafür, dass die zugrunde liegende Aktivität nicht stattgefunden hat. Einen Strich in unseren eigenen Tabellen behandeln wir entsprechend und kommen darauf in den Limitationen ausdrücklich zurück.
3. Forschungsfragen und Hypothesen
RQ1. In welchen Konstellationen bleibt die OCM so weit hinter der OM zurück, dass das Papiergewinn-Flag ausgelöst wird (OCM unterhalb des 0.7-Fachen der OM), und tritt diese Konstellation gemeinsam auf mit (a) einer sich verschlechternden Entwicklung der Cash-Konversion gegenüber dem Vorjahr oder (b) einem aggressiven Rückkaufprogramm, das auf einer schwachen Free-Cashflow-Basis aufrechterhalten wird?
RQ2. Wie häufig ist Debt/Equity nicht verfügbar, weil der Buchwert des Eigenkapitals selbst nicht positiv ist, und deckt sich diese Nichtverfügbarkeit mit einer Kapitalverwendungshistorie, die von kumulierten Aktienrückkäufen dominiert wird – genau die Geschichte, die ein Flag für nicht positives Eigenkapital sichtbar machen soll –, statt mit schlichten fehlenden Daten?
RQ3. Liefert die Sektor-Positionierungskarte (Sustainable Growth, d. h. nachhaltiges Wachstum, auf der x-Achse; Quality-Adjusted Cash Margin, d. h. qualitätsbereinigte Cash-Marge, auf der y-Achse; Punktfarbe nach Debt/Equity) ein visuelles Bild, das mit der Faktoraufschlüsselung und den Vorperioden-Deltas für die „stärkere“ bzw. „schwächere“ Seite jedes Duells übereinstimmt?
RQ4. Liefert eine dreijährige Kapitalverwendung allein auf Basis von 10-K-Berichten Informationen, die in einem einzelnen Querschnitts-Snapshot der acht Faktoren nicht sichtbar sind – etwa indem sie eine hohe FCF-Marge, die auf einer rückkauflastigen Ausschüttung beruht, von einer trennt, die auf Reinvestition beruht, oder ein Cash verbrennendes Unternehmen mit langer Runway von einem trennt, das sich der Erschöpfung nähert?
RQ5 (nur deskriptiv). Stimmt über das in einem Relative Price Chart sichtbare Fenster die Richtung des Kursverhältnisses zwischen zwei Peers mit der Richtung überein, die sich aus ihren fundamentalen Lücken zwischen den Faktorgruppen ergibt, oder driften Kurs und Fundamentaldaten auseinander? Diese Frage wird der Vollständigkeit halber aufgenommen und nicht als Handelssignal gelesen.
H1. Ein Papiergewinn-Flag geht häufiger mit einem neutralen bis negativen Vorperioden-Delta der FCF-Marge oder der Sloan Ratio einher als mit einem klar verbesserten Trend der Cash-Konversion.
H2. Nicht positives Eigenkapital ist systematisch mit hohen kumulierten Rückkäufen im Kapitalverwendungs-Ledger verbunden und sollte nicht als „geringe Verschuldung“ gelesen werden, nur weil sich eine Kennzahl nicht berechnen ließ.
H3. Punkte im Quadranten mit hohem Wachstum und hoher Cash-Qualität der Positionierungskarte entsprechen häufiger einem nicht negativen Free Cashflow und aktiver Kapitalrückführung als allein dem Umsatzwachstum.
H4. Ein günstiges Vorperioden-Delta bei einer invertierten Kennzahl (Sloan Ratio, Debt/Equity – bei denen ein Rückgang die Verbesserung ist) ist ein aussagekräftigeres Signal der „Stärkung“ als das isolierte statische Niveau derselben Kennzahl.
H5. Der dreijährige Kapitalverwendungspfad erklärt einen Teil dessen, was eine statische FCF-Marge offenlässt – nämlich wohin der Cash tatsächlich geflossen ist: in Schuldentilgung, Rückkäufe, M&A oder Aufbau von Barmitteln.
4. Institutioneller Rahmen und Messung
Alle Daten stammen aus den SEC-EDGAR-Company-Facts (10-K-Berichte; 10-Q dort, wo ausdrücklich vermerkt, für die „aktuellen“ Faktorwerte des Relative Price Chart) und werden über die Vergleichs-Engine auf duelstocks.com abgerufen. Acht Faktoren gehen mit Standardgewichten in jeden paarweisen Score ein: Umsatzwachstum 18%, operative Marge (OM) 9%, Operating Cash Margin (OCM) 9%, FCF-Marge 9%, ROIC 17%, Asset Turnover 7%, Sloan Ratio 17%, Debt/Equity 14%. Das Umsatzwachstum wird als dreijährige durchschnittliche jährliche Wachstumsrate (CAGR) gemessen; Sloan Ratio und Debt/Equity werden vor der Bewertung beide invertiert, sodass bei beiden der niedrigere Wert der stärkere ist. Für jeden Faktor fließen die Rohwerte der beiden Unternehmen in eine weiche Normalisierung ein, t = (a' − b') / (|a'| + |b'| + ε), N_a = 0.5 + 0.5·t, N_b = 0.5 − 0.5·t, sodass ein kleiner Abstand ein nahezu unentschiedenes Ergebnis und ein großer Abstand einen nahezu klaren Sieg ergibt, statt das Gewicht nach dem Alles-oder-nichts-Prinzip zu verteilen. Der Endwert ist das 100-Fache der gewichteten Summe der N-Werte.
Vier strukturelle Flags sind auf Basis desselben Faktorsets definiert und werden unabhängig vom paarweisen Score ausgewertet:
- Papiergewinne (Paper profits) – OCM < OM × 0.7. Ein Unternehmen, dessen buchhalterische operative Marge deutlich über dem Cash liegt, den seine operative Tätigkeit tatsächlich hervorbringt.
- Nicht positives Eigenkapital (Non-positive equity) – Buchwert des Eigenkapitals ≤ 0, sodass Debt/Equity nicht berechnet werden kann; das Verschuldungssignal ist keine normale Kennzahl und muss aus der Kapitalverwendungshistorie gelesen werden.
- Investitionssog (CapEx vacuum) – FCF-Marge < OCM × 0.3. Operativer Cashflow, den die Investitionsausgaben fast vollständig aufzehren, bevor er zu freiem Cashflow wird.
- Kein Sicherheitspolster (No safety cushion) – FCF-Marge < 0 und Debt/Equity > 1.5. Negativer Free Cashflow in Verbindung mit einer bereits erhöhten Verschuldung, und nicht bloß negativer Free Cashflow bei einer ansonsten sauberen Bilanz.
Vorperioden-Deltas (Δ prior) sind die Veränderung eines Faktors zwischen zwei aufeinanderfolgenden Einreichungen desselben Typs bei der SEC – in dieser Stichprobe Jahr über Jahr, 10-K zu 10-K. Margen- und Wachstums-Deltas werden in Prozentpunkten ausgewiesen; die Deltas von Asset Turnover und Debt/Equity in Vielfachen (×); die Farbkonvention für Sloan Ratio und Debt/Equity ist invertiert, da ein Rückgang bei beiden die Richtung der Verbesserung ist. Wir haben diese Deltas direkt aus den beiden jüngsten Jahresberichten jedes Unternehmens berechnet und nicht aus einem einzelnen Querschnittsabruf, und wir halten dieselbe Disziplin hinsichtlich des gleichen Periodentyps ein wie das Live-Vergleichstool: Ein 10-K wird nur mit dem vorherigen 10-K verglichen, nie mit einem unterjährigen 10-Q, sodass ein Delta nie durch eine Teiljahres-Basis verzerrt wird.
Die Sektor-Positionierungskarte zeigt jeden Bestandteil eines GICS-Sektors auf zwei Achsen, die aus derselben Faktorfamilie wie der paarweise Score aufgebaut sind: Sustainable Growth auf der horizontalen und Quality-Adjusted Cash Margin auf der vertikalen Achse, wobei die Punktfarbe nach Debt/Equity kodiert ist (grün für niedrige, grau für moderate Verschuldung, rot oberhalb einer Schwelle von 1.5×, sowie eine eigene Farbe für Unternehmen, bei denen Debt/Equity wegen nicht positiven Eigenkapitals gar nicht berechnet werden konnte – wodurch das Flag für nicht positives Eigenkapital auf der Karte selbst sichtbar wird und nicht nur in der Faktortabelle).
Die dreijährige Kapitalverwendung ist ein Ledger mit geschlossener Identität, das auf denselben drei jüngsten 10-K-Berichten beruht: Free Cashflow, gezahlte Dividenden, Aktienrückkäufe, Akquisitionen, Aktienausgabe, Veränderung der Nettoverschuldung und die daraus folgende Veränderung der Barmittel, endend im ausgewiesenen Barmittelbestand. Ein Strich in einer Zeile bedeutet, dass für diesen Posten in diesem Berichtsjahr keine getaggte Aktivität vorliegt – keine imputierte Null –, und wir erhalten diese Unterscheidung durchgängig, statt Striche und echte Nullen in dieselbe Kategorie zu werfen.
5. Stichprobe und Paare
Das Panel umfasst zehn Peer-Paare mit zwanzig Unternehmen aus acht nicht-finanziellen GICS-Sektoren. Das Universum schließt bewusst Finanzwerte aus (wo sich Kapitalstruktur und die Bedeutung von „Verschuldung“ aufgrund regulatorischer Vorgaben unterscheiden) sowie Immobilien (wo REIT-typische Ausschüttungspflichten eine unmittelbare Lesart von Rückkäufen und Dividenden gegenüber dem Free Cashflow erschweren). Die Paare wurden so gewählt, dass alle vier strukturellen Flags abgedeckt sind und der Querschnitt der Sektoren breit genug ist, damit die Rechnungslegungskonventionen einer einzelnen Branche die Befunde nicht dominieren.
| Paar | Sektor | Warum es im Panel ist |
|---|---|---|
| MCD vs SBUX | Zyklischer Konsum | Beide Seiten tragen das Flag für nicht positives Eigenkapital; Ankerfall für RQ2/H2 |
| KO vs PEP | Basiskonsumgüter | KO trägt das Papiergewinn-Flag und gewinnt das Duell; Ankerfall für RQ1/H1 |
| AAPL vs MSFT | Informationstechnologie | Reife Free-Cashflow-Generatoren, Rückkäufe gegenüber Reinvestition |
| GOOGL vs META | Kommunikationsdienste | Neue Dividendenprogramme, hohe Rückkäufe, eine M&A-Tag-Lücke für die Limitationen |
| TSLA vs RIVN | Zyklischer Konsum | Ein profitabler, skalierter Produzent gegenüber einem Cash verbrennenden Peer in der Frühphase |
| CAT vs DE | Industrie | Kapitalintensive Zykliker, Dividendenzahler, Verschuldungskontrast |
| XOM vs CVX | Energie | CVX trägt das Papiergewinn-Flag innerhalb eines Rohstoff-Cash-Zyklus |
| AMZN vs WMT | Zyklischer Konsum / Basiskonsumgüter | Kontrast bei der Kapitalintensität; dasselbe Paar wie im Begleitbeitrag zu relativen Kennzahlen |
| JNJ vs PFE | Gesundheitswesen | PFE trägt das Papiergewinn-Flag; große, ungleichmäßige M&A-Aktivität |
| NEE vs SO | Versorger | Beide tragen das Investitionssog-Flag; SO zusätzlich „kein Sicherheitspolster“ |
6. Befunde
6.1 Flag-Diagnostik: Was Papiergewinne und nicht positives Eigenkapital tatsächlich aussagen
Drei Unternehmen dieses Panels tragen ein Papiergewinn-Flag: KO (operative Marge 28.7%, OCM 15.5%, Verhältnis 0.54), CVX (operative Marge 39.8%, OCM 18.0%, Verhältnis 0.45) und PFE (operative Marge 35.6%, OCM 18.7%, Verhältnis 0.53). Beim paarweisen Score haben zwei der drei – KO und CVX – ihr Duell klar gewonnen (56–44 gegen PEP; 53–47 gegen XOM); nur PFE hat verloren (38–62 gegen JNJ). Diese Aufteilung ist für sich genommen aufschlussreich: Ein Papiergewinn-Flag ist kein Stellvertreter für einen verlorenen Vergleich. Es benennt eine bestimmte strukturelle Lücke zwischen buchhalterischem Ertrag und Cash-Ertrag, und ein Unternehmen kann diese Lücke aufweisen und bei den übrigen sieben Faktoren dennoch die stärkere Seite eines paarweisen Vergleichs sein.
Die Entwicklung gegenüber dem Vorjahr schärft das Bild weiter, und hier wird H1 nur teilweise gestützt. Bei KO bewegte sich die operative Marge gegenüber dem Vorjahr um +7.5 Prozentpunkte, die OCM aber nur um +1.0 Punkte – die Lücke zwischen Buchhaltung und Cash weitete sich also, obwohl KO sein Duell gewann und obwohl sich auch seine FCF-Marge im selben Zeitraum um +1.0 Punkte verbesserte. Im Licht von H1 ist dies der Grenzfall, den die Hypothese vorhergesehen hat: eine sich weitende Lücke, aber keine sich verschlechternde FCF-Marge – das Flag erfasst eine echte Divergenz in der Bewegung der beiden Margen und keinen pauschalen Einbruch der Cash-Qualität. Bei CVX verbesserte sich die OCM gegenüber dem Vorjahr um +2.1 Punkte, während das statische Verhältnis von OCM zu OM (0.45) deutlich unter dem Auslöser von 0.7 bleibt – das Flag besteht im jüngsten Snapshot gerade deshalb fort, weil die operative Marge von CVX auf der buchhalterischen Seite des Rohstoffzyklus so hoch ist, dass selbst eine echt verbesserte Cash-Konversion sie nicht eingeholt hat. Beide Fälle sprechen dafür, das Flag zusammen mit seinem eigenen Delta zu lesen und nicht als statisches Ja/Nein.
Zwei Unternehmen tragen das Flag für nicht positives Eigenkapital: MCD und SBUX, die zugleich das einzige echte Unentschieden dieses Panels bilden, 50–50. Eigenkapital ≤ 0 bedeutet, dass Debt/Equity für keine der beiden Seiten berechnet wird – und das ist der Sinn des Flags, keine zufällige Datenlücke. Die dreijährigen Kapitalverwendungs-Ledger beider Unternehmen bestätigen den Mechanismus unmittelbar: MCD schüttete über Rückkäufe jährlich 2.06–3.05 Mrd. $ an die Aktionäre aus, zusätzlich zu 4.53–5.12 Mrd. $ an Dividenden, bei einem Free Cashflow von 6.67–7.25 Mrd. $ – eine Ausschüttungsintensität, die sich vollständig mit einer Eigenkapitalbasis verträgt, die durch anhaltende Kapitalrückführung und nicht durch operative Verluste ins Negative gedrückt wurde. SBUX zeigt bis FY2024 dasselbe qualitative Muster in kleinerem Maßstab (Rückkäufe von 0.98–1.27 Mrd. $), bevor es die Rückkäufe im jüngsten Geschäftsjahr auf null zurückfuhr, während sich der FCF über das Dreijahresfenster von 3.68 Mrd. $ auf 2.44 Mrd. $ grob halbierte – eine wesentlich andere Entwicklung, die beim selben strukturellen Flag ankommt. H2 wird für beide Unternehmen einzeln gut gestützt; was der Paarvergleich hinzufügt, ist, dass ein identisches Flag und ein identisches Unentschieden im Score auf zwei verschiedenen Kapitalverwendungs-Geschichten ruhen können – genau die Art von Verdeckung, die ein statischer Score allein nicht offenlegen würde.
6.2 Vorperioden-Deltas gegenüber statischen Niveaus
Die folgende Tabelle weist das jährliche Vorperioden-Delta (10-K zu 10-K) für Umsatzwachstum, operative Marge, OCM und FCF-Marge über das gesamte Panel aus. Die Werte sind in Prozentpunkten angegeben; ein Strich zeigt an, dass die zugrunde liegende Größe der in Abschnitt 4 beschriebenen Regel des gleichen Periodentyps unterliegt und an den auf der Website selbst angegebenen Faktorniveaus verankert ist, statt hier neu abgeleitet zu werden.
| Ticker | Zeitraum (aktuell → Vorperiode) | Δ Umsatzwachstum | Δ Operative Marge | Δ Op. Cash Margin | Δ FCF Margin | Einordnung |
|---|---|---|---|---|---|---|
| AAPL | 2025→2024 | −0.4 | +0.5 | −3.5 | −4.1 | Cash-Margen werden schwächer, obwohl Wachstums- und Margenniveaus gehalten werden |
| MSFT | 2026→2025 | +3.7 | +1.2 | +6.8 | −5.2 | Wachstum und Cash-Konversion beide höher; FCF durch CapEx/KI-Ausbau gedrückt |
| AMZN | 2025→2024 | +1.0 | +0.4 | +1.3 | −4.1 | Margen verbessern sich; FCF durch Investitionen gedrückt |
| WMT | 2026→2025 | −0.7 | −0.1 | +0.5 | +0.2 | Im Wesentlichen unverändert gegenüber dem Vorjahr |
| CAT | 2025→2024 | −4.0 | −3.7 | −1.2 | −2.3 | Zyklischer Rückgang bei Wachstum und Margen zugleich |
| DE | 2025→2024 | −4.6 | −3.7 | −1.5 | −1.3 | Gleiche zyklische Richtung wie CAT, geringere Ausprägung |
| GOOGL | 2025→2024 | +1.8 | −0.1 | +5.1 | −2.6 | Cash-Konversion steigt bei unveränderter operativer Marge |
| META | 2025→2024 | +8.2 | −0.7 | +2.1 | −9.9 | Starkes Wachstum, OCM verbessert sich weiter, FCF wegen Reinvestitionen deutlich niedriger |
| KO | 2025→2024 | −3.1 | +7.5 | +1.0 | +1.0 | Operative Marge springt; Cash-Konversion hält kaum Schritt – die Papiergewinn-Lücke weitet sich |
| PEP | 2025→2024 | −2.1 | −1.8 | −0.7 | n/a | Eine milde, breit angelegte Abschwächung |
| MCD | 2025→2024 | +1.3 | +0.9 | +2.8 | +1.0 | Verbesserung bei jeder ausgewiesenen Marge, trotz des Flags für nicht positives Eigenkapital |
| SBUX | 2025→2024 | −2.7 | −7.1 | −4.1 | −2.6 | Deutliche Verschlechterung bei jeder ausgewiesenen Marge |
| XOM | 2025→2024 | −15.1 | — | −0.1 | −1.7 | Rohstoffzyklisch bedingter Umsatzrückgang; Cash-Marge nahezu unverändert |
| CVX | 2025→2024 | −15.4 | — | +2.1 | +1.2 | Umsatz im Zyklus rückläufig; Cash-Konversion verbessert sich dennoch |
| JNJ | 2025→2024 | +3.7 | — | −1.3 | −1.4 | Leichte Abschwächung der Cash-Marge |
| PFE | 2025→2024 | −7.2 | — | −1.3 | −1.0 | Cash-Konversion hinkt der operativen Marge weiter hinterher; Flag besteht bei Niveau und Trend fort |
| NEE | 2025→2024 | −3.8 | ~0 | −8.0 | n/a | Cash-Marge sinkt bei ansonsten unveränderter operativer Marge |
| SO | 2025→2024 | −4.6 | −1.8 | −3.5 | −13.0 | FCF verschlechtert sich stark innerhalb eines ohnehin hohen Verschuldungsprofils |
| TSLA | 2025→2024 | −16.8 | −2.7 | +0.3 | +2.9 | Wachstum verlangsamt sich stark, obwohl die Margen halten oder leicht steigen |
| RIVN | 2025→2024 | −300.6 | +27.8 | +20.1 | +11.3 | Jeder Faktor verbessert sich von einer extrem niedrigen Basis aus – siehe Abschnitt 6.4 |
Zwei Punkte bestimmen, wie diese Tabelle zu lesen ist. Erstens bleiben die Deltas der operativen Marge für DE, JNJ, XOM und CVX leer, statt geschätzt zu werden: Die verfügbare XBRL-Kennzeichnung des operativen Ergebnisses lässt sich bei mehreren Energie- und Pharmaunternehmen nicht für jedes Unternehmen dieses Panels über aufeinanderfolgende Jahre eindeutig auf eine einzige vergleichbare Zeile abbilden, und wir weisen einen Strich aus statt einer Zahl, die wir nicht vertreten können – im Einklang mit der Disziplin bei der Datenherkunft aus Abschnitt 4. Zweitens ist das enorme Delta des Umsatzwachstums bei RIVN ein Artefakt eines sehr kleinen Nenners im Vorjahr und für sich genommen kein ökonomisch aussagekräftiges Signal einer Verlangsamung – deshalb liest Abschnitt 6.4 RIVN über die Runway aus der Kapitalverwendung und nicht allein über diese Tabelle.
Drei Fälle verdienen es, unmittelbar an H4 gemessen zu werden. MCD verbessert sich bei jeder ausgewiesenen Marge, obwohl es von den beiden Unternehmen seines Paares das scheinbar schwerwiegendere Flag trägt (nicht positives Eigenkapital) – das Delta, nicht das statische Flag, ist das aussagekräftigere Signal dafür, ob es besser oder schlechter wird, genau wie H4 vorhersagt. SBUX verschlechtert sich bei jeder ausgewiesenen Marge und trägt dabei dasselbe Flag, und die Deltas allein würden die beiden Unternehmen korrekt voneinander trennen, obwohl sie der statische Score bei 50–50 gleichstellt und der Flag-Text wortgleich ist. SO verbindet ein stark negatives FCF-Margen-Delta (−13.0 Punkte) mit dem bereits erhöhten Debt/Equity (1.72×, oberhalb der Schwelle von 1.5× für „kein Sicherheitspolster“) – das Delta zeigt, dass das Polster nicht nur dünn ist, sondern aktiv weiter ausdünnt.
6.3 Positionierungskarte gegenüber Faktoraufschlüsselung
Die Sektorkarte kodiert visuell unmittelbar zwei der strukturellen Dimensionen des Panels: die horizontale Position für nachhaltiges Wachstum, die vertikale Position für die qualitätsbereinigte Cash-Marge und die Punktfarbe für die Debt/Equity-Klasse. Drei Übereinstimmungen zwischen der Karte und der Faktortabelle sind berichtenswert, weil sie zusammen RQ3 betreffen.
Erstens markiert die Farbkodierung der Karte nicht positives Eigenkapital eigenständig. Auf der Karte für Zyklischen Konsum werden MCD und SBUX beide als gelbe Punkte dargestellt – die Farbe, die Unternehmen vorbehalten ist, bei denen Debt/Equity nicht berechnet werden kann –, statt in irgendeinem Ton des Spektrums von Grün bis Rot, das für jedes andere Unternehmen auf derselben Karte verwendet wird. Ein Leser, der allein die Karte betrachtet und keinen Zugang zum Flag-Text hat, würde bereits sehen, dass diese beiden Unternehmen außerhalb der normalen Farbskala der Verschuldung liegen. Auf der Karte der Versorger wird SO rot dargestellt (Debt/Equity 1.72×, oberhalb der Schwelle von 1.5×), während NEE mit 1.47× im benachbarten grauen Bereich und nicht in Rot erscheint – und damit korrekt widerspiegelt, dass NEE knapp unter derselben Schwelle liegt, die SO für „kein Sicherheitspolster“ markiert.
Zweitens folgt die vertikale Trennung auf der Karte innerhalb jedes Paares eng der Lücke bei der OCM. Auf der Karte für Kommunikationsdienste liegt META deutlich höher als GOOGL – im Einklang mit der OCM von 57.6% bei META gegenüber 40.9% bei GOOGL. Auf der Karte für Basiskonsumgüter liegen KO und PEP nahe beieinander in der Nähe der horizontalen Mittellinie des Sektors, im Einklang mit ihrer engeren OCM-Lücke (15.5% gegenüber 12.9%) im Vergleich zum Abstand zwischen META und GOOGL. Auf der Energiekarte erscheinen XOM und CVX als nahezu überlappende grüne Punkte in der Mitte der Sektorwolke – beide haben ein niedriges Debt/Equity (0.18× und 0.21×) und liegen bei der Cash-Marge dicht beieinander (15.6% gegenüber 18.0%), ein visuelles Beinahe-Unentschieden, das der engeren Seite der Score-Spreizung dieses Panels entspricht (CVX gewinnt 53–47, die zweitengste Differenz im Panel nach MCD-SBUX).
Drittens isoliert die Karte RIVN als sichtbaren Ausreißer, statt es in die Hauptwolke des Zyklischen Konsums einzuordnen. RIVN erscheint weit unten rechts auf der Sektorkarte – mit hoher horizontaler (Wachstums-)Position, getrieben durch den in Abschnitt 6.2 beschriebenen Niedrigbasis-Effekt, und weit unterhalb der horizontalen Mittellinie bei der Cash-Qualität, im Einklang mit einer OCM von −14.5%. Kein anderer auf dieser Karte sichtbarer Bestandteil liegt auch nur in der Nähe derselben Kombination aus extremem Wachstum und tief negativer Cash-Qualität, was die Lesart der Kapitalverwendung in Abschnitt 6.4 visuell vorwegnimmt, noch bevor ein Leser diese Tabelle öffnet.
Im Hinblick auf H3 ist die Evidenz der Positionierungskarten gemischt und nicht durchgängig bestätigend. Der Quadrant mit hohem Wachstum und hoher Cash-Qualität wird auf diesen Karten überwiegend von kleineren Bestandteilen außerhalb der zehn Fokuspaare besetzt (Namen wie SNDK und PLTR auf der Karte der Informationstechnologie, DASH und CCL auf der Karte des Zyklischen Konsums), während die Paare dieses Panels eher näher am Zentrum ihrer jeweiligen Sektorwolken liegen. Das ist für sich genommen ein Befund: In diesem Panel erfordert es nicht, im extremen Quadranten einer Sektorkarte mit dreißig bis achtzig Bestandteilen zu liegen, um die stärkere Seite eines Zwei-Unternehmen-Duells zu sein – MSFT, META und CVX gewinnen ihre Duelle alle, während sie in der oberen Mitte oder in der Mitte ihrer Sektorwolken liegen und nicht am äußersten Rand.
6.4 Dreijährige Kapitalverwendung
Drei Geschichten in diesem Panel belegen H5 unmittelbar – dass das Kapitalverwendungs-Ledger eine Frage klärt, die eine FCF-Marge für eine einzelne Periode offenlässt.
Die statische Faktortabelle von RIVN allein vermittelt ein Unternehmen, das Cash verbrennt (FCF-Marge −46.2%), mit negativem ROIC und negativer Sloan Ratio. Das Kapitalverwendungs-Ledger liefert die Information, die tatsächlich bestimmt, ob dies ein akutes oder ein chronisches Problem ist: einen Barmittelbestand von 3.58 Mrd. $ gegenüber einem FCF-Verbrauch im jüngsten Jahr, der bei der aktuellen Rate rund 1.4 Jahre Runway bedeutet, finanziert zum Teil durch Aktienausgabe (0.75 Mrd. $ im jüngsten Jahr, stark gestiegen gegenüber 0.06 Mrd. $ zwei Jahre zuvor) und nicht durch Schulden. Das ist eine wesentlich andere Lesart als „negativer Free Cashflow“ allein – es ist ein skalierender Produzent in der Frühphase, der einen wachsenden, aber weiterhin finanzierten Cash-Burn über Verwässerung finanziert, und kein Unternehmen, dem die vorhandenen Barmittel unmittelbar ausgehen.
Die statischen Faktoren von SO zeigen ein Investitionssog-Flag und im jüngsten Jahr eine negative FCF-Marge. Das dreijährige Ledger zeigt, dass dies kein Einzelfall ist: Der FCF bewegte sich über die drei ausgewiesenen Jahre von −1.54 Mrd. $ auf +0.83 Mrd. $ und wieder zurück auf −2.94 Mrd. $, während die Dividenden in jedem Jahr des Fensters im Wesentlichen unverändert bei rund 3 Mrd. $ gehalten wurden, unabhängig davon, ob der Free Cashflow in dem Jahr positiv oder negativ war, und die Nettoverschuldung in beiden der letzten zwei Jahre stieg. In Verbindung mit einem Debt/Equity-Verhältnis, das bereits über der Schwelle von 1.5× des Panels für „kein Sicherheitspolster“ liegt, zeigt das Ledger ein Unternehmen, das seine Ausschüttungszusage über die Aufnahme von Schulden aufrechterhält, und zwar auf einer Free-Cashflow-Basis, die in zwei der letzten drei Geschäftsjahre negativ war – genau die Konstellation, die das Flag „kein Sicherheitspolster“ sichtbar machen soll, und genau die Art von Muster, die ein Snapshot der FCF-Marge für eine einzelne Periode nicht von einem vorübergehenden, durch den Zeitpunkt der Investitionen bedingten Einbruch unterscheiden würde.
Das dreijährige Ledger von AMZN erzählt eine dritte Art von Geschichte. Der Free Cashflow hielt sich in den ersten zwei ausgewiesenen Jahren in einer engen Bandbreite von 32–33 Mrd. $, bevor er im jüngsten Jahr stark auf 7.7 Mrd. $ fiel, bei weder Dividende noch Rückkauf in keinem der drei Jahre und einem Umschwung von Schuldentilgung zu einer Netto-Schuldenaufnahme von 11.14 Mrd. $ im jüngsten Jahr. Gelesen gegen die statische Faktortabelle allein – in der die FCF-Marge von AMZN (21.5%) und die OCM (22.5%) beide klar vor WMT liegen – liefert das Ledger den Kontext, dass sich die eigene Cash-Erzeugung von AMZN gegenüber dem Vorjahr spürbar verdichtet hat, obwohl AMZN bei jedem Faktor der Cash-Konversion weiter vor WMT liegt, und dass AMZN diese Verdichtung über Schulden finanziert und nicht über eine Kürzung von Aktionärsrückflüssen, die es ohnehin nie vorgenommen hatte. Das Ledger von WMT zeigt dagegen Rückkäufe, die über dieselben drei Jahre von 2.78 Mrd. $ auf 8.09 Mrd. $ anwachsen, bei stetig wachsendem Free Cashflow – eine konventionelle, aus Cash finanzierte Beschleunigung der Aktionärsrückflüsse, die die statische Faktortabelle, in der WMT bei jedem Margenfaktor hinter AMZN zurückliegt, von sich aus nicht sichtbar machen würde.
6.5 Kursverhältnis gegenüber fundamentalen Lücken (nur deskriptiv)
Für das eine Paar, bei dem ein Relative Price Chart zusammen mit dem vollständigen Diagnose-Set erfasst wurde (MCD gegenüber SBUX), sank das Kursverhältnis MCD/SBUX von rund 2.95 im Juni auf rund 2.45 Anfang Oktober, wobei sein 50-Tage-Durchschnitt bei 2.53 lag – ein Kurstrend, in dem SBUX im gezeigten Fenster besser abschnitt als MCD. Das Panel zu den fundamentalen Lücken im selben Chart, aufgebaut aus derselben weichen t-Normalisierung wie in Abschnitt 4 beschrieben und gegliedert nach der in Abschnitt 1 beschriebenen Taxonomie aus fünf Gruppen, zeigte Margin Conversion (OCM) zugunsten von MCD geneigt (t = +0.51), während Capital Efficiency (ROIC, t = −0.43) und Accrual Quality (Sloan Ratio, t = −0.35) beide zugunsten von SBUX geneigt waren, Growth nahe der Parität lag (t = +0.02) und Financial Strength (Debt/Equity) für beide Seiten durch das gemeinsame Flag für nicht positives Eigenkapital blockiert war. Der Median über die vier verfügbaren Gruppen, t = −0.16, neigt sich leicht zugunsten von SBUX – in dieselbe Richtung wie der Kurstrend im selben Chart.
Wir lesen diesen einzelnen Fall als Beschreibung, nicht als Beweis: ein Paar, ein Fenster, ein Fall, in dem Fundamental- und Kursrichtung übereinstimmen statt auseinanderzulaufen. Die Delta-Tabelle in Abschnitt 6.2 zeigt die Vorperioden-Entwicklung desselben Paares deutlicher in der für SBUX ungünstigen Richtung (Δ operative Marge −7.1 Punkte, Δ FCF-Marge −2.6 Punkte) als in der für MCD günstigen, was zumindest vereinbar ist mit – wenngleich weit entfernt von einem Beleg für – einer Kursbewegung, die einer fundamentalen Verschlechterung folgte, die im Vorperioden-Delta bereits vor Beginn dieses Fensters sichtbar war. Wir dehnen diese deskriptive Beobachtung nicht auf die anderen neun Paare aus, für die kein Chart des Kursverhältnisses erfasst wurde, und wir lesen sie nicht als Beleg dafür, dass sich Kurs und Fundamentaldaten allgemein gemeinsam bewegen.
7. Diskussion
Gemeinsam gelesen weisen die Abschnitte 6.1 bis 6.5 aus vier verschiedenen Richtungen auf dasselbe Auslegungsprinzip: Ein Flag benennt ein strukturelles Muster, ein Delta benennt eine Richtung, eine Position auf der Karte benennt eine relative Stellung innerhalb einer breiteren Peer-Gruppe, und ein Kapitalverwendungs-Ledger benennt, wohin der Cash tatsächlich geflossen ist – und keines dieser vier ersetzt eines der anderen. Das Papiergewinn-Flag von KO besteht fort und weitet sich auf Basis der Vorperiode sogar aus, und dennoch gewinnt KO sein Duell deutlich, weil das Flag die Beziehung zwischen zwei bestimmten Margen betrifft und nicht das Aggregat der acht Faktoren. MCD und SBUX teilen ein identisches Flag und einen identischen Gleichstand im Score, bewegen sich dabei aber bei jedem ausgewiesenen Delta in entgegengesetzte Richtungen und finanzieren völlig unterschiedliche dreijährige Ausschüttungspfade. Die Faktortabelle von RIVN für eine einzelne Periode wirkt allein durchweg alarmierend; sein Kapitalverwendungs-Ledger liest sich wie das eines skalierenden Unternehmens mit finanzierter Runway und nicht wie eine unmittelbare Krise. In jedem Fall widerspricht die reichhaltigere Diagnostik der einfacheren nicht – sie fügt eine Dimension hinzu, die die einfachere nicht zu tragen angelegt war.
Für einen Anleger oder Analysten, der ein Paarvergleichstool in der Praxis nutzt, ergibt sich als operative Konsequenz eine Lesereihenfolge und keine einzelne Zahl: Man beginnt mit dem Score und den Flags, um zu sehen, wie die Rechnungslegungsstruktur jedes Unternehmens isoliert aussieht, geht dann zu den Vorperioden-Deltas über, um zu erkennen, ob sich diese Struktur verbessert oder verschlechtert, nutzt die Positionierungskarte, um beide Unternehmen innerhalb ihres breiteren Sektors zu verorten und nicht nur gegeneinander, und schließt mit dem dreijährigen Kapitalverwendungs-Ledger, um zu sehen, ob der durch die Margen implizierte Cash tatsächlich eingegangen ist und wohin er geflossen ist. Keiner dieser Schritte verlangt, den einzelnen paarweisen Score aufzugeben, den ein Begleitbeitrag auf dieser Website bereits in eigener Sache verteidigt hat; jeder Schritt beantwortet lediglich eine Frage, die ein einzelner Score konstruktionsbedingt nicht beantworten kann.
8. Limitationen
- Die XBRL-Tag-Abdeckung ist über die Unternehmen hinweg nicht einheitlich. Mehrere Energie- und Pharmaunternehmen dieses Panels kennzeichnen das operative Ergebnis nicht in einer einzigen, unmittelbar vergleichbaren Zeile von Jahr zu Jahr, weshalb Abschnitt 6.2 für JNJ, PFE, XOM und CVX einen Strich statt eines geschätzten Deltas der operativen Marge ausweist; der Strich spiegelt Unterschiede in der Berichtsstruktur wider und nicht das Fehlen der zugrunde liegenden Aktivität. Das Delta der operativen Marge von DE (Abschnitt 6.2) wird als Zahl und nicht als Strich ausgewiesen, da sich seine 10-K-Kennzeichnung in beiden verglichenen Jahren eindeutig auflösen ließ.
- Ein Strich in den Kapitalverwendungs-Tabellen bezeichnet keine getaggte Aktivität für diese Zeile in diesem Berichtsjahr, keine imputierte Null; beide werden in diesem Beitrag durchgängig auseinandergehalten, und wir warnen davor, sie anderswo austauschbar zu lesen.
- Das Panel umfasst zehn Paare und zwanzig Unternehmen, ausgewählt, um alle vier strukturellen Flags und einen Querschnitt aus acht Sektoren abzudecken – es ist ein strukturiertes, nach Flags ausbalanciertes Fallserien-Design und keine zufällige oder statistisch repräsentative Stichprobe des gesamten nicht-finanziellen Universums, und die deskriptiven Häufigkeiten in diesem Beitrag sind entsprechend zu lesen und nicht als Schätzungen für die Grundgesamtheit.
- Das Vorperioden-Delta des Umsatzwachstums von RIVN (Abschnitt 6.2) ist ein Artefakt einer ungewöhnlich kleinen Vorperioden-Basis und sollte nicht als eigenständiges Wachstumssignal gelesen werden; wir leiten die Interpretation von RIVN aus diesem Grund bewusst über das Kapitalverwendungs-Ledger in Abschnitt 6.4 und nicht über die Delta-Tabelle.
- Das Fenster der dreijährigen Kapitalverwendung ist konstruktionsbedingt auf die drei jüngsten 10-K-Berichte festgelegt und reicht nicht weiter zurück; ein längeres Fenster würde für einige Unternehmen (insbesondere für den kapitalintensiven Ausbau erneuerbarer Energien bei NEE) einen vollständigeren Ausschüttungszyklus zeigen, als dieses Fenster allein es kann.
- Finanzwerte und Immobilien sind konstruktionsbedingt ausgeschlossen (Abschnitt 5); nichts in diesem Beitrag ist ohne gesonderte Behandlung ihrer abweichenden Verschuldungs- und Ausschüttungskonventionen auf einen der beiden Sektoren auszudehnen.
- Abschnitt 6.5 ist ausdrücklich deskriptiv und auf ein einziges Paar und ein einziges Beobachtungsfenster beschränkt; er ist keine Aussage zum Markt-Timing und wird nicht auf die anderen neun Paare dieses Panels ausgedehnt.
- Keine der Diagnosen in diesem Beitrag – Flags, Deltas, Kartenposition oder Kapitalverwendung – ist an nachfolgenden Aktienrenditen kalibriert oder hat sich als prädiktiv für diese erwiesen. Dieser Beitrag beschreibt die interne Stimmigkeit der eigenen ausgewiesenen Zahlen eines Unternehmens gegenüber seinem Peer und gegenüber seiner eigenen vorherigen Einreichung; er prüft nicht, ob diese Stimmigkeit oder ihr Fehlen im Kurs eingepreist ist.
9. Schlussfolgerung
Ein paarweiser Score beantwortet, wer stärker ist. Er beantwortet für sich genommen nicht, ob diese Stärke strukturell sauber ist, ob sie sich verbessert, wie sie sich gegenüber einer breiteren Peer-Gruppe darstellt oder wohin der Cash dahinter tatsächlich geflossen ist. Dieser Beitrag hat vier Diagnosen kombiniert – strukturelle Flags, jährliche Vorperioden-Deltas, die unmittelbar aus aufeinanderfolgenden 10-K-Berichten berechnet wurden, eine Sektor-Positionierungskarte aus derselben Faktorfamilie und ein dreijähriges Kapitalverwendungs-Ledger – und zwar über zehn sektorübergreifende, nicht-finanzielle Peer-Paare, und festgestellt, dass jede Diagnose tatsächlich Informationen liefert, die die anderen nicht tragen. Ein Papiergewinn-Flag kann auf der gewinnenden Seite eines Duells fortbestehen und sich sogar weiten (KO), statt eine verlierende anzuzeigen. Ein identisches Flag für nicht positives Eigenkapital und ein identischer Gleichstand im Score können auf zwei entgegengesetzten Entwicklungen gegenüber dem Vorjahr (MCD verbessert sich, SBUX verschlechtert sich) und zwei verschiedenen Kapitalverwendungspfaden ruhen. Eine Faktortabelle für eine einzelne Periode kann durchweg alarmierend wirken bei einem Unternehmen, dessen dreijähriges Kapitalverwendungs-Ledger eine finanzierte, finanzierbare Runway statt einer unmittelbaren Krise zeigt (RIVN). Nichts davon ersetzt den einzelnen relativen Score, den ein Leser beim Vergleich zweier Unternehmen letztlich will – es ist der Kontext, der dem Leser sagt, wie viel Gewicht dieser Score und der Trend dahinter tragen sollten.
Literaturverzeichnis
Sloan, R. G. (1996). Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings? The Accounting Review, 71(3), 289–315.
Dechow, P., Ge, W., & Schrand, C. (2010). Understanding Earnings Quality: A Review of the Proxies, Their Determinants and Their Consequences. Journal of Accounting and Economics, 50(2–3), 344–401.
Ohlson, J. A. (1995). Earnings, Book Values, and Dividends in Equity Valuation. Contemporary Accounting Research, 11(2), 661–687.
Penman, S. H. (2013). Financial Statement Analysis and Security Valuation (5th ed.). McGraw-Hill.
Lev, B., & Nissim, D. (2006). The Persistence of the Accrual Anomaly. Contemporary Accounting Research, 23(1), 193–226.
Richardson, S. A., Sloan, R. G., Soliman, M. T., & Tuna, I. (2005). Accrual Reliability, Earnings Persistence and Stock Prices. Journal of Accounting and Economics, 39(3), 437–485.
Grullon, G., & Michaely, R. (2002). Dividends, Share Repurchases, and the Substitution Hypothesis. The Journal of Finance, 57(4), 1649–1684.
Grullon, G., & Michaely, R. (2004). The Information Content of Share Repurchase Programs. The Journal of Finance, 59(2), 651–680.
Almeida, H., Campello, M., & Weisbach, M. S. (2004). The Cash Flow Sensitivity of Cash. The Journal of Finance, 59(4), 1777–1804.
DUEL-Methodik: duelstocks.com/methodology
DuelStocks, „From Winner-Take-All to Soft Relative Scores“ und „How Many Independent Signals? A Principal Component Analysis of an 8-Factor Stock Model“ (begleitende Methodennotizen auf dieser Website).
Anhang A: Dreijährige Kapitalverwendung, gesamtes Panel (Mrd. USD)
| Ticker | Geschäftsjahre | FCF (FY−2 / FY−1 / aktuell) | Dividenden | Rückkäufe | M&A | Aktienausgabe | Δ Nettoverschuldung (FY−1 / aktuell) | Barmittelbestand (FY−2 / FY−1 / aktuell) |
|---|---|---|---|---|---|---|---|---|
| MCD | 2023/24/25 | 7.25 / 6.67 / 7.19 | −4.53 / −4.87 / −5.12 | −3.05 / −2.82 / −2.06 | — / — / — | — / — / — | −0.48 / +1.48 | 4.58 / 1.08 / 0.77 |
| SBUX | 2023/24/25 | 3.68 / 3.32 / 2.44 | −2.43 / −2.58 / −2.77 | −0.98 / −1.27 / 0 | 0 / 0 / −0.18 | 0.17 / 0.11 / 0.08 | +0.17 / +2.01 | 3.55 / 3.29 / 3.22 |
| KO | 2023/24/25 | 9.75 / 4.74 / 5.30 | −7.95 / −8.36 / −8.78 | −2.29 / −1.79 / −0.75 | — / — / — | 0.54 / 0.75 / 0.31 | +4.05 / +0.10 | 9.37 / 10.83 / 10.27 |
| PEP | 2023/24/25 | 7.92 / 7.19 / 7.67 | −6.68 / −7.23 / −7.64 | −1.00 / −1.00 / −1.00 | −0.31 / −0.26 / −3.39 | — / — / — | −0.29 / +5.12 | 9.71 / 8.51 / 9.16 |
| AAPL | 2023/24/25 | 99.58 / 108.81 / 98.77 | −15.03 / −15.23 / −15.42 | −77.55 / −94.95 / −90.71 | — / — / — | — / — / — | −7.35 / −4.55 | 29.96 / 29.94 / 35.93 |
| MSFT | 2024/25/26 | 74.07 / 71.61 / 66.99 | −6.17 / −6.76 / −26.45 | −17.25 / −18.42 / −22.27 | — / — / — | 2.00 / 2.06 / 2.01 | −1.04 / +3.37 | 18.32 / 30.24 / 20.93 |
| GOOGL | 2023/24/25 | 69.50 / 72.76 / 73.27 | 0 / −7.36 / −10.05 | −61.50 / −62.22 / −45.71 | — / — / — | — / — / — | −2.86 / +38.08 | 24.05 / 23.47 / 30.71 |
| META | 2023/24/25 | 43.85 / 54.07 / 46.11 | 0 / −1.27 / −1.33 | −19.77 / −30.12 / −26.25 | — / — / — | — / — / — | +10.44 / +29.92 | 41.86 / 43.89 / 35.87 |
| TSLA | 2023/24/25 | 4.36 / 3.58 / 6.22 | — / — / — | — / — / — | −0.06 / 0 / 0 | — / — / — | +2.85 / +1.05 | 16.40 / 16.14 / 16.51 |
| RIVN | 2023/24/25 | −5.89 / −2.86 / −2.49 | — / — / — | — / — / — | — / — / — | 0.06 / 0.06 / 0.75 | +0.01 / 0.00 | 7.86 / 5.29 / 3.58 |
| CAT | 2023/24/25 | 11.29 / 10.05 / 8.92 | −2.56 / −2.65 / −2.75 | −4.97 / −7.70 / −5.19 | −0.07 / −0.03 / −0.05 | 0.01 / 0.02 / 0.02 | +2.63 / +4.47 | 6.98 / 6.89 / 9.98 |
| DE | 2023/24/25 | 7.09 / 7.59 / 6.10 | −1.43 / −1.60 / −1.72 | −7.22 / −4.01 / −1.14 | −0.08 / — / −0.10 | — / — / — | n/a / n/a | 7.46 / 7.32 / 8.28 |
| XOM | 2023/24/25 | 33.45 / 30.72 / 23.61 | −14.94 / −16.70 / −17.23 | −17.75 / −19.63 / −20.27 | — / — / — | — / — / — | +0.15 / −1.21 | 31.54 / 23.03 / 10.68 |
| CVX | 2023/24/25 | 19.78 / 15.04 / 16.59 | −11.34 / −11.80 / −12.75 | −14.94 / −15.23 / −12.08 | −0.06 / 0 / −1.06 | — / — / — | +3.71 / +16.22 | 8.18 / 8.26 / 7.29 |
| AMZN | 2023/24/25 | 32.22 / 32.88 / 7.70 | — / — / — | 0 / 0 / — | — / — / — | — / — / — | −9.18 / +11.14 | 73.39 / 78.78 / 86.81 |
| WMT | 2024/25/26 | 15.12 / 12.66 / 14.92 | −6.14 / −6.69 / −7.51 | −2.78 / −4.49 / −8.09 | −0.01 / −1.90 / −0.05 | 0.72 / 0.36 / 0.11 | −1.39 / +5.70 | 9.87 / 9.04 / 10.73 |
| JNJ | 2023/24/25 | 18.25 / 19.84 / 19.70 | −11.77 / −11.82 / −12.38 | −5.05 / −2.43 / −5.95 | 0 / −15.15 / −17.54 | — / — / — | +7.58 / +11.55 | 21.86 / 24.11 / 19.71 |
| PFE | 2023/24/25 | 4.79 / 9.84 / 9.07 | −9.25 / −9.51 / −9.77 | 0 / 0 / — | −43.43 / 0 / −6.93 | — / — / — | −2.64 / +3.49 | 2.85 / 1.04 / 1.14 |
| NEE | 2023/24/25 | 11.30 / 13.26 / 12.48 | −3.78 / −4.24 / −4.68 | — / — / — | — / — / — | 4.51 / 0.05 / 2.04 | +12.14 / +12.61 | 2.69 / 1.49 / 2.81 |
| SO | 2023/24/25 | −1.54 / 0.83 / −2.94 | −3.04 / −2.95 / −3.02 | — / — / — | 0 / 0 / −0.64 | 0.04 / 0.14 / 1.62 | +0.58 / +6.26 | 0.75 / 1.07 / 1.64 |
Anhang B: Flag-Definitionen (Übersetzung der Originaltexte im Tool)
- Papiergewinne (Paper profits): Op. Cash Margin < Operating Margin × 0.7
- Nicht positives Eigenkapital (Non-positive equity): Buchwert des Eigenkapitals ≤ 0 – Debt/Equity wird nicht berechnet (oft hohe Rückkäufe oder aufgelaufener Verlust); das Verschuldungssignal ist keine normale Kennzahl
- Investitionssog (CapEx vacuum): FCF Margin < Op. Cash Margin × 0.3
- Kein Sicherheitspolster (No safety cushion): FCF Margin < 0 und Debt/Equity > 1.5
Deskriptive Peer-Diagnostik auf Basis öffentlicher SEC-Einreichungen. Keine Anlageberatung. Alle Zahlen stammen aus den SEC-EDGAR-Company-Facts über duelstocks.com; vor jeder Verwendung einzelner Zahlen sind die aktuellen Werte im Live-Tool und in den Primärdokumenten zu überprüfen.
Ein Essay über Messmethodik, keine Aktienempfehlung. Keine Anlageberatung.
Zwei Geschäftsberichte liegen nebeneinander. Unternehmen A: ROIC 22 %, operative Marge 30 %. Unternehmen B: ROIC 15 %, operative Marge 25 %. Auf dem Papier wirkt A wie der klare Gewinner — ein Screener würde es höher einstufen, eine Excel-Sortierung würde es nach oben setzen, und die meisten Anleger würden hier aufhören.
Aber ein ROIC von 22 % in einem kapitalleichten Softwareunternehmen und ein ROIC von 15 % in einem Industriebetrieb mit anderer Vermögensbasis, anderem Working-Capital-Zyklus und anderer Wettbewerbsstruktur sind nicht dasselbe ökonomische Objekt, auch wenn es dieselben zwei Ziffern sind. Die Zahl, die für eine Entscheidung tatsächlich zählt — soll ich A statt B halten — steht auf keiner der beiden Seiten allein. Sie steckt in der Differenz zwischen beiden, sobald das Rauschen entfernt wird, das beide Unternehmen gemeinsam haben. Ingenieure haben genau dieses Problem schon vor langer Zeit gelöst, in einem Feld, das mit Finanzen nichts zu tun hat.
Was ein 30.000-Dollar-Empfänger Vermessungsingenieuren über Rauschen beibrachte
Ein einzelner GPS-Empfänger, ob Smartphone-Qualität oder professionell, bestimmt die Position durch Zeitmessung von Signalen aus Satelliten, die zehntausende Kilometer entfernt sind. Selbst bei klarem Himmel liegt diese Position typischerweise nur zwischen 3 und 10 Metern genau. Die Atmosphäre verbiegt das Signal unvorhersehbar, Satellitenuhren driften um Nanosekunden, die sich in Meter übersetzen, und die Orbitalposition ist nie perfekt bekannt. Nichts davon ist Rauschen, das nur den eigenen Empfänger betrifft — es ist ein gemeinsamer Bias, den jeder Empfänger in derselben groben Region zur selben Zeit erlebt.
Vermessungsingenieure bekämpfen diesen Bias nicht direkt. Sie heben ihn auf. Ein zweiter Empfänger — eine feste Basisstation an bekanntem Ort — misst denselben gemeinsamen atmosphärischen und orbitalen Fehler zur selben Zeit. Zieht man die Messung der Basisstation von der des Rovers ab, fällt der gemeinsame Teil des Fehlers aus der Differenz beinahe vollständig heraus. Was bleibt, wird von der kurzen Basislinie zwischen den beiden Empfängern dominiert, nicht vom langen, verrauschten Weg zum Satelliten. Diese Technik, Real-Time-Kinematic-Positionierung (RTK) genannt, bringt die Genauigkeit routinemäßig von mehreren Metern auf etwa einen Zentimeter (Hofmann-Wellenhof, Lichtenegger & Wasle, 2008). An den Satelliten hat sich nichts geändert. Geändert hat sich die Messung — von einer absoluten Position zu einer relativen.
| Modus | Was gemessen wird | Typische Genauigkeit | Finanzielles Gegenstück |
|---|---|---|---|
| Absolutes GNSS (einzelner Empfänger) | Position in einem globalen Referenzrahmen | 3 bis 10 Meter | Eine isolierte Kennzahl: ROIC, Marge, Wachstum, für sich allein gelesen |
| Relativ (RTK: Basis plus Rover) | Vektor zwischen zwei bekannten Stationen | Etwa 1 Zentimeter | Ein Faktor-für-Faktor-Kontrast zwischen zwei Unternehmen |
Die Analogie ist eine Struktur, kein Beweis. Märkte sind keine Satellitenkonstellation, Meldungen sind keine kontinuierlichen Signale, und ein schlecht gewähltes Vergleichspaar — zwei Unternehmen ohne Gemeinsamkeiten — ist wie eine relative Fixierung ohne gemeinsame Himmelssicht zwischen den Empfängern. Der Punkt ist enger und nützlicher als die Metapher: Wann immer zwei Messungen eine gemeinsame Fehlerquelle teilen, hebt der Vergleich beider miteinander mehr von diesem Fehler auf, als jede Messung für sich allein könnte. Das ist keine finanzielle Meinung. Es ist dieselbe arithmetische Tatsache, die aus 10-Meter-GPS 1-Zentimeter-RTK macht.
Wofür eine absolute Zahl tatsächlich gut ist
Absolute Kennzahlen sind nicht falsch. Sie beantworten eine reale Frage: Wie groß ist diese Zahl, für dieses Unternehmen, gerade jetzt. Genau das braucht man für eine Handvoll Aufgaben:
- Ein großes Universum auf eine Shortlist filtern („ROIC über den Kapitalkosten").
- Die eigene Entwicklung eines Unternehmens über die Zeit verfolgen.
- Ein Discounted-Cashflow- oder Kreditmodell für einen Einzeltitel füttern, wo man ein Niveau braucht, keinen Rang.
- Regulatorische, Covenant- oder Compliance-Schwellenwerte, die absolut definiert sind.
Wo einer absoluten Zahl der Weg ausgeht, ist genau die Frage, die die Aufmerksamkeit eines Anlegers tatsächlich beansprucht, sobald die Shortlist steht: Von zwei Titeln, die ich zu halten bereit bin — welcher ist stärker, und um wie viel? Eine sortierte Spalte beantwortet das nicht. Sie versagt zudem auf drei spezifische, gemeinsame Arten:
Sektorweite Aufblähung. Wenn jedes Unternehmen eines Sektors seine Marge um 300 Basispunkte ausweitet, weil ein gemeinsamer Preiszyklus dahintersteckt, leuchtet ein absolutes Dashboard über die gesamte Breite grün auf. Die Unternehmen sind nicht relativ zueinander besser geworden — der gesamte Referenzrahmen hat sich verschoben, genau wie eine Satellitenkonstellation, die gemeinsam driftet.
Skalen- und Strukturfallen. Ein sehr hoher ROIC kann ein wirklich effizientes Geschäft widerspiegeln, oder eine geschrumpfte Eigenkapitalbasis nach Jahren von Aktienrückkäufen, oder ein kapitalleichtes Modell, das schlicht weniger Vermögenswerte in der Bilanz führt. Die Zahl allein sagt nicht, welches davon zutrifft.
Mehrfaktor-Konflikt. Reale Paare stimmen selten in allem überein. Ein Unternehmen gewinnt bei Wachstum und Cash-Konversion, das andere bei Kapitalumschlag und Bilanzdisziplin. Ein absoluter Screener löst diesen Konflikt nicht auf — er zeigt lediglich zwei separate grüne Häkchen und überlässt die Abwägung dem Nutzer.
Der arithmetische Kern
Betrachten Sie jede beobachtete Fundamentalkennzahl für Unternehmen i als Summe dreier Bestandteile:
x_i = q_i + s + e_i
q_i ist die wahre, unternehmensspezifische Qualität auf dieser Dimension. s ist ein gemeinsamer Schock, den beide verglichenen Unternehmen teilen — ein Sektor-Margenzyklus, ein Zinsumfeld, eine branchenweite Bilanzierungsmode, eine vorübergehende Multiple-Expansion über die gesamte Peer-Gruppe. e_i ist idiosynkratisches Rauschen, spezifisch für die Meldung dieses einen Unternehmens.
Ein absoluter Screen betrachtet x_A allein, sodass s unbemerkt in der Zahl mitfährt. Ein Paarvergleich betrachtet stattdessen die Differenz:
x_A minus x_B = (q_A minus q_B) + (e_A minus e_B)
Der gemeinsame Term s ist verschwunden. Nicht geschätzt, nicht angepasst — verschwunden, durch dieselbe Subtraktion, die aus zwei verrauschten GPS-Fixierungen einen präzisen Vektor macht. Diese eine Zeile ist das tragende Argument dieses gesamten Beitrags. Alles Weitere ist Anwendung und ehrliche Einschränkung.
Für einen funktionierenden Vergleich muss die Differenz in einer Formel nutzbar sein, nicht nur als Vorzeichen. Definieren Sie für zwei Rohwerte a und b auf einem Faktor (das Vorzeichen zuerst umgedreht bei jeder Kennzahl, bei der niedriger besser ist, etwa einer Ergebnisqualitäts-Kennzahl):
t = (a' minus b') / (|a'| + |b'| + epsilon), wobei epsilon eine kleine positive Konstante ist
N_A = 0,5 + 0,5 mal t N_B = 0,5 minus 0,5 mal t
Ist a gleich b, landen beide Seiten exakt bei 0,5 — ein echtes Unentschieden. Ein enger Abstand erzeugt eine milde Neigung zu einer Seite. Ein weiter Abstand erzeugt eine starke Neigung. Die Größenordnung bleibt erhalten, statt in ein binäres Gewinnen oder Verlieren zu kollabieren. Ein gewichteter Mehrfaktor-Score ist dann eine Summe über die Faktoren, Score = 100 mal die Summe aus Gewicht_k mal N_k, normiert so, dass die Gewichte sich zu eins addieren. Das ist kein Bewertungsmodell und bepreist nichts. Es ist ein normiertes Turnier auf Basis offengelegter Fundamentaldaten — das finanzielle Gegenstück zum Basis-und-Rover-Vektor, kein Satellitenfoto eines der beiden Unternehmen allein.
Ein Live-Paar: Amazon gegen Walmart
Einzelhandel und E-Commerce werden oft genug in einen gedanklichen Topf geworfen, dass eine absolute Lesart eines der beiden Unternehmen einseitig wirken kann, je nachdem, welche Spalte man zuerst betrachtet. Das Acht-Faktoren-Panel unten ist keine illustrative Füllung — es sind dieselben echten, SEC-basierten Daten, die auch in den Duell- und Fragilitätsanalysen dieser Seite verwendet werden, aktuell zum selben Meldungs-Snapshot.
| Faktor | AMZN | WMT | Absoluter Vorteil |
|---|---|---|---|
| Umsatzwachstum (3J-CAGR) | 11,73 % | 5,27 % | AMZN |
| Operative Cashflow-Marge | 22,51 % | 5,83 % | AMZN |
| ROIC | 9,89 % | 16,74 % | WMT |
| Sloan Ratio (niedriger ist besser) | 17,40 % | -5,31 % | WMT |
| Asset Turnover | 0,65x | 2,43x | WMT |
| Receivables Turnover | 8,14x | 64,39x | WMT |
| Operative Marge | 11,16 % | 4,18 % | AMZN |
| FCF-Marge | 21,48 % | 2,09 % | AMZN |
Durch die oben beschriebene weiche Normalisierung mit Standardgewichten gerechnet, landet das Gesamtergebnis bei 51,2 zu 48,8 zugunsten von Amazon — ein knappes Unentschieden, kein Blowout in irgendeine Richtung.
Lesen Sie, was die zwei Hälften der Tabelle tatsächlich sagen, bevor Sie auf diese eine Zahl schauen. Der Kapitaleffizienz-Block — ROIC, Asset Turnover, Receivables Turnover — kürt klar und mit weitem Abstand Walmart; ein Receivables Turnover von 64,4x gegenüber Amazons 8,1x ist die größte Rohlücke im gesamten Panel, echte Information darüber, wie ein Filialnetz sein Working Capital umschlägt. Der Cash-Konversions- und Wachstumsblock — operative Cashflow-Marge, operative Marge, FCF-Marge, Umsatzwachstum — kürt ebenso klar Amazon. Beide Hälften sind wahr. Keine der absoluten Spalten lügt. Was eine Winner-take-all-Lesart einer der beiden Hälften allein bewirken würde, ist ein Debakel zu konstruieren, das das Gesamtbild in keine Richtung stützt — und was das knappe Unentschieden im Gesamtergebnis korrekterweise tut, ist sich zu weigern, vorzugeben, dass die echte Stärke des einen Unternehmens die echte Schwäche des anderen zu einem falschen Konsens auslöscht. Die Sloan Ratio fügt hier eine zweite, unabhängige Warnung hinzu: Amazons stärker accrual-lastiges Ertragsprofil ist ein legitimer Grund, den Cash-Konversions-Vorsprung auf den ersten Blick etwas geringer zu gewichten, kein Grund, ihn zu ignorieren.
Warum Anleger glauben, zwanzig Kennzahlen genutzt zu haben — und nur zwei genutzt haben
Es gibt einen zweiten, leiseren Fehlermodus unter der Absolut-versus-Relativ-Frage, und er erklärt, warum das Hinzufügen weiterer Spalten zu einem Screener das Problem nicht so löst, wie es sich anfühlt.
Nehmen Sie eine gut gebaute, professionelle Scoring-Plattform mit sagen wir 100-plus Indikatoren, verteilt auf fünf oder sechs benannte Kategorien: Profitabilität, finanzielle Stärke, Wachstum, Bewertung, Momentum. Das sieht aus wie fünf oder sechs unabhängige Meinungen über ein Unternehmen. Meist ist es das nicht. Innerhalb eines einzelnen Profitabilitätsblocks neigen operative Marge, Nettomarge, ROE, ROA und ROIC dazu, sich für ein Unternehmen über die Zeit und über die meisten Peers hinweg gemeinsam zu bewegen, weil es unterschiedliche arithmetische Ansichten desselben zugrunde liegenden Cash-Generierungsmotors sind — ein Muster, das in der Literatur zur Faktorenanalyse von Finanzkennzahlen seit Jahrzehnten dokumentiert ist (Pinches, Mingo & Caruthers, 1973; Chen & Shimerda, 1981). Vier Preismultiplikatoren — KGV, KUV, EV/FCF, EV/EBITDA — sind vier verschiedene Nenner für Variationen desselben Zählers: den aktuellen Marktpreis. Alle vier „übereinstimmen" zu sehen, sind nicht vier unabhängige Bestätigungen. Es ist eine Meinung, viermal gezählt, das finanzielle Gegenstück dazu, drei Ärzte zu befragen, die alle aus demselben Lehrbuch gelernt haben und alle auf dasselbe Röntgenbild schauen.
Auch das eigene Acht-Faktoren-Panel dieser Seite ist von dieser Prüfung nicht ausgenommen, und es wurde getestet statt angenommen: Eine Hauptkomponentenanalyse derselben acht SEC-basierten Kennzahlen (siehe Wie Viele Unabhängige Signale? Eine Hauptkomponentenanalyse Eines 8-Faktor-Modells) ergab, dass sie auf vier empirisch unterscheidbare Komponenten zusammenfallen — Cash-Konversion, Kapitaleffizienz, Wachstum und Accrual-Qualität —, wobei ein sauberes, fast alleinstehendes Signal (die Sloan Ratio) als Außenseiter fungiert, gerade weil es etwas misst, das die anderen sieben nicht messen: ob Erträge durch Cash gedeckt oder durch bilanzielle Entscheidungen erzeugt sind. Ein schwereres Board mit Dutzenden Kennzahlen komprimiert nach derselben Logik plausibel auf eine ähnlich kleine Handvoll latenter Faktoren, plus mindestens eine zusätzliche Ebene, die ein reines SEC-Fundamentaldaten-Panel gar nicht berührt — den aktuellen Marktpreis und sein Momentum, das mathematisch unabhängig von jeder Bilanzkennzahl ist, weil es von vornherein nicht aus Bilanzdaten abgeleitet ist. Ob das vollständige Kennzahlenset einer bestimmten Plattform auf vier, fünf oder sechs Faktoren zusammenfällt, ist eine empirische Frage über die Korrelationsmatrix dieser Plattform selbst, nichts, was dieser Essay von außen zertifizieren kann — die ehrliche Behauptung ist enger und erfüllt trotzdem ihren Zweck: Die Anzahl der Kategorien, die eine Oberfläche zeigt, ist eine Taxonomie, kein Ergebnis einer Faktorenanalyse, und beides sind routinemäßig unterschiedliche Zahlen.
Die menschlichen Kosten dieser Lücke sind die eigentliche Geschichte. Konfrontiert mit zwanzig oder hundert gleichzeitigen Messwerten, hält fast kein Anleger — auch ein sehr fähiger nicht — die vollständige Matrix im Arbeitsgedächtnis im Moment der Entscheidung. Was stattdessen zuverlässig passiert, ist eine stille Substitution: Ein breiter Screen wird überflogen, das meiste davon wird verworfen, ohne dass jemand bewusst entscheidet, es zu verwerfen, und die eigentliche Entscheidung wird auf ein oder zwei vertrauten Achsen getroffen — meist Wachstum, oder wie tief der Preis gefallen ist —, während der Anleger sich erinnert, „die vollständige Analyse gemacht" zu haben. Zwanzig Messwerte gehen hinein. Eine auf zwei Werten basierende Entscheidung kommt heraus. Die anderen achtzehn lieferten ein Gefühl von Sorgfalt, keine zusätzliche Information.
Ein paarweiser, faktorreduzierter Vergleich löst das nicht durch mehr Daten. Er löst es, indem er es korrelierten Spalten verwehrt, sich als unabhängige Stimmen auszugeben, und indem er Meinungsverschiedenheiten zwischen der Handvoll wirklich unabhängiger Signale unmöglich zu überscrollen macht. Im Amazon-gegen-Walmart-Panel oben ist der Konflikt nicht in Zeile vierzig einer Tabelle vergraben — er ist die gesamte Struktur der Tabelle: Kapitaleffizienz sagt das eine, Cash-Konversion und Wachstum sagen das andere, und das knappe Unentschieden im Gesamtergebnis ist die ehrliche Arithmetik dieser Meinungsverschiedenheit, kein Durchschnitt, der sie verbirgt. Das ist der zweite, eigenständige Vorteil gegenüber einem größeren Board, getrennt von und zusätzlich zum Common-Mode-Rausch-Argument oben: Rauschaufhebung macht den Vergleich ehrlich; Faktorreduktion macht ihn klein genug, dass ein Mensch ihn beim Entscheiden tatsächlich im Kopf behalten kann.
Was das einem Anleger tatsächlich bringt
Nichts davon erfordert, absolute Zahlen wegzuwerfen. Es erfordert, bei ihnen nicht stehenzubleiben, wenn die aktuelle Frage A-gegen-B lautet. Konkret liefert ein relativer, faktorreduzierter Vergleich:
- Eine Entscheidungsvariable, die zur Entscheidung passt. Rang auf angegebenen Faktoren zwischen den beiden Kandidaten, kein globaler Score losgelöst von der tatsächlichen Alternative auf dem Tisch.
- Teilweise Immunität gegen gemeinsame Schocks. Sektorweite Margenausweitung, eine gemeinsame Zinsbewegung, eine branchenweite Bilanzierungsmode — all das hebt sich in derselben Differenz auf, die atmosphärische Verzögerung bei RTK aufhebt.
- Explizite statt versteckte Trade-offs. Wenn Wachstum und Cash-Konversion mit Kapitalumschlag und Verschuldung nicht übereinstimmen, zeigt der Vergleich die Meinungsverschiedenheit, statt sie zu einer einzigen, irreführend glatten Zahl zu mitteln.
- Eine kleine, verteidigbare Achsenmenge statt hundert korrelierter. Vier unabhängige Signale, nicht vierzig Neuformulierungen derselben vier.
- Auditierbarkeit. Jeder Input lässt sich auf eine spezifische SEC-Meldung und eine veröffentlichte Normalisierungsregel zurückführen, nicht auf eine undurchsichtige proprietäre Mischung.
Wo DUEL einsteigt
DUEL (duelstocks.com) ist eine operative Umsetzung von allem oben Beschriebenen, nicht das Argument selbst. Es baut die relative Ebene aus acht SEC-basierten Faktoren auf, wendet dieselbe weiche Normalisierung auf beide Namen eines Paares an, legt die Gewichte offen statt sie hinter einer Blackbox zu verstecken, und erlaubt es einem Nutzer, in Richtung Wachstum, Qualität, Wert oder Ertrag umzugewichten, ohne von Hand neu zu rechnen. Die Sektor-Positionierungskarten auf derselben Seite treiben dieselbe faktorreduzierte Logik einen Schritt weiter und platzieren eine gesamte Peer-Gruppe auf zwei Achsen, die aus derselben Vier-Komponenten-Struktur gebaut sind, statt aus rohen, korrelierten Kennzahlen. Nichts davon ist die Behauptung, dass irgendein einzelnes Tool die hier beschriebene Methode erschöpft — es ist die Identifikationslogik, Common-Mode-Aufhebung plus Faktorreduktion plus expliziter Paarvergleich, die die Arbeit leistet. Ein anderes Tool, gebaut auf denselben drei Prinzipien, würde dasselbe Argument verdienen.
Einwände
„Ich brauche einen absoluten ROIC für mein DCF." Ja — ein Niveau speist ein Einzeltitel-Bewertungsmodell oder eine Kreditsicht. Relativer Vergleich speist Auswahl und Rangierung unter Kandidaten. Es sind verschiedene Werkzeuge für verschiedene Schritte desselben Prozesses, keine Konkurrenten.
„Wenn alles relativ ist, gibt es keinen Anker." Der Anker ist der explizite Peer, oder die explizite alternative Kapitalverwendung. RTK-Positionierung sitzt immer noch auf einem echten geodätischen Kontrollnetz — relative Messung verbessert die Präzision zwischen zwei Punkten, sie leugnet nicht, dass jeder Punkt einen Ort hat.
„Ich kann einfach eine Tabelle nach ROIC sortieren." Das Sortieren einer Spalte ist ein einfaktorieller absoluter Rang. Es hebt keine Common-Mode-Schocks auf, gewichtet keine mehreren Faktoren, und sagt nicht, ob die Nachbarspalten unabhängige Bestätigungen sind oder dasselbe Signal viermal gezählt.
„Zwei Unternehmen zu vergleichen ist willkürlich — warum genau diese zwei?" Das ist die Definition jedes Universums für einen absoluten Screen auch. Die Disziplin besteht darin, ein ökonomisch vergleichbares Paar oder eine Peer-Gruppe zu wählen und die Gewichte offen zu benennen, statt vorzugeben, dass eine globale absolute Skala neutral sei, obwohl sie genauso viele implizite Entscheidungen trägt.
Limitationen
- Ein relativer Score ist keine Renditeprognose. Nichts in diesem Beitrag behauptet, dass die stärkere Seite eines Paarvergleichs künftig outperformen wird.
- Ein schlecht gewähltes Paar — zwei Unternehmen ohne echte ökonomische Überschneidung — erzeugt eine präzise wirkende Zahl, die auf Rauschen aufbaut, das finanzielle Gegenstück einer RTK-Fixierung ohne gemeinsame Satellitensicht.
- Bilanzielle Identität ist nicht ökonomische Identität. Sloan Ratio und Cash-Margen-Faktoren reduzieren, eliminieren aber nicht das Ergebnisqualitätsrisiko.
- Relativer Vergleich ersetzt nicht Positionsgrößen, Liquiditätsbeurteilung, gezahlten Preis oder qualitative Due Diligence.
- Jede Faktorreduktions-Behauptung, einschließlich des oben zitierten Vier-Komponenten-Ergebnisses, ist spezifisch für das Kennzahlenset und den Zeitraum, auf dem sie gemessen wurde. Dieselbe Logik auf eine andere Plattform anzuwenden, erfordert denselben Test auf deren eigenen Daten, nicht die Annahme, dieselbe Zahl übertrage sich.
- Standardgewichte stellen einen vernünftigen Expertenprior dar, kein zurückgetestetes Optimum; die eigenen Begleitbeiträge von DUEL auf dieser Seite machen explizit, dass die Kalibrierungsfrage — welche Gewichte künftige Renditen am besten vorhersagen — offen bleibt.
Fazit
Eine absolute Kennzahl misst ein Niveau innerhalb eines gemeinsamen, verrauschten Referenzrahmens. Ein relativer Paarvergleich misst einen Kontrast, bei dem sich der gemeinsame Teil dieses Rauschens konstruktionsbedingt aufhebt — dieselbe Arithmetik, die aus einer schwankenden 10-Meter-GPS-Fixierung einen stabilen 1-Zentimeter-RTK-Vektor macht. Ein breites Scoring-Board fügt die weitere Illusion hinzu, mehr Spalten bedeuteten mehr Information, wenn die meisten dieser Spalten Neuformulierungen einer kleinen Zahl unabhängiger Signale sind, und die eigene Aufmerksamkeit des Anlegers das gesamte Board im Moment der Entscheidung ohnehin still auf ein oder zwei vertraute Achsen zusammenfaltet.
Die Lösung ist nicht mehr Daten. Es ist eine kleinere Zahl unabhängiger Signale, direkt verglichen, wobei die Meinungsverschiedenheit zwischen ihnen sichtbar bleibt statt weggemittelt zu werden. Für den Anleger ist das intellektuelle Hygiene, keine neue Erkenntnis: Wenn die aktuelle Frage Amazon gegen Walmart lautet, oder jede andere Shortlist von zwei Titeln, rangieren Sie die Differenz auf den Faktoren, die sich tatsächlich unabhängig voneinander bewegen — bewundern Sie nicht einfach, welcher Name die höhere absolute Hürde bei der einen Kennzahl nimmt, die Sie zufällig zuerst betrachtet haben.
Quellen
Hofmann-Wellenhof, B., Lichtenegger, H., & Wasle, E. (2008). GNSS – Global Navigation Satellite Systems: GPS, GLONASS, Galileo, and More. Springer.
Pinches, G. E., Mingo, K. A., & Caruthers, J. K. (1973). The Stability of Financial Patterns in Industrial Organizations. The Journal of Finance, 28(2), 389–396.
Chen, K. H., & Shimerda, T. A. (1981). An Empirical Analysis of Useful Financial Ratios. Financial Management, 10(1), 51–60.
Sloan, R. G. (1996). Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings? The Accounting Review, 71(3), 289–315.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3. Aufl.). Wiley.
DUEL Methodology: duelstocks.com/methodology
DuelStocks, „Wie Viele Unabhängige Signale? Eine Hauptkomponentenanalyse Eines 8-Faktor-Modells Zur Relativen Aktienbewertung".
Nur zu Informations- und Bildungszwecken. Keine Anlageberatung. Vergangene Bilanzdaten garantieren keine zukünftigen Ergebnisse. Überprüfen Sie alle Zahlen anhand der primären SEC-Meldungen, bevor Sie eine Entscheidung treffen.
Methodische Tiefenanalyse, echte Zahlen aus echten Duellen, von Grund auf berechnet und verifiziert. Keine Anlageberatung.
Unser ursprünglicher Fragilitätsbeitrag analysierte DUEL unter der Winner-take-all-Regel pro Kennzahl: Für jede der acht SEC-basierten Kennzahlen erhielt der bessere Titel das gesamte Gewicht dieser Kennzahl, der schwächere nichts, und die Nähe eines Duells reduzierte sich auf eine einzige klare Zahl, Lücke ÷ 2. Seit jenem Beitrag hat sich der Live-Scoring-Operator von DUEL geändert. Die Seite verwendet jetzt weiche Relativscores: Jede Kennzahl wird nach der Größe der Lücke zwischen den beiden Unternehmen skaliert, nicht nur nach ihrem Vorzeichen. Diese Änderung komprimiert nicht nur Score-Abstände — sie verändert die mathematische Struktur des Scoring-Spiels selbst, weshalb die Fragilitätsfrage neu hergeleitet werden muss, nicht nur mit neuen Zahlen neu durchgerechnet. Dieser Beitrag nimmt dieselben acht Duelle aus der ursprünglichen Analyse, berechnet sie unter dem aktuellen Algorithmus neu und stellt dieselben drei Fragen erneut, auf denselben drei Rigor-Ebenen: Wie eng ist jedes Duell, stimmt zufällige Gewichtsstörung mit der Algebra überein, und entspricht das angegebene Gewicht einer Kennzahl tatsächlich ihrer entscheidenden Macht.
Ebene 1: Wie der Score jetzt funktioniert, und was Nähe bedeutet
Für jede Kennzahl fließen die Rohwerte beider Unternehmen in eine weiche Normalisierung ein: t = (a' − b') / (|a'| + |b'| + ε), danach N_a = 1/2 + 1/2·t und N_b = 1/2 − 1/2·t (ε ist eine kleine Konstante, die nur relevant wird, wenn beide Werte exakt null sind). Die Sloan Ratio wird vor diesem Schritt invertiert, da dort niedriger besser ist. Der Endscore ist Score = 100 × Σ (Gewicht × N) je Seite, mit denselben Standardgewichten wie zuvor — Umsatzwachstum 16 %, operative Cashflow-Marge 15 %, ROIC 15 %, Sloan Ratio 12 %, Asset Turnover 10 %, Receivables Turnover 8 %, operative Marge 12 %, FCF-Marge 12 %. Wir haben alle acht Scores aus den aktuellen SEC-EDGAR-Rohwerten Unternehmen für Unternehmen neu hergeleitet; jeder stimmte bis auf Rundung mit dem auf der Live-Site veröffentlichten Score überein.
| Duell | Score (aktuell) | Score unter der alten Winner-take-all-Regel, gleiche Daten |
|---|---|---|
| NVDA vs. AMD | 67–33 | 80–20 |
| GOOGL vs. META | 39–61 | 0–100 |
| AMZN vs. WMT | 51–49 | 55–45 |
| CRM vs. NOW | 54–46 | 59–41 |
| VRTX vs. REGN | 57–43 | 61–39 |
| GFF vs. WOR | 59–41 | 73–27 |
| BHE vs. PLAB | 34–66 | 30–70 |
| KO vs. PEP | 55–45 | 75–25 |
Die rechte Spalte ist nicht die Zahl, die unser ursprünglicher Beitrag im August veröffentlichte — jene Zahl nutzte Augusts SEC-Meldungen. Es ist ein Gegenfaktum mit gleichen Daten: Wir haben die heutigen Rohkennzahlwerte durch die abgeschaffte Winner-take-all-Regel laufen lassen, rein um die Wirkung des Operatorwechsels selbst zu isolieren, bei fixierten zugrunde liegenden Finanzdaten. Bei diesem kontrollierten Vergleich ist das Bild eindeutig: Der Sieger ist in allen acht Duellen identisch. Was sich ändert, ist die Größenordnung, nicht die Richtung. Der mittlere absolute Score-Abstand über dieses Acht-Duell-Panel sinkt von 43,3 Punkten unter der alten Regel auf 17,4 Punkte unter Soft Scoring (Median 43,0 auf 15,4) — grob halbiert, allein als Folge davon, dass keiner Kennzahl mehr ihr gesamtes Gewicht auf Basis eines schmalen, mitunter fast unmerklichen Vorsprungs zugesprochen wird.
Weil Soft Scoring eine gewichtete Summe statt eine Winner-take-all-Abstimmung ist, zerlegt sich die Marge zwischen zwei Unternehmen exakt, ohne dass eine Simulation nötig wäre: Marge (in Punkten) = 100 × Σ (Gewicht_k × t_k), und jeder Term ist der exakte Punktbeitrag dieser einzelnen Kennzahl. Zwei Duelle zeigen die Bandbreite:
AMZN vs. WMT (Marge +2,4 Punkte — das knappste Duell im Panel): Operative Cashflow-Marge trägt +8,8 Punkte und FCF-Marge +9,9 Punkte zugunsten von Amazon bei; die Sloan Ratio trägt volle −12,0 Punkte und Receivables Turnover −6,2 Punkte zugunsten von Walmart bei (Walmarts Receivables Turnover von 64,4x gegenüber Amazons 8,1x ist die größte Rohlücke im gesamten Panel). Die Endmarge ist der kleine Rest, der nach diesen großen, teils gegenläufigen Kennzahlbeiträgen übrig bleibt — genau deshalb ist dieses Duell fragil, und genau das verbirgt eine einzelne Abstandszahl.
GOOGL vs. META (Marge −22,4 Punkte): Jede der acht Kennzahlen begünstigt Meta, ausnahmslos. Das ist eine mathematisch andere Situation als etwa VRTX vs. REGN, wo Vertex bei fünf Kennzahlen führt und Regeneron bei drei, Vertex aber dennoch mit komfortablen +13,8 Punkten insgesamt gewinnt. Ein Duell, in dem eine Seite jede Kennzahl fegt, lässt sich durch keine Umverteilung nichtnegativer Gewichte umkippen, wie extrem auch immer — die Marge ist eine konvexe Kombination von acht Zahlen mit durchweg demselben Vorzeichen, also kann kein Gewichtungsschema, wie verzerrt auch immer, diese Kombination durch null drücken. Drei der acht Duelle in diesem Panel sind in diesem Sinn vollständige Sweeps: GOOGL vs. META, BHE vs. PLAB, und CRM vs. NOW ist es nicht (CRM führt bei fünf Kennzahlen, NOW bei drei, daher die unten untersuchte Möglichkeit eines Umkippens).
Ebene 2: Monte Carlo — stimmt der Zufall mit der Algebra überein?
Wie im ursprünglichen Beitrag führten wir 10.000 Simulationen pro Duell durch, wobei jedes der acht Gewichte unabhängig und gleichverteilt aus ±50 % seines Standardwerts gezogen und die Ziehung anschließend auf 100 % renormalisiert wurde. Weil Soft Scoring stetig ist, müssen wir die Rohkennzahl-Position keines Unternehmens für jede Ziehung neu herleiten — die acht t_k-Werte eines Duells liegen durch die SEC-Daten fest und hängen überhaupt nicht von den Gewichten ab; nur die gewichtete Summe tut es. Das ist selbst schon eine strukturelle Vereinfachung gegenüber dem alten Winner-take-all-Spiel, in dem der „Besitz" einer Kennzahl durch ein Unternehmen bereits feststand und sich nur das Gewicht bewegte, der Kipppunkt aber vom Schwellenwert abhing, nicht von einer stetigen Funktion.
| Duell | Marge | Kipprate (10.000 Ziehungen) |
|---|---|---|
| NVDA vs. AMD | +34,6 | 0,00 % |
| GOOGL vs. META | −22,4 | 0,00 % |
| AMZN vs. WMT | +2,4 | 36,02 % |
| CRM vs. NOW | +8,0 | 1,22 % |
| VRTX vs. REGN | +13,8 | 0,00 % |
| GFF vs. WOR | +17,0 | 0,12 % |
| BHE vs. PLAB | −31,5 | 0,00 % |
| KO vs. PEP | +9,3 | 0,00 % |
Sechs der acht Duelle kippen in 10.000 Ziehungen kein einziges Mal; die Algebra aus Ebene 1 hat uns bereits gesagt, dass drei dieser sechs unter keiner Umgewichtung überhaupt kippen können, und die übrigen drei haben schlicht Margen, die breit genug sind, dass ±50 %-Gewichtsrauschen sie selten erreicht. AMZN vs. WMT ist der klare Ausreißer und kippt in gut einem Drittel der Ziehungen — eine deutlich höhere Kipprate als die 14,8 %, die wir für dasselbe Paar unter dem alten Algorithmus gemessen haben. Das ist kein Widerspruch; es ist die ehrlichere Zahl. Unter Winner-take-all wirkte Amazons 55:45 wie ein komfortables Zehn-Punkte-Polster. Unter Soft Scoring erzeugen dieselben zugrunde liegenden Daten eine Marge von 51,2:48,8, weil Winner-take-all Amazon vollen Kredit für Kennzahlen gab, die es nur knapp gewann (Umsatzwachstum, operative Marge), während es Walmart für Kennzahlen, die es haushoch verlor (Receivables Turnover, Sloan Ratio), gar nichts gab — eine asymmetrische Kreditvergabe, die den scheinbaren Abstand in beide Richtungen aufblähte, bevor sie sich verrechneten. Soft Scoring entfernt diese Aufblähung, und was übrig bleibt, ist ein wirklich knappes Duell, was das Monte-Carlo-Ergebnis bestätigt.
Betrachtet man speziell, welche Kennzahl in den 3.602 Ziehungen, in denen AMZN vs. WMT kippte, typischerweise das größte zufällige Gewicht trug: ROIC trägt in 38,0 % der Kipp-Fälle das größte Gewicht, Umsatzwachstum in 27,3 %, operative Cashflow-Marge in 14,5 %. Das ist eine nützliche, konkrete Antwort darauf, welche Kennzahl hier tatsächlich entscheidet, getrennt von der Frage, wie oft ein Kippen überhaupt vorkommt. CRM vs. NOW kippt selten (1,22 %), aber wenn es kippt, ist Umsatzwachstum überwältigend die Kennzahl mit dem größten zufälligen Gewicht (88,5 % der Kipp-Fälle) — wenig überraschend, da ServiceNows 22,4-prozentiger Dreijahres-Umsatz-CAGR gegenüber Salesforces 9,8 % die mit Abstand größte Kennzahllücke ist, die gegen den Basis-Sieger dieses Duells arbeitet.
Ebene 3: Entspricht das angegebene Gewicht einer Kennzahl jetzt tatsächlich ihrer Macht?
Der strukturellste Befund des ursprünglichen Beitrags nutzte den Shapley-Shubik-Index, ein Werkzeug, das Lloyd Shapley und Martin Shubik 1954 entwickelten, um entscheidende Abstimmungsmacht in gewichteten Mehrheitsspielen zu messen — dieselbe Mathematik, die später zur Analyse der Abstimmungsmacht im EU-Ministerrat und im UN-Sicherheitsrat verwendet wurde. Unter Winner-take-all bildeten DUELs acht Kennzahlen genau diese Art von Spiel: acht „Wähler", jeder mit festem Gewicht, entscheiden per einfacher Mehrheit (über 50 %), welche Seite gewinnt. Wir fanden, dass angegebenes Gewicht und Shapley-Shubik-Macht systematisch auseinanderliefen — Receivables Turnovers veröffentlichtes Gewicht von 8,0 % trug nur 6,1 % der tatsächlichen entscheidenden Macht (ein Verhältnis von 0,76x), während Umsatzwachstums 16,0 % Gewicht 18,2 % der entscheidenden Macht trug (1,14x). Kleinere Gewichte waren strukturell weniger wert, als ihre Zahl nahelegte; größere Gewichte waren mehr wert. Diese Divergenz ist eine bekannte mathematische Eigenschaft von Mehrheitsschwellen-Spielen, kein Fehler, der spezifisch für dieses Tool ist — jedes Winner-take-all-pro-Kennzahl-System mit Mehrheitsschwelle erbt sie.
Soft Scoring entfernt die Schwelle vollständig. Es gibt keinen Punkt mehr, an dem eine Seite die 50 % überschreitet und alles nimmt; der Score ist schlicht Score = 100 × Σ (Gewicht_k × N_k), eine lineare Funktion der Gewichte. Das klassifiziert das zugrunde liegende Spiel neu. Ein gewichtetes Mehrheitsspiel ist das, was Spieltheoretiker ein wesentliches (essential) Spiel nennen — Koalitionen können mehr oder weniger wert sein als die Summe ihrer Teile, genau das macht Abstimmungsmacht-Indizes wie Shapley-Shubik und Banzhaf notwendig und nicht-trivial. Eine rein lineare, schwellenfreie Summe ist, was Spieltheoretiker ein unwesentliches (additives) Spiel nennen: Der Wert jeder Koalition von Kennzahlen ist exakt die Summe dessen, was jede Kennzahl für sich beiträgt, ganz ohne Interaktionseffekte zwischen den Kennzahlen. Shapleys ursprüngliches Wertkonzept von 1953 hat für diesen Fall ein direktes, bekanntes Korollar: In einem additiven Spiel entspricht der Shapley-Wert jedes Spielers exakt dem eigenen individuellen Beitrag dieses Spielers, aus dem einfachen Grund, dass das Hinzufügen von Kennzahl k zu jeder beliebigen Koalition — unabhängig davon, welche Kennzahlen bereits enthalten sind, unabhängig von der Reihenfolge — den Wert der Koalition jedes Mal um exakt Gewicht_k × t_k verändert. Wenn ein Grenzbeitrag über jede mögliche Koalition und jede mögliche Reihenfolge hinweg konstant ist, hat der Shapley-Wert (ein gewichteter Durchschnitt von Grenzbeiträgen über alle Reihenfolgen) nichts zu mitteln — er kollabiert auf diese Konstante.
Wir haben das numerisch überprüft, statt das Theorem nur zu zitieren. Für AMZN vs. WMT haben wir den Shapley-Wert jeder der acht Kennzahlen durch Brute-Force-Aufzählung aller 8! = 40.320 Reihenfolgen berechnet:
| Kennzahl | Exakter Punktbeitrag (100 × Gewicht × t) | Shapley-Wert, 40.320 Reihenfolgen | Differenz |
|---|---|---|---|
| Umsatzwachstum | +6,080 | +6,080 | unter 1e-11 |
| Operative Cashflow-Marge | +8,829 | +8,829 | unter 1e-11 |
| ROIC | −3,858 | −3,858 | unter 1e-11 |
| Sloan Ratio | −12,000 | −12,000 | unter 1e-11 |
| Asset Turnover | −5,779 | −5,779 | unter 1e-11 |
| Receivables Turnover | −6,204 | −6,204 | unter 1e-11 |
| Operative Marge | +5,460 | +5,460 | unter 1e-11 |
| FCF-Marge | +9,872 | +9,872 | unter 1e-11 |
Die beiden Spalten stimmen bis auf Gleitkommagenauigkeit überein, genau wie die Additivitätseigenschaft vorhersagt. Praktisch bedeutet das: Die Gewicht-versus-Macht-Lücke, die Ebene 3 des ursprünglichen Beitrags als strukturelle Eigenschaft von Winner-take-all identifizierte — kleinere Kennzahlen wie Receivables Turnover strukturell relativ zu ihrer angegebenen Wichtigkeit untergewichtet — existiert unter Soft Scoring für kein Duell, konstruktionsbedingt. Das veröffentlichte Gewicht einer Kennzahl ist jetzt, immer, eine exakte und vollständige Beschreibung davon, wie viel entscheidenden Einfluss sie in diesem Duell trägt; es gibt keine separate Machtberechnung mehr durchzuführen, weil Gewicht und Macht durch die Struktur des Algorithmus dieselbe Zahl sind, nicht durch empirischen Zufall.
Wo diese Duelle auf der Sektorkarte stehen
DUELs Sektor-Positionierungskarten, die nach Veröffentlichung des ursprünglichen Fragilitätsbeitrags auf der Seite eingeführt wurden, platzieren jedes Mitglied eines GICS-Sektors auf zwei Achsen — und die Achsen wurden nicht willkürlich gewählt. Sie sind eine direkte Produktanwendung unserer eigenen Hauptkomponentenanalyse der acht SEC-Kennzahlen (Wie Viele Unabhängige Signale? Eine Hauptkomponentenanalyse Eines 8-Faktor-Modells Zur Relativen Aktienbewertung), die ergab, dass die acht Kennzahlen auf vier empirisch unterscheidbare Komponenten zusammenfallen: Cash-Konversion (39 % kombiniertes Nominalgewicht), Kapitaleffizienz (33 %), Wachstum (16 %) und Accrual-Qualität (12 %). Die Karte nimmt aus jeder Komponente eine repräsentative Kennzahl und projiziert alle vier auf zwei lesbare Achsen. Die vertikale Achse ist Quality-Adjusted Profitability: Y = Operative Marge × m(Sloan), wobei die operative Marge die Cash-Konversion repräsentiert (die Kennzahl mit der höchsten Ladung unter den drei Margenkennzahlen dieser Komponente) und m(Sloan) ein Multiplikator ist, der aus der Sloan Ratio gebildet wird, der einzigen Kennzahl der Accrual-Qualität — eine positive Sloan Ratio (stärker accrual-getriebene Erträge) zieht Y nach unten, eine negative zieht es nach oben. Die horizontale Achse ist Growth Efficiency: X = Umsatzwachstum × (1 + 0,30 × z(Asset Turnover)), wobei Umsatzwachstum die Komponente Wachstum vollständig darstellt und z(Asset Turnover) der sektorrelative Z-Score des Asset Turnover ist, der die Kapitaleffizienz repräsentiert. Asset Turnover, nicht ROIC, wurde als Repräsentant dieser Komponente gewählt: In der zugrunde liegenden PCA lädt Asset Turnover mit 0,60 auf Kapitaleffizienz gegenüber 0,58 bei ROIC, und ROIC lädt zusätzlich mit 0,41 auf Cash-Konversion quer — was es zu einem verrauschteren, weniger exklusiven Stellvertreter für Kapitaleffizienz allein macht, und zu einem redundanten neben der operativen Marge, die die Y-Achse bereits verankert. ROIC selbst steht auf keiner der beiden Achsen; es bleibt einer der acht Faktoren innerhalb des Duell-Scores. Vier unserer acht Duelle fallen in Sektoren, die die Seite derzeit kartiert.
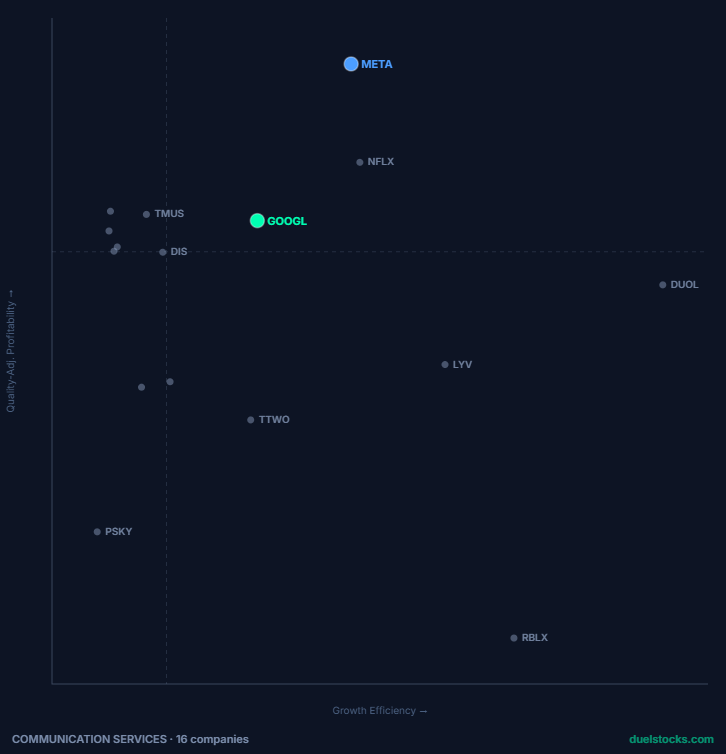
GOOGL und META sind das eine Paar in diesem Panel, bei dem Sektorkarte und Duell-Score auf den ersten Blick sichtbar unterschiedliche Geschichten erzählen. Der Duell-Score ist Metas größter struktureller Sieg im Panel — ein Acht-Kennzahlen-Sweep, durch keine Umgewichtung umzukippen. Die Positionierungskarte zeigt stattdessen beide Namen eng beieinander, nahe der Spitze der Communication-Services-Peer-Wolke, beide klar über dem Sektormedian auf beiden Achsen. Kein Bild ist falsch; sie beantworten unterschiedliche Fragen. Der Duell-Score ist ein Kopf-an-Kopf-Vergleich, beschränkt auf genau diese beiden Unternehmen; die Positionierungskarte vergleicht jedes von ihnen mit den vierunddreißig übrigen Sektormitgliedern. Meta schlägt Google bei jeder der acht Kennzahlen, aber mit generell moderaten Margen je Kennzahl (Ebene 1 oben zeigt sechs der acht Punktbeiträge unter zwei Punkten) — genug, um ein Zweikampf-Duell sauber zu gewinnen und algebraisch zu fegen, nicht genug, um die beiden Namen auf einer Karte, die gegen ein viel breiteres Peer-Set aufgebaut ist, sichtbar zu trennen. Ein Sweep ist, mit anderen Worten, nicht dieselbe Aussage wie ein Debakel; er bedeutet nur, dass ein Konkurrent denselben Vergleich gewinnt, wie man ihn auch dreht.
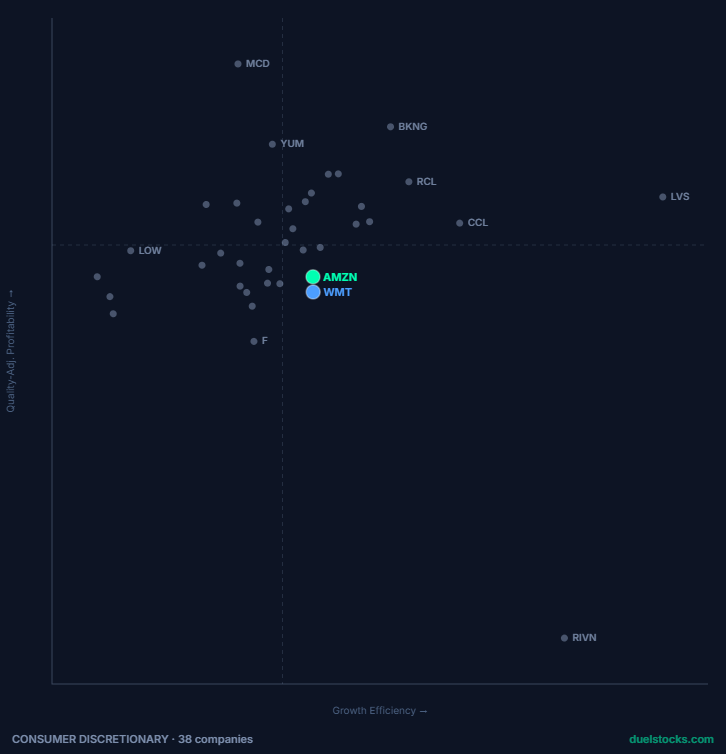
AMZN und WMT sitzen auf der Sektorkarte fast übereinander, direkt an derselben Quadrantengrenze — optisch das engste Paar jedes Duells in diesem Panel. Das deckt sich vollständig mit allem, was Ebene 1 und 2 algebraisch gefunden haben: die kleinste Marge im Panel (+2,4 Punkte), die höchste Monte-Carlo-Kipprate (36,02 %) und eine Reihe von Kennzahlbeiträgen, die sich größtenteils aufheben, statt sich zu verstärken. Die Positionierungskarte und die Fragilitätsanalyse erzählen für dieses Paar, über zwei unabhängige Methoden, exakt dieselbe Geschichte.
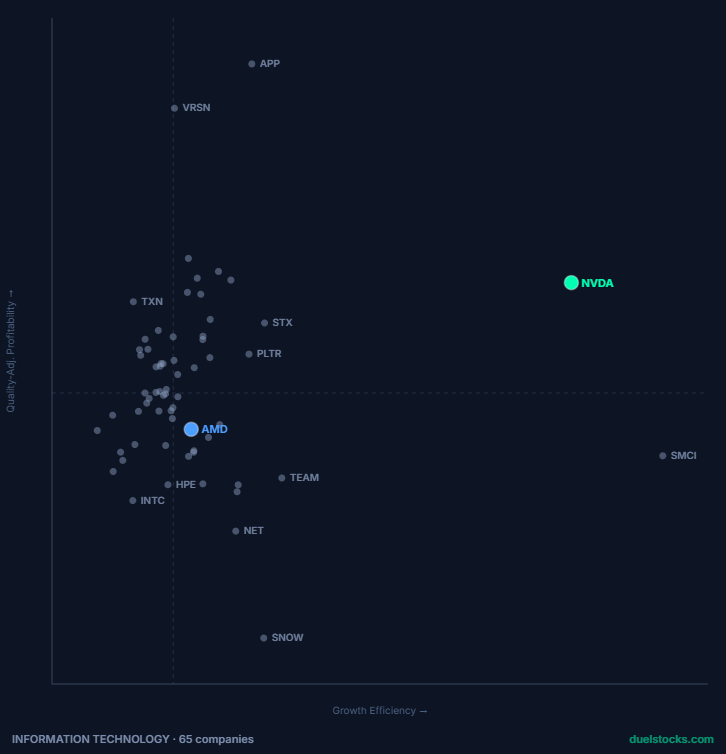
NVDA und AMD sitzen so weit auseinander, wie zwei Unternehmen desselben Sektors nur sitzen können. NVDA steht allein weit am rechten Rand der Wolke bei Growth Efficiency, komfortabel über dem Median bei Quality-Adjusted Profitability; AMD sitzt im dichten Cluster, der beide Achsenmediane überspannt, auf den ersten Blick von einem Dutzend anderer Mittelfeld-Namen nicht zu unterscheiden. Diese optische Lücke ist dieselbe Geschichte, die Ebene 1 algebraisch erzählt: die breiteste Einzelduell-Marge im Panel (+34,6 Punkte), getrieben von einem Dreijahres-Umsatz-CAGR von 100,05 %, der mit weitem Abstand die größte Rohwachstumszahl in dieser gesamten Studie ist. CRM und NOW, das andere Information-Technology-Duell im Panel, werden auf dieser Karte nicht einzeln hervorgehoben, sitzen aber beide innerhalb desselben dichten zentralen Clusters — passend zu einer realen, aber vergleichsweise moderaten +8,0-Punkte-Marge und der zweithöchsten Kipprate im Panel.
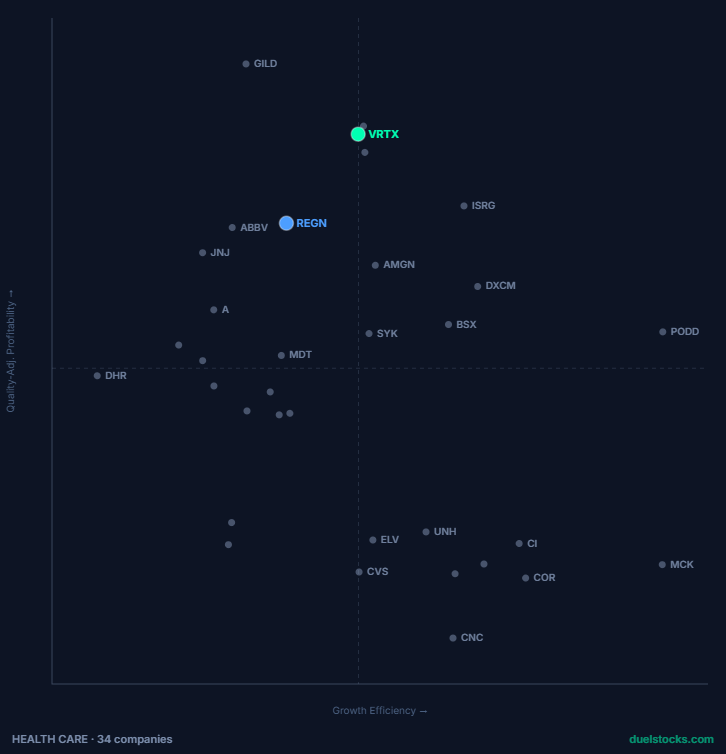
VRTX vs. REGN ist das Health-Care-Duell des Panels, und die Karte zeigt beide eng beieinander im oberen linken Quadranten — beide deutlich über dem Sektormedian bei Quality-Adjusted Profitability, beide auf der schlankeren Seite von Growth Efficiency, wobei Vertex etwas höher und rechts von Regeneron positioniert ist. Diese moderate, sichtbare Trennung deckt sich mit dem, was der Duell-Score direkt zeigt: ein Vorsprung, aufgebaut aus ROIC (+6,9 Punkte) und Receivables Turnover (+3,5 Punkte), groß genug, um Regenerons Vorteile bei operativer Cashflow-Marge und Sloan Ratio zu überstehen, was eine moderate, komfortabel nicht-fragile Marge von +13,8 Punkten ergibt — null Kipper in 10.000 Monte-Carlo-Ziehungen. Zwei Unternehmen können auf einer 34-Namen-Sektorkarte nahe beieinander sitzen und trotzdem gewinnt eines davon ein Zweikampf-Duell sauber; die Karte beantwortet „wie schneiden beide im Sektor ab", der Duell-Score beantwortet „welches der beiden ist stärker", und hier zeigen beide Antworten zufällig in dieselbe Richtung, ohne dieselbe Messung zu sein.
Was dieses Update tatsächlich löst, und was nicht
Die offene Frage des ursprünglichen Beitrags war, ob das Basisgewichtungsschema — 16/15/15/12/10/8/12/12 — auf eine Weise fragil war, die für die praktische Nutzung relevant wäre. Unter Winner-take-all fanden wir, dass es das nicht war, für jedes Duell mit einigermaßen breitem Abstand, dass aber der zugrunde liegende Abstimmungsmechanismus selbst kleinere Kennzahlen systematisch relativ zu größeren falsch bepreiste. Dieses Update beantwortet eine verwandte, aber eigenständige Frage: Ändert der Wechsel der Aggregationsregel von einer Mehrheitsabstimmung zu einer linearen Summe dieses Bild? Die Antwort ist Ja, auf zwei getrennte und unabhängig verifizierte Arten. Erstens: Bei identischen Daten stimmen die beiden Operatoren in allen acht Duellen dieses Panels beim Sieger überein — der Wechsel zu Soft Scoring hat keine bereits veröffentlichte Schlussfolgerung dieser Seite stillschweigend umgekehrt, er hat nur aufgeblähte Margen durch ehrliche ersetzt. Zweitens, und strukturell bedeutsamer: Die spezifische mathematische Pathologie, die der ursprüngliche Beitrag zutage förderte — Gewicht-versus-Macht-Divergenz, kleinere Kennzahlen strukturell untergewichtet — wird unter Soft Scoring nicht nur reduziert, sondern konstruktionsbedingt eliminiert, weil die Scoring-Funktion nicht mehr die Art von Spiel ist, in dem diese Pathologie überhaupt auftreten kann. Was weder dieser noch der ursprüngliche Beitrag beantwortet, ist, ob 16/15/15/12/10/8/12/12 der richtige Satz Gewichte im Sinne der Vorhersage zukünftiger Renditen ist; diese Kalibrierungsfrage bleibt exakt dort, wo der ursprüngliche Beitrag sie beließ, offen, und sie ist eine andere Frage als Robustheit.
Die Sektorkarten und der weiche Operator sind keine voneinander unabhängigen Produktentscheidungen; beide gehen auf Forschung zurück, die auf dieser Seite veröffentlicht wurde. Die Karten beruhen auf der Vier-Komponenten-Struktur, die unsere Hauptkomponentenanalyse der acht SEC-Kennzahlen identifizierte — Cash-Konversion, Kapitaleffizienz, Wachstum, Accrual-Qualität —, wobei jeweils eine repräsentative Kennzahl aus jeder Komponente die beiden Achsen definiert, sodass eine empirische 4-Signal-Struktur auf eine lesbare 2D-Peer-Wolke projiziert wird, ohne neue Daten oder neue Kennzahlen zu erfinden. Soft Scoring wiederum ist die direkte praktische Antwort auf den strukturellen Befund der ursprünglichen Fragilitätsstudie: Unter Winner-take-all liefen angegebenes Gewicht und entscheidende Macht systematisch auseinander. Das Ersetzen des Schwellenspiels durch eine lineare Summe entfernt diese Pathologie konstruktionsbedingt, wie Ebene 3 oben numerisch verifiziert. In beiden Fällen verlief die Forschungssequenz auf dieselbe Weise — zuerst die Messung veröffentlichen, dann das Live-Tool nur dort ändern, wo die Messung es rechtfertigte.
Limitationen
- Acht Duelle, gewählt, um exakt dem Panel des ursprünglichen Beitrags zu entsprechen, keine zufällige oder repräsentative Stichprobe von DUELs vollständigem Vergleichsraum.
- Ein SEC-Meldevintage pro Unternehmen (Snapshot vom 19. September 2026); Ergebnisse sind bedingt auf diesen Vintage und werden sich verschieben, sobald neue 10-Q- und 10-K-Meldungen eintreffen.
- Die Gegenfaktum-Winner-take-all-Spalte in Ebene 1 ist eine Neuberechnung mit gleichen Daten zur Isolierung des Operatoreffekts; sie ist nicht die historische Punktzahl, die die Seite im August anzeigte, und sollte nicht als Neuformulierung jener Zahl gelesen werden.
- Die unabhängige, renormalisierte ±50 %-Gewichtsziehung ist ein sinnvolles Störungsprotokoll unter mehreren; es entspricht der Methodik des ursprünglichen Beitrags zur direkten Vergleichbarkeit, ist aber nicht die einzig vertretbare Wahl.
- Das Shapley-Wert-Argument in Ebene 3 ist eine strukturelle, algebraische Eigenschaft jeder linearen Scoring-Funktion, hier an einem Duell durch Brute-Force-Aufzählung verifiziert; es bedarf keiner Duell-für-Duell-Neuverifikation, es gilt identisch für alle acht, und für jedes Duell, das auf diesem Algorithmus läuft, konstruktionsbedingt.
- Nichts davon ist eine Prognose zu Renditen, Drawdowns oder Analystenrevisionen. Es ist eine Robustheits- und Konsistenzprüfung dazu, wie der Vergleich berechnet wird.
Quellen
Shapley, L. S. (1953). "A Value for n-Person Games." In Contributions to the Theory of Games II, Annals of Mathematics Studies 28, Princeton University Press, 307–317.
Shapley, L. S., & Shubik, M. (1954). "A Method for Evaluating the Distribution of Power in a Committee System." American Political Science Review, 48(3), 787–792.
Banzhaf, J. F. (1965). "Weighted Voting Doesn't Work: A Mathematical Analysis." Rutgers Law Review, 19, 317–343.
Sloan, R. G. (1996). "Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings?" The Accounting Review, 71(3), 289–315.
Saaty, T. L. (1980). The Analytic Hierarchy Process. McGraw-Hill.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3. Aufl.). Wiley.
DUEL Methodology: duelstocks.com/methodology
DuelStocks, "Wie Viele Unabhängige Signale? Eine Hauptkomponentenanalyse Eines 8-Faktor-Modells Zur Relativen Aktienbewertung" (duelstocks.substack.com).
Wenn Sie irgendetwas davon selbst nachvollziehen möchten — eigene Gewichtungen einsetzen oder ein von uns nicht behandeltes Paar testen — das Live-Tool kann kostenlos auf duelstocks.com ausprobiert werden; jede Zahl in diesem Beitrag lässt sich auf einen Report zurückführen, den Sie dort direkt abrufen können.
Keine Anlageberatung. Alle Daten stammen aus öffentlichen SEC-EDGAR-Meldungen.
Eine DuelStocks-Fundamentalanalyse. Keine Anlageberatung — und, wie der Rest dieser Serie, auch keine Prognose. Alle folgenden Zahlen stammen aus öffentlichen SEC-EDGAR-Meldungen (10-K/10-Q), verarbeitet durch DUELs Battle-, DCF- und Resilience-(STR)-Reports.
Jeder Wachstumsgeschichte wird irgendwann dieselbe Frage gestellt: Verwandelt sich das Wachstum tatsächlich in Cash, oder verwandelt es sich in etwas, das in der Gewinn- und Verlustrechnung nur wie Cash aussieht? Dieser Beitrag handelt nicht von KI, nicht von einem einzelnen Sektor und nicht von einem einzelnen Unternehmen. Es ist ein universeller Screen — einmal gebaut, wiederverwendbar für jeden zukünftigen Wachstumszyklus — für ein spezifisches Muster: Umsatz wächst mit gesundem Tempo, während der Cash, den dieses Wachstum erzeugt, vom Buchgewinn abweicht, den er eigentlich repräsentieren soll.
Dies ist eine direkte methodische Erweiterung von drei früheren Beiträgen dieser Serie. Der Ansatz zur Korb-Konstruktion folgt [Wie viele unabhängige Signale? Eine Hauptkomponentenanalyse]. Die Basisraten-Rahmung, einschließlich der Wilson-Intervall- und Cochran-Mindestanzahl-Disziplin, folgt [Das Warnsignal, über das niemand spricht]. Und die zugrunde liegende Accrual-Qualitätslogik — dass Umsatzwachstum, das der Cash-Generierung davonläuft, ein Lehrbuch-Frühwarnmuster ist — stammt von Sloan (1996), derselben Arbeit, die DUELs eigene Sloan-Ratio-Kennzahl verankert.
Wo bleibt in einem sektorübergreifenden Korb von 72 Unternehmen das 3-Jahres-Umsatzwachstum stark, während operative Marge und FCF-Marge bereits auseinanderlaufen — und stimmt DUELs eigene Sloan Ratio mit dieser Divergenz überein?
Teil 1 — Den Korb zusammenstellen
Der Korb umfasst 72 Unternehmen über fünf Sektoren:
- Tech / Halbleiter / Software (22): AAPL, AMD, AVGO, CRM, GOOGL, META, MSFT, INTC, KLAC, LRCX, MCHP, MU, NFLX, NOW, NVDA, PLTR, QCOM, SNDK, SNPS, STX, TXN, XYZ
- Industrie (12): CAT, DE, F, FDX, GM, LMT, RTX, UPS, LIN, SHW, GE, HON
- Gesundheitswesen (11): AMGN, BDX, BMY, ISRG, REGN, VRTX, JNJ, PFE, ABT, MDT, DHR
- Konsum / Einzelhandel / Grundnahrungsmittel / Telekom (22): AMZN, CCL, CL, COST, DIS, HD, HSY, KO, LOW, MDLZ, MO, PEP, PG, PM, RCL, ROST, TJX, TMUS, VZ, WMT, MCD, NKE
- Energie (5): COP, OXY, XOM, CVX, SLB
Jedes Unternehmen reicht 10-K/10-Q bei der SEC ein und wird durch DUELs Standard-Pipeline verarbeitet. Beide Screens unten basieren vollständig auf den vier Feldern, die über diesen gesamten Korb verfügbar sind — Umsatzwachstum, operative Marge, FCF-Marge und Sloan Ratio —, was einen einheitlichen 72-Unternehmen-Vergleich überhaupt erst möglich macht.
Teil 2 — Zwei unabhängige Stress-Screens
„Wachstum, das dem Cash davonläuft" ist keine einzelne Sache — es kann sich als ausgewiesener operativer Gewinn zeigen, der dem tatsächlichen freien Cashflow deutlich vorauseilt, oder als Accrual-Aufbau, der schwer genug ist, um Sloans eigenes Accrual-Qualitätsmaß auszulösen, und ein Unternehmen kann das eine Signal ohne das andere zeigen. Wir haben zwei separate, unabhängig definierte Screens über jedes Unternehmen mit 3-Jahres-Umsatz-CAGR ≥ 5 % laufen lassen:
Screen A — Cash-Conversion-Lücke: Operative Marge minus FCF-Marge ≥ 10 Prozentpunkte. Das fragt, ob die eigene ausgewiesene operative Profitabilität eines Unternehmens dem Cash, den diese Profitabilität erzeugt, spürbar vorauseilt, unabhängig davon, ob die FCF-Marge selbst isoliert betrachtet gesund aussieht.
Screen B — Erhöhte Sloan Ratio: Sloan Ratio > 5 %, DUELs eigener Schwellenwert für „moderate Accruals erkannt". Das fragt, ob der Nettogewinn selbst eher aus Accruals als aus operativem Cashflow aufgebaut wird — ein anderes, früheres Signal als die Margenlücke in Screen A.
Von den 72 Unternehmen zeigen 34 (47 %) ein 3-Jahres-Umsatzwachstum von 5 % oder mehr. Beide Screens laufen nur innerhalb dieser Hochwachstumsgruppe — ein Unternehmen mit flachem oder rückläufigem Umsatz, das eine breite Margen-zu-Cash-Lücke zeigt, ist eine andere, banalere Geschichte (oft nur ein zyklischer oder einmaliger Posten) als dieselbe Lücke neben echtem Wachstum.
Teil 3 — Screen A: Wer wächst schneller, als er Cash konvertiert
| Ticker | Sektor | Umsatzwachstum (3J CAGR) | Op. Marge | FCF-Marge | Lücke (pp) | Sloan Ratio | Receivables T/O | FRI |
|---|---|---|---|---|---|---|---|---|
| MU | Tech/Halbleiter/Software | 6,71 % | 26,14 % | 4,46 % | 21,7 | 36,86 % | 1,39x | 76 (HOCH) |
| RCL | Konsum/Einzelhandel/Grundnahrungsmittel/Telekom | 26,59 % | 27,38 % | 6,89 % | 20,5 | -11,90 % | 37,44x | 42 (MODERAT) |
| MSFT | Tech/Halbleiter/Software | 12,42 % | 45,62 % | 25,42 % | 20,2 | 6,70 % | 4,69x | 81 (HOCH) |
| MCD | Konsum/Einzelhandel/Grundnahrungsmittel/Telekom | 5,06 % | 46,10 % | 26,73 % | 19,4 | -7,61 % | — | 43 (MODERAT) |
| META | Tech/Halbleiter/Software | 19,89 % | 41,44 % | 22,94 % | 18,5 | -14,00 % | 11,50x | 83 (HOCH) |
| GOOGL | Tech/Halbleiter/Software | 12,51 % | 32,03 % | 18,19 % | 13,8 | 16,91 % | 5,82x | 85 (HOCH) |
| NVDA | Tech/Halbleiter/Software | 100,05 % | 60,38 % | 47,50 % | 12,9 | -6,92 % | 5,30x | 64 (MODERAT) |
| PM | Konsum/Einzelhandel/Grundnahrungsmittel/Telekom | 8,57 % | 36,64 % | 26,23 % | 10,4 | -10,25 % | 7,85x | 49 (MODERAT) |
Acht von 34 Hochwachstumsunternehmen (23,5 %, Wilson-95-%-KI [12,4 %, 40,0 %]) zeigen eine Cash-Conversion-Lücke von 10 Punkten oder mehr. Die größte Lücke im gesamten 72-Unternehmen-Korb gehört MU mit 21,7 Punkten — und MU trägt auch die höchste Sloan Ratio im Korb (36,86 %) und mit 1,39x den zweitniedrigsten Receivables Turnover aller 66 Unternehmen mit verfügbarem Feld (nur AVGO ist mit 0,36x niedriger) — drei unabhängige Signale aus drei verschiedenen Teilen derselben Meldungen, die alle in dieselbe Richtung weisen. Fünf der acht markierten Namen sind Tech/Halbleiter/Software-Unternehmen; die anderen drei umfassen Konsumnamen mit sehr unterschiedlichen Geschäften (eine Kreuzfahrtlinie, ein Fast-Food-Franchisegeber, ein Tabakkonzern) — eine Erinnerung daran, dass dieses Muster nicht sektorspezifisch ist, auch wenn es sich ungleich konzentriert.
Teil 4 — Häuft sich die Lücke nach Sektor? Ein Basisraten-Check
| Sektor | Hochwachstum, beide Margen verfügbar | Lücke ≥ 10pp | Rate | Wilson-95-%-KI |
|---|---|---|---|---|
| Tech/Halbleiter/Software | 15 | 5 | 33,3 % | [15,2 %, 58,3 %] |
| Konsum/Einzelhandel/Grundnahrungsmittel/Telekom | 10 | 3 | 30,0 % | [10,8 %, 60,3 %] |
| Industrie | 3 | 0 | 0,0 % | [0,0 %, 56,2 %] |
| Gesundheitswesen | 5 | 0 | 0,0 % | [0,0 %, 43,4 %] |
| Energie | 1 | 0 | 0,0 % | [0,0 %, 79,3 %] |
Nach derselben Disziplin wie in unserem früheren Basisraten-Beitrag: Cochrans (1977) Faustregel verlangt mindestens 5 beobachtete Ereignisse für eine stabile Ratenschätzung, und nur Tech/Halbleiter/Software erfüllt diese Hürde in diesem Ausschnitt eindeutig, mit Konsum/Einzelhandel/Grundnahrungsmittel/Telekom knapp dahinter. Industrie, Gesundheitswesen und Energie haben jeweils zu wenige Hochwachstumsnamen in diesem Korb, um überhaupt eine Ratenaussage zu stützen; ihre 0-%-Werte spiegeln kleine Nenner wider (3, 5 bzw. 1 Unternehmen), nicht eine nachgewiesene Abwesenheit des Musters in diesen Sektoren. Die breiten, überlappenden Konfidenzintervalle über jeden Sektor hinweg sind der ehrliche Befund hier: Bei dieser Korbgröße können wir noch nicht sagen, dass die Cash-Conversion-Lücke ein Tech-spezifisches Phänomen ist — nur, dass sie in Tech und Konsum oft genug sichtbar ist, um sie zu messen, und anderswo noch nicht messbar ist.
Teil 5 — Screen B: Erhöhte Sloan Ratio bei Hochwachstumsnamen
| Ticker | Sektor | Umsatzwachstum (3J CAGR) | Sloan Ratio | Receivables T/O | FRI | DUELs ROIC-vs-Sloan-Markierung |
|---|---|---|---|---|---|---|
| MU | Tech/Halbleiter/Software | 6,71 % | 36,86 % | 1,39x | 76 (HOCH) | OK |
| SNDK | Tech/Halbleiter/Software | 6,52 % | 27,58 % | 2,70x | 33 (NIEDRIG) | OK |
| GOOGL | Tech/Halbleiter/Software | 12,51 % | 16,91 % | 5,82x | 85 (HOCH) | OK |
| AMZN | Konsum/Einzelhandel/Grundnahrungsmittel/Telekom | 11,73 % | 13,01 % | 9,49x | 100 (HOCH) | OK |
| NOW | Tech/Halbleiter/Software | 22,38 % | 7,67 % | 6,03x | 88 (HOCH) | OK |
| MSFT | Tech/Halbleiter/Software | 12,42 % | 6,70 % | 4,69x | 81 (HOCH) | VORSICHT |
Sechs von 34 Hochwachstumsunternehmen (17,6 %) tragen eine Sloan Ratio über 5 %. Fünf von sechs sitzen speziell in Tech/Halbleiter/Software. Nur eines der sechs — MSFT — löst tatsächlich DUELs eigene ROIC-vs-Sloan-Konsistenzprüfung aus; die anderen fünf, einschließlich MU mit der bei Weitem höchsten Sloan Ratio im gesamten Korb, lesen sich bei dieser spezifischen internen Prüfung als OK, weil DUELs ROIC-vs-Sloan-Markierung durch die Kombination eines hohen ROIC neben der erhöhten Sloan Ratio ausgelöst wird, nicht durch die Sloan Ratio allein. MUs eigener ROIC überschreitet in dieser Momentaufnahme nicht die Schwelle, die sich mit seiner Sloan Ratio paaren würde, um die Markierung auszulösen — eine Erinnerung daran, dass das direkte Lesen der Sloan Ratio, statt nur ihrer nachgelagerten Markierung, Fälle aufdeckt, die die Markierung selbst nicht zeigt.
Drei Unternehmen — MU, MSFT und GOOGL — erscheinen sowohl in Screen A als auch in Screen B: eine echte Margen-zu-Cash-Lücke und eine erhöhte Sloan Ratio, unabhängig voneinander aus verschiedenen Teilen derselben Meldungen abgeleitet, die auf dieselbe zugrunde liegende Geschichte hinweisen. Diese Überschneidung ist, mehr als jeder Screen für sich, das stärkste Signal dieses Korbs.
Teil 6 — Zwei Prüfungen, zwei Fragen: Wachstum-vs-FCF gegen einen Margenlücken-Screen
DUELs eingebaute Wachstum-vs-FCF-Konsistenzprüfung und Screen A sind beide legitime Lesarten derselben Meldungen, und sie widersprechen sich in diesem Korb größtenteils: DUELs eigene Markierung liest sich bei sieben der acht von Screen A identifizierten Unternehmen als OK, einschließlich MU, das die größte Lücke und die höchste Sloan Ratio im gesamten Korb trägt. Nur RCL löst beide Prüfungen gleichzeitig aus.
Dieser Widerspruch ist ein Merkmal dessen, was jede Prüfung messen soll, kein Defekt in einer von beiden. DUELs Wachstum-vs-FCF-Markierung, basierend auf dem Wortlaut ihrer eigenen Konflikthinweise („Umsatzwachstum 18,6 %, FCF-Marge 5,7 %: Cash-Konversion beobachten"), ist darauf ausgelegt, Unternehmen zu erfassen, deren FCF-Marge absolut niedrig ist neben hohem Wachstum — sie fragt: „Ist dieses Unternehmen trotz schnellen Wachstums kaum cash-generierend?" Screen A stellt eine engere, selbstbezügliche Frage: „Eilt der eigene ausgewiesene operative Gewinn dieses Unternehmens seiner eigenen Cash-Generierung spürbar voraus?" Ein Unternehmen kann eine durchaus respektable zweistellige FCF-Marge tragen — MSFTs 25,42 % ist isoliert betrachtet eine starke Zahl — und trotzdem eine echte Lücke gegenüber der eigenen operativen Marge von 45,62 % zeigen. Eine auf absolute FCF-Marge ausgerichtete Markierung hat keinen Grund, bei einem Unternehmen anzuschlagen, dessen FCF-Marge für sich genommen gut aussieht; ein Screen, der ein Unternehmen nur mit sich selbst vergleicht, erfasst einen anderen, komplementären Ausschnitt derselben zugrunde liegenden Frage. Dieser Korb ist eine konkrete Illustration dafür, wie stark die eigene Definition einer Prüfung bestimmt, was sie findet — dieselbe Lektion, die unser früherer Fragile-Score-Beitrag für Ranking-Gewichte demonstriert hat.
Teil 7 — Was das tatsächlich beantwortet, und was nicht
Dieser Beitrag sagt nicht und kann nicht sagen, dass das Wachstum eines markierten Unternehmens von geringer Qualität ist, dass seine Aktie überbewertet ist, oder dass sich seine Cash-Konversion weiter verschlechtern wird. Eine breite Lücke zwischen operativer Marge und FCF-Marge kann Working-Capital-Timing, erhöhte CAPEX während einer echten Wachstumsinvestitionsphase, aufgeschobene Umsatzrealisierungsmechanik oder schlichte Rechnungslegungsstruktur widerspiegeln — nicht zwangsläufig ein Problem. Was dieser Beitrag direkt und reproduzierbar zeigt: Über 72 Unternehmen in fünf Sektoren hinweg ist ein spezifisches, messbares Muster — hohes Umsatzwachstum gepaart mit einer großen Lücke zwischen ausgewiesener operativer Profitabilität und tatsächlicher Cash-Generierung, oder mit Accrual-Aufbau, der schwer genug ist, um Sloans eigene Ratio zu bewegen — bei etwa einem Viertel der Hochwachstumsunternehmen in diesem Korb vorhanden, konzentriert in, aber nicht exklusiv für Tech/Halbleiter/Software, und für eine von DUELs eigenen eingebauten Konsistenzprüfungen weitgehend unsichtbar, gerade weil diese Prüfung darauf ausgelegt ist, ein verwandtes, aber anderes Signal zu erfassen.
Einschränkungen
Beide Screens verwenden einen einheitlichen, DCF-Ebenen-Querschnitt, der über den gesamten Korb verfügbar ist — Umsatzwachstum, operative Marge, FCF-Marge und Sloan Ratio. Andere Battle-Report-Faktoren, einschließlich Receivables Turnover, liegen außerhalb der Definition dieser beiden Screens; wo Receivables Turnover in Teil 3 und 5 gezeigt wird, ist es beschreibender Kontext neben den markierten Namen, nicht Teil der Bestehen/Nichtbestehen-Kriterien eines der beiden Screens.
Die Schwellenwerte von 10 Prozentpunkten Lücke und 5 % Sloan sind konstruierte Konventionen, keine universellen Konstanten. Ein engerer oder weiterer Lückenschwellenwert würde Unternehmen in Screen A hinein- oder herausbewegen; dasselbe gilt für den Sloan-Grenzwert bei Screen B. Wir wählten runde, vertretbare Zahlen, statt Schwellenwerte zu optimieren, um ein bestimmtes Ergebnis zu erzeugen, aber andere vernünftige Entscheidungen würden die spezifische Unternehmensliste verschieben, ohne das breitere Sektormuster zu verändern.
Drei von fünf Sektoren haben zu wenige Hochwachstumsunternehmen in diesem Korb, um eine Basisraten-Aussage zu stützen, gemäß Cochrans (1977) Mindestanzahl-Richtlinie — Industrie (3), Gesundheitswesen (5) und Energie (1). Ihre 0-%-Werte in Teil 4 beschreiben diesen Korb, nicht eine nachgewiesene Abwesenheit des Musters in diesen Sektoren im weiteren Sinne.
FRI wird nicht angezeigt, wo der Resilience Report nicht Teil der bewerteten Felder dieses Korbs für ein gegebenes Unternehmen war; beide Screens sind davon nicht betroffen, da keiner von FRI abhängt.
Dies ist eine einzelne, sich über mehrere Wochen erstreckende Meldungszeitraum-Momentaufnahme, kein longitudinaler oder zeitpunktkonsistenter Korb. Das Wachstum-zu-Cash-Profil eines Unternehmens kann sich von einer Quartalsmeldung zur nächsten verschieben und tut dies auch.
Zweiundsiebzig Unternehmen sind ein diagnostischer Korb, keine zufällige oder repräsentative Stichprobe des US-notierten Marktes — lesen Sie die Sektor-Basisraten in Teil 4 als beschreibend für diesen Korb, nicht als Schätzungen auf Populationsebene.
Fazit
Über einen Fünf-Sektor-Korb von 72 Unternehmen zeigt etwa ein Viertel der Hochwachstumsunternehmen eine ausgewiesene operative Profitabilität, die der tatsächlichen Cash-Generierung spürbar vorauseilt, und etwa jedes sechste zeigt einen Accrual-Aufbau, der schwer genug ist, um die eigene Sloan Ratio zu bewegen — wobei drei Unternehmen beide Signale unabhängig voneinander auslösen, und eines dieser drei (MU) zudem nahe dem unteren Ende des gesamten Korbs beim Receivables Turnover steht. Das Muster konzentriert sich in Tech/Halbleiter/Software und, in geringerem Maße, Konsum, obwohl der Korb in den anderen drei Sektoren zu klein ist, um zu sagen, ob diese Konzentration real oder ein Artefakt dieses spezifischen Korbs ist. Und entscheidend: Die meisten der von diesem Screen markierten Unternehmen bestehen DUELs eigene eingebaute Wachstum-vs-FCF-Prüfung sauber — nicht weil eine der beiden Prüfungen defekt ist, sondern weil sie darauf ausgelegt sind, unterschiedliche Dinge zu erfassen. Nichts davon ist ein Signal zum Handeln. Es ist ein Detektor, einmal aus öffentlichen Meldungen und einer dokumentierten Formel gebaut, konzipiert, um erneut auf welchem Sektor auch immer den nächsten Wachstumszyklus für sich beansprucht, angewendet zu werden.
Jede Zahl in diesem Beitrag lässt sich auf ein Duell zurückführen, das Sie selbst auf duelstocks.com abrufen und erneut überprüfen können.
Weiterführende Lektüre — Gleiche Serie, gleiche Methode
Dieser Beitrag erweitert die Korb-Konstruktions- und Basisraten-Methodik, die in den vorherigen Beiträgen dieser Serie etabliert wurde, die Sie auf dieser Seite nachlesen können.
Quellen
Sloan, R. G. (1996). Do stock prices fully reflect information in accruals and cash flows about future earnings? The Accounting Review, 71(3), 289–315.
Dechow, P. M., Ge, W., Larson, C. R., & Sloan, R. G. (2011). Predicting material accounting misstatements. Contemporary Accounting Research, 28(1), 17–82.
Cochran, W. G. (1977). Sampling Techniques (3. Aufl.). Wiley.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3. Aufl.). Wiley.
U.S. Securities and Exchange Commission — EDGAR-Volltextsuche und strukturierte XBRL-Meldedaten, sec.gov.
Eine methodische Tiefenanalyse von DuelStocks. Keine Anlageberatung. Alle Daten stammen aus öffentlichen SEC-EDGAR-Meldungen.
Eine DuelStocks-Fundamentalanalyse. Keine Anlageberatung — und, wie der Rest dieser Serie, auch keine Prognose. Alle folgenden Zahlen stammen aus öffentlichen SEC-EDGAR-Meldungen (10-K/10-Q), verarbeitet durch DUELs Battle-, DCF- und Resilience-(STR)-Reports.
Jeder Chip im KI-Ausbau muss von irgendetwas hergestellt werden, und dieses „Etwas" ist ein echtes Oligopol: eine Handvoll Unternehmen, von denen die Chiphersteller selbst abhängen. Dieser Beitrag bleibt innerhalb dieses Oligopols — AMAT, LRCX, KLAC, TER und ONTO — und stellt eine engere, präzisere Frage als die breiteren Infrastrukturbeiträge dieser Serie: Wer setzt sich innerhalb einer Fünf-Unternehmen-Gruppe, die schon auf dem Papier stark aussieht, tatsächlich durch, wenn man sie systematisch vergleicht — und wie stark hängt die Antwort davon ab, wie man den Vergleich gewichtet?
Wer gewinnt innerhalb des engen Kreises börsennotierter Halbleiter-Fertigungsausrüstungslieferanten einen vollständigen Rundenvergleich, wer hat trotz bereits hoher Margen das meiste modellierte Aufwärtspotenzial, und deckt sich die Resilienz mit dem „offensichtlichen" Zyklusführer — oder wackelt das Ranking selbst, je nachdem wie die Bewertung gewichtet wird?
Teil 1 — Den Korb zusammenstellen, und eine Korrektur, die es zu benennen gilt
Der Korb besteht aus fünf Unternehmen: AMAT (Applied Materials), LRCX (Lam Research), KLAC (KLA Corporation), TER (Teradyne) und ONTO (Onto Innovation). Alle fünf reichen 10-K/10-Q bei der SEC ein und sind für DUELs Pipeline sauber lesbar.
Dieser Beitrag war ursprünglich um ein vollständiges Zehn-Duell-Rundenturnier herum geplant — jedes der fünf Unternehmen gegen jedes andere, nach der Methode unseres früheren Beitrags [Jenseits des Paars]. Das erwies sich als mehr Datensammlung, als die Frage tatsächlich erforderte. DUELs eigene Methodik veröffentlicht ihre Bewertungsformel offen: Score = Σ(Wᵢ × Nᵢ) × 100, wobei Wᵢ das feste Gewicht jedes Faktors ist und Nᵢ eine einfache Sieg/Niederlage/Unentschieden-Markierung (1, 0 oder 0,5) für diesen Faktor zwischen genau zwei Unternehmen. Da die zugrunde liegenden Faktorwerte selbst — Umsatzwachstum, Margen, ROIC, Sloan Ratio, Umschlagskennzahlen — gegneruabhängig sind (derselbe Validitätscheck, der mit MU in unserem ersten Beitrag und hier mit LRCX bestätigt wurde, siehe Teil 3), lässt sich die vollständige Rundenturnier-Bilanz eines Unternehmens gegen jedes andere im Korb analytisch aus den Rohfaktor-Tabellen rekonstruieren. Wir brauchten nur genug Duelle, um die Rohzahlen jedes Unternehmens einmal zu sehen, nicht zehn direkte Vergleiche. Zwei neue Duelle — AMAT gegen TER und ONTO gegen LRCX — lieferten die drei Unternehmen, die noch nicht durch ein früheres LRCX-gegen-KLAC-Duell vom 26. Juli 2026 abgedeckt waren, und jede andere Paarung in diesem Beitrag wird direkt aus den offengelegten Inputs dieser vier Duelle mittels DUELs eigener veröffentlichter Formel berechnet.
Eine Konsequenz dieser Art der Matrix-Rekonstruktion ist es wert, sofort markiert zu werden: Sie erfordert die vollständige Acht-Faktoren-Battle-Report-Tabelle (Umsatzwachstum, Operative Cash-Marge, ROIC, Sloan Ratio, Asset Turnover, Receivables Turnover, Operative Marge, FCF-Marge) für jedes Unternehmen, und das LRCX-gegen-KLAC-Duell vom 26. Juli lieferte uns nur KLACs fünf DCF-Modell-Inputs, nicht seinen Asset Turnover oder Receivables Turnover. KLAC erscheint daher durchgehend in den DCF- und Resilienz-Abschnitten dieses Beitrags, ist aber von der rekonstruierten Rundenturnier-Matrix in Teil 3 ausgeschlossen, wo wir nur für vier der fünf Unternehmen vollständige Daten hatten. Wir legen diese Lücke lieber offen dar, als zwei von acht gewichteten Faktoren zu schätzen.
Eine zweite Sache, die es vorab zu benennen gilt: LRCXs Zahlen hier stammen aus einer Meldungs-Momentaufnahme vom 18. August 2026, während KLACs vom 26. Juli 2026 stammen — und LRCXs eigene Zahlen bewegten sich zwischen diesen Daten erheblich (Umsatzwachstum 2,29 % → 10,06 %, ROIC 42,54 % → 53,69 % in DUELs eigener Duell-Historie), höchstwahrscheinlich weil dazwischen eine neue Quartalsmeldung einging. Wir verwenden durchgehend die aktuellere LRCX-Momentaufnahme und weisen auf die Datumslücke hin, statt zwei verschiedene Meldungszeiträume zu vermischen.
Teil 2 — Die Acht-Faktoren-Scorecard
| Ticker | Umsatzwachstum (3J CAGR) | Op. Cash-Marge | ROIC | Sloan Ratio | Asset T/O | Receivables T/O | Operative Marge | FCF-Marge |
|---|---|---|---|---|---|---|---|---|
| AMAT | 3,23 % | 28,05 % | 25,84 % | -3,44 % | 0,70x | 4,45x | 29,22 % | 20,09 % |
| TER | 0,37 % | 21,14 % | 15,79 % | 8,89 % | 0,65x | 2,87x | 20,38 % | 14,12 % |
| ONTO | 0,00 % | 32,66 % | 14,89 % | 2,93 % | 0,27x | 2,98x | 13,22 % | 29,82 % |
| LRCX | 10,06 % | 25,21 % | 53,69 % | 9,90 % | 0,99x | 4,35x | 35,29 % | 21,24 % |
| KLAC* | 9,69 % | k. A. | 5,42 % | 2,39 % | k. A. | k. A. | 6,35 % | 30,82 % |
*KLAC-Zahlen stammen aus einem Duell vom 26. Juli 2026 und sind unvollständig — Op. Cash-Marge, Asset Turnover und Receivables Turnover waren nicht Teil des erfassten Outputs jenes Duells. KLACs operative Marge (6,35 %) und ROIC (5,42 %) wirken zudem im Vergleich zur typischen historischen Spanne dieses Unternehmens und zur eigenen FCF-Marge von 30,82 % in derselben Momentaufnahme ungewöhnlich niedrig; das trägt eher die Handschrift eines Periodenausrichtungs-Artefakts (die eigenen Battle Reports der Seite warnen, dass die Vermischung von Quartals- und Jahresfeldern genau diese Art von Diskrepanz erzeugen kann) als eine echte operative Verschlechterung. Wir berichten die Zahl, wie sie erzeugt wurde, und markieren sie, statt sie stillschweigend zu korrigieren.
Kein einzelnes Unternehmen gewinnt bei jedem Faktor, außer in einem spezifischen Matchup (siehe Teil 3). LRCX verzeichnet mit weitem Abstand den stärksten ROIC (53,69 %) und die stärkste operative Marge (35,29 %) in der Gruppe, aber auch die höchste Sloan Ratio (9,90 %) — die Accrual-Qualitätsmarkierung, die DUELs eigener Resilience Report in Teil 5 direkt erfasst. ONTO hat die kleinste Umsatzbasis und praktisch flaches nachlaufendes Wachstum (0,00 %), aber die zweithöchste FCF-Marge (29,82 %) und den niedrigsten Asset Turnover (0,27x) im Korb — ein Unternehmen, das eine kleine, umschlagsschwache Vermögensbasis ungewöhnlich effizient in Cash umwandelt. AMAT und TER liegen bei den meisten Faktoren dazwischen, wobei AMAT bei allen acht Faktoren vor TER liegt.
Teil 3 — Das Rundenturnier: Wer tatsächlich Kopf-an-Kopf gewinnt
Die Rekonstruktion jeder Paarung unter den vier Unternehmen mit vollständigen Daten, unter Verwendung von DUELs eigener veröffentlichter Formel, ergibt ein vollständiges Sechs-Matchup-Rundenturnier:
| Matchup | Score | Sieger |
|---|---|---|
| AMAT vs. TER | 100 — 0 | AMAT (Sweep — alle 8 Faktoren) |
| AMAT vs. ONTO | 73 — 27 | AMAT |
| TER vs. ONTO | 53 — 47 | TER |
| AMAT vs. LRCX | 35 — 65 | LRCX |
| TER vs. LRCX | 12 — 88 | LRCX |
| ONTO vs. LRCX | 39 — 61 | LRCX (direkt von DUEL bestätigt) |
LRCX gewinnt jedes seiner drei Matchups; AMAT gewinnt zwei von drei (verliert nur gegen LRCX); TER und ONTO teilen sich ihr einziges direktes Duell, wobei TERs Sieg das knappste Ergebnis der gesamten Tabelle ist. Die Durchschnittsbildung über die drei Matchups jedes Unternehmens ergibt ein zusammengesetztes Ranking:
| Rang | Ticker | Ø-Score |
|---|---|---|
| 1 | LRCX | 71,3 |
| 2 | AMAT | 69,3 |
| 3 | ONTO | 37,7 |
| 4 | TER | 21,7 |
LRCX setzt sich mit einem Zwei-Punkte-Vorsprung im Durchschnitt gegen AMAT an die Spitze — dünn genug, dass Teil 6 testet, ob dies eine vernünftige Änderung der Gewichtung der acht Faktoren übersteht.
Teil 4 — Wie viel Wachstum bereits im Preis steckt
DUELs DCF-Engine baut einen fairen Wert und eine 3-Jahres-Kursprojektion allein aus den eigenen Meldungen jedes Unternehmens auf: kein Marktpreis als Input, keine Analysten-Wachstumsschätzungen, nur Umsatz-CAGR, FCF, ROIC und Sloan Ratio, verarbeitet durch eine feste Formel (vollständige Methodik in unserem früheren [Beitrag zum DCF-Konfidenzband]).
| Ticker | Fair Value (T0) | Modelliert +3J Kurs | Modelliertes 3J-Aufwärtspotenzial |
|---|---|---|---|
| TER | 31,63 $ | 40,06 $ | 26,7 % |
| ONTO | 84,27 $ | 102,62 $ | 21,8 % |
| AMAT | 118,65 $ | 141,90 $ | 19,6 % |
| LRCX | 103,19 $ | 117,61 $ | 14,0 % |
| KLAC | 780,69 $ | 884,91 $ | 13,3 % |
Der Sieger des Rundenturniers und der DCF-Sieger sind zwei verschiedene Unternehmen. LRCX — der stärkste Name im Kopf-an-Kopf-Ranking — hat das zweitniedrigste modellierte Aufwärtspotenzial in der Gruppe, aus demselben strukturellen Grund, aus dem NVDA im Chip-/Networking-Beitrag das geringste modellierte Aufwärtspotenzial zeigte: LRCXs eigener Unternehmenswert ist im Verhältnis zu seinen projizierten Cashflows bereits groß, sodass das Fortschreiben eines festen Wachstumspfads die Fair-Value-Schätzung um einen kleineren Prozentsatz bewegt als dieselbe Übung auf einer kleineren Basis. TER, der schwächste Name im Rundenturnier (Ø 21,7), zeigt das größte modellierte Aufwärtspotenzial — seine aktuelle Bewertung bildet am wenigsten von seiner eigenen historischen Flugbahn ab, genau weil diese Flugbahn (0,37 % nachlaufendes Umsatzwachstum) die am wenigsten beeindruckende im Korb ist. KLACs 13,3-%-Aufwärtspotenzial sollte zusammen mit der Input-Qualitätsmarkierung in Teil 2 gelesen werden: Falls seine operative Marge und sein ROIC durch ein Datenartefakt in dieser Momentaufnahme unterschätzt sind, ist sein modelliertes Aufwärtspotenzial eher unterschätzt als überschätzt, da beide in die Wachstumsqualitäts-Multiplikatoren des Modells einfließen.
Teil 5 — Wer tatsächlich die Bilanz-Rüstung hat
| Ticker | FRI-Score | Stufe | Wachstum vs. FCF | ROIC vs. Sloan | Verschuldung vs. Cash |
|---|---|---|---|---|---|
| ONTO | 100 | HOCH | OK | OK | OK |
| TER | 93 | HOCH | OK | OK | OK |
| AMAT | 78 | HOCH | OK | OK | OK |
| KLAC | 76 | HOCH | OK | OK | RISIKO |
| LRCX | 63 | MODERAT | OK | VORSICHT | OK |
Das ist die schärfste Divergenz in diesem Beitrag. LRCX — der Sieger des Rundenturniers und der ROIC-Führer der Gruppe — trägt den niedrigsten Resilienzwert der fünf, aufgrund einer einzelnen spezifischen Markierung: sein ROIC von 53,69 % neben einer Sloan Ratio von 9,90 % löst DUELs ROIC-vs-Sloan-Konsistenzprüfung aus, dasselbe „milde Accrual-Aufbau"-Signal, das wir in unserem Basisraten-Beitrag zu genau diesem Konflikttyp ausführlich untersucht haben. Es ist kein Verschuldung-vs-Cash-Problem — LRCXs Cash-zu-Verschuldung-Deckung liegt komfortabel über 1,0x — es ist ein Hinweis, dass ein Teil von LRCXs ausgewiesener Profitabilität eher über Accruals als über Cash ankommt, eher beobachtenswert als für sich genommen ein Warnsignal. KLAC ist der gegenteilige Fall: ein sauberes Wachstum-vs-FCF- und ROIC-vs-Sloan-Profil, unterminiert von einer echten Verschuldung-vs-Cash-Markierung (Verschuldungsgrad von 1,1x, wobei Cash nur 0,3x der Gesamtverschuldung deckt) — eine Leverage-Geschichte, keine Ertragsqualitäts-Geschichte. ONTO, das kleinste Unternehmen im Korb nach Umsatz, verzeichnet das mit Abstand sauberste Resilienzprofil der Gruppe: eine schuldenfreie Bilanz (Gesamtverschuldung: 0,00 $) und einen perfekten FRI von 100.
Teil 6 — Wie fragil ist dieses Ranking? Die Gewichte auf den Prüfstand
Teil 3s Rundenturnier verwendete DUELs veröffentlichte Produktionsgewichte (Umsatzwachstum 16 %, Operative Cash-Marge 15 %, ROIC 15 %, Sloan Ratio 12 %, Asset Turnover 10 %, Receivables Turnover 8 %, Operative Marge 12 %, FCF-Marge 12 %). Diese Gewichte sind eine vernünftige, offengelegte Wahl — aber nicht die einzig vernünftige. Nach der Methode unseres früheren Beitrags [Fragile Score] haben wir dieselben Vier-Unternehmen-Matchups unter zwei alternativen, ebenso vertretbaren Gewichtungsschemata erneut durchlaufen lassen und geprüft, ob das Ranking dies übersteht.
Gleichgewichtung (alle acht Faktoren bei 12,5 %): Der Sieger jedes Matchups bleibt derselbe wie unter den Produktionsgewichten, aber AMAT und LRCX landen in einem exakten Gleichstand um Platz eins — beide erzielen einen Durchschnitt von 70,8 über ihre drei Matchups.
Qualitätsgewichtete Gewichte (ROIC und Sloan Ratio auf 25 % bzw. 20 % erhöht, was einen Leser widerspiegelt, dem Kapitaleffizienz und Ertragsqualität wichtiger sind als Umschlagskennzahlen; Asset Turnover und Receivables Turnover auf je 5 % gesenkt; Wachstums- und Margenfaktoren nahe ihren ursprünglichen Gewichten belassen): AMAT rückt eindeutig auf Platz eins vor (Ø 71,7 gegenüber LRCXs 65,0) — das Nummer-1-Ranking kippt. Das TER-gegen-ONTO-Matchup, ein knappes 53–47 unter Produktionsgewichten, wird unter beiden alternativen Schemata zu einem exakten 50–50-Unentschieden.
| Ranking | Produktionsgewichte | Gleichgewichte | Qualitätsgewichtete Gewichte |
|---|---|---|---|
| #1 | LRCX (71,3) | AMAT / LRCX (Gleichstand, 70,8) | AMAT (71,7) |
| #2 | AMAT (69,3) | — | LRCX (65,0) |
| #3 | ONTO (37,7) | ONTO (37,5) | ONTO (40,0) |
| #4 | TER (21,7) | TER (20,8) | TER (23,3) |
Die unteren beiden Positionen sind unter jedem getesteten Gewichtungsschema stabil — TER und ONTO bleiben deutlich hinter den Führenden zurück, egal wie die acht Faktoren gewichtet werden, obwohl ihr eigenes Kopf-an-Kopf-Ergebnis zwischen einem knappen TER-Sieg und einem exakten Unentschieden oszilliert. Die Spitzenposition ist nicht stabil — sie hängt spezifisch davon ab, wie viel Gewicht ein gegebener Vergleich auf Kapitaleffizienz- und Ertragsqualitätsfaktoren (ROIC, Sloan) versus Umschlags- und Wachstumsfaktoren legt. Das ist kein Fehler in DUELs Methodik — jedes veröffentlichte Gewicht ist offengelegt und die Formel ist transparent — es ist eine Eigenschaft der Aggregation von acht verschiedenen Fundamentalsignalen in eine einzige Zahl für ein wirklich knappes Paar. Ein fünf Jahrzehnte altes Ergebnis der Social-Choice-Theorie (Arrow, 1951) zeigt, dass die Aggregation mehrerer geordneter Kriterien zu einer einzigen Rangfolge inhärent sensibel auf die gewählte Aggregationsregel reagiert, sobald mehr als zwei Optionen auf mehr als einer Dimension verglichen werden; das Kippen der Top-zwei-Positionen in diesem Korb ist eine kleine, konkrete Illustration genau dieser strukturellen Sensibilität, kein Defekt, der spezifisch für diesen Vergleich ist.
Teil 7 — Was das tatsächlich beantwortet, und was nicht
Dieser Beitrag sagt nicht und kann nicht sagen, ob die Ausgaben für Halbleiter-Fertigungsausrüstung weiter wachsen werden, ob die Bestellungen für Wafer-Fab-Ausrüstung in den nächsten Quartalen stark bleiben werden, oder welches dieser fünf Unternehmen die anderen operativ übertreffen wird. Das sind zukunftsgerichtete Fragen, und jede Zahl oben beschreibt nur Vergangenheit und Gegenwart.
Was die Daten aus sich selbst heraus zeigen: Innerhalb dieses Fünf-Unternehmen-Oligopols weisen relative Stärke (das Rundenturnier-Ranking), Bewertung (das DCF-Aufwärtspotenzial) und Bilanzresilienz (der FRI) auf drei verschiedene Unternehmen als „Sieger" hin, je nachdem welche Linse angewendet wird — LRCX bei relativer Stärke (knapp, und nur unter einem vernünftigen Gewichtungsschema), TER beim modellierten Aufwärtspotenzial und ONTO bei der Resilienz. Es zeigt auch direkt und reproduzierbar, dass die Antwort auf „wer ist am stärksten" in einem eng zusammenliegenden Oligopol keine feste, einmal zu messende Tatsache ist — sie ist eine Funktion einer Gewichtungsentscheidung, die eine transparente Methodik explizit machen muss, statt sie zu verbergen.
Einschränkungen
KLAC ist von der Rundenturnier-Rekonstruktion in Teil 3 ausgeschlossen. Das Duell vom 26. Juli 2026, das KLACs Daten lieferte, erfasste weder seinen Asset Turnover noch seinen Receivables Turnover, zwei der acht gewichteten Faktoren, sodass seine Kopf-an-Kopf-Bilanz gegen AMAT, TER und ONTO nicht mit vollständigen Inputs rekonstruiert werden konnte. KLACs FRI- und DCF-Ergebnisse (Teile 4–5) hängen nicht von diesen beiden Faktoren ab und sind davon nicht betroffen.
KLACs operative Marge und ROIC wirken in dieser Momentaufnahme ungewöhnlich niedrig im Vergleich zur typischen historischen Spanne dieses Unternehmens und zur eigenen FCF-Marge im selben Report, was eher zu einem Periodenausrichtungs-Artefakt passt als zu einer echten Verschlechterung. Wir berichten die Zahlen, wie sie erzeugt wurden, statt einen angenommenen „normalen" Wert einzusetzen.
LRCX und KLAC stammen aus unterschiedlichen Meldungs-Momentaufnahmen (18. August bzw. 26. Juli 2026), und LRCXs eigene gemeldete Zahlen bewegten sich zwischen diesen beiden Daten erheblich, als eine neue Quartalsmeldung verfügbar wurde. Wir verwendeten durchgehend die aktuelleren LRCX-Daten, statt eine ältere LRCX-Momentaufnahme mit KLACs zu vermischen.
Die Rundenturnier-Rekonstruktion setzt voraus, dass DUELs veröffentlichte Gewichtungsformel genau wie dokumentiert angewendet wird. Wir überprüften dies anhand zweier bekannter Outputs (AMAT vs. TER und ONTO vs. LRCX) und reproduzierten beide exakt, bevor wir die Methode auf die vier unbestätigten Paarungen ausdehnten; wir haben nicht jeden rekonstruierten Score unabhängig gegen ein Live-Duell erneut überprüft.
Fünf Unternehmen sind eine diagnostische Momentaufnahme eines echten Oligopols, keine statistische Stichprobe. Der Gewichtungssensitivitäts-Befund in Teil 6 beschreibt diesen spezifischen Korb zu dieser spezifischen Momentaufnahme; es ist keine Behauptung, dass DUELs Rankings über die Hunderte anderer Duelle auf der Seite hinweg generell instabil sind — die meisten davon sind, wie unser früherer Fragile-Score-Beitrag feststellte, nicht so knapp beieinander.
Kein Marktpreis, absichtlich. DUELs DCF-Engine ignoriert den aktuellen Aktienkurs und Analystenschätzungen, was genau das ist, was „wie viel Wachstum die eigene Flugbahn eines Unternehmens bereits unterstellt" zu einer sauberen, überprüfbaren Frage macht, statt zu einem Vergleich mit der aktuellen Marktbewertung.
Fazit
Innerhalb des Fünf-Unternehmen-Oligopols, das die Werkzeuge baut, von denen die Chiphersteller selbst abhängen, gewinnt kein einzelnes Unternehmen bei jedem Maßstab. LRCX hat die stärkste Kapitaleffizienz und — unter der eigenen Produktionsgewichtung der Seite — die stärkste Kopf-an-Kopf-Bilanz, aber auch die einzige Ertragsqualitäts-Vorsichtsmarkierung der Gruppe und den niedrigsten Resilienzwert. TER hat die schwächste Rundenturnier-Bilanz, aber den meisten verbleibenden Spielraum in DUELs eigener Bewertungsmathematik. ONTO, das kleinste Unternehmen hier, hat die sauberste Bilanz und einen perfekten Resilienzwert, während es bei relativer Stärke im Mittelfeld liegt. Und die Spitzenposition des Rundenturniers selbst — LRCX vor AMAT — ist keine feste Tatsache: Sie kippt zu AMAT unter einer anders gewichteten, ebenso vertretbaren Lesart derselben acht Zahlen. Nichts davon ist eine Prognose über den Halbleiterausrüstungszyklus. Es ist das, was die eigenen Meldungen von fünf Unternehmen sagen, auf die gleiche Weise verarbeitet, aus mehr als einem vernünftigen Blickwinkel.
Jede Zahl in diesem Beitrag lässt sich auf ein Duell zurückführen, das Sie selbst auf duelstocks.com abrufen und erneut überprüfen können.
Weiterführende Lektüre — Gleiche Serie, gleiche Methode
Dieser Beitrag baut direkt auf der Methodik auf, die in den vorherigen Beiträgen dieser Serie etabliert wurde, die Sie auf dieser Seite nachlesen können.
Quellen
Arrow, K. J. (1951). Social Choice and Individual Values. Wiley.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3. Aufl.). Wiley.
U.S. Securities and Exchange Commission — EDGAR-Volltextsuche und strukturierte XBRL-Meldedaten, sec.gov.
Eine methodische Tiefenanalyse von DuelStocks. Keine Anlageberatung. Alle Daten stammen aus öffentlichen SEC-EDGAR-Meldungen.
Eine DuelStocks-Fundamentalanalyse. Keine Anlageberatung — und, wie der Rest dieser Serie, auch keine Prognose. Alle folgenden Zahlen stammen aus öffentlichen SEC-EDGAR-Meldungen (10-K/10-Q), verarbeitet durch DUELs Battle-, DCF- und Resilience-(STR)-Reports.
Der „Picks and Shovels"-Rahmen für KI-Infrastruktur hat einen blinden Fleck: Er hört meist beim Rack auf. Chips, Networking und Strom/Kühlung auf Rack-Ebene bekommen die Schlagzeilen, aber jedes dieser Racks muss trotzdem an etwas angeschlossen werden — Erzeugungskapazität, Übertragung und Verteilung, und die Elektro-Bauunternehmen, die die physische Verbindung tatsächlich errichten. Das ist eine andere Kette, mit einer anderen Kapitalstruktur, und — wie dieser Beitrag zeigen wird — mit einem deutlich anderen Resilienzprofil als jenem, das wir in [Wer verkauft eigentlich die Schaufeln?] kartiert haben.
Dies ist eine direkte Fortsetzung, keine Wiederholung. Zwei Namen übernehmen wir aus jenem Beitrag — ETN und VRT —, weil sie genau an der Grenze zwischen „Strom auf Rack-Ebene" und „Strom auf Netzebene" sitzen und ihr Fehlen hier eine Lücke in der Kette hinterlassen würde. Alles andere ist neu. Die Frage bleibt dieselbe, die wir in der gesamten Serie stellen: nicht, wohin sich der Zyklus entwickelt, sondern was die bereits verbuchten Zahlen darüber aussagen, wer den Ausbau gerade tatsächlich für sich vereinnahmt — und wie viel davon bereits in DUELs eigener Bewertungsmathematik eingepreist ist.
Was sagen die bereits eingereichten 10-K/10-Q-Meldungen darüber aus, wer in der US-notierten „Strom für KI"-Kette gerade Wachstum, Marge und Bilanzstärke für sich beansprucht — und wie viel davon ist bereits in DUELs DCF-Mathematik abgebildet, ganz ohne Prognose des Lastwachstums?
Teil 1 — Den Korb zusammenstellen
Ein KI-Rechenzentrum mit Strom zu versorgen, ist kein einzelnes Geschäft. Es sind mindestens drei: das Unternehmen, das den Strom erzeugt oder beschafft, das Unternehmen, das die Schaltanlagen, Transformatoren und das Thermomanagement zwischen Netz und Servern herstellt, und das Unternehmen, das die Umspannwerke, Übertragungsleitungen und Elektroräume physisch baut und verkabelt, die beides verbinden. Wir haben einen Zehn-Unternehmen-Korb über diese drei Schichten aufgebaut, plus dieselben vier Hyperscale-Käufer, die im vorherigen Beitrag als Kontrollgruppe dienten:
- Erzeugung / Versorger: VST, CEG, NEE, SO
- Strom / Industrie (Netz-zu-Gebäude-Elektrotechnik): ETN, VRT, EMR, ROK
- Bau / Elektro- und Übertragungs-/Verteilungsauftragnehmer: PWR, EME
- Käufer (Kontrollgruppe, nicht als „Profiteure" bewertet): MSFT, GOOGL, AMZN, META
Das sind zehn einzigartige Angebotsseiten-Namen und vier Käufer — 14 Unternehmen insgesamt, jedes durch DUELs Battle Report, DCF Report und Resilience Report geführt, genau wie jedes andere Duell auf der Seite. Die zehn neuen Duelle hinter diesem Beitrag wurden am 17. August 2026 erzeugt. Die vier Käuferprofile wurden aus dem Zeitfenster 26. Juli–13. August 2026 des vorherigen Beitrags übernommen — DUELs Outputs pro Unternehmen sind unabhängig vom Gegner, was die Vergleichbarkeit nicht beeinträchtigt, aber die zugrunde liegenden Meldungs-Momentaufnahmen liegen einige Wochen auseinander, was klar benannt werden sollte.
Teil 2 — Wachstum und Marge: Wo das Kapital tatsächlich landet
| Ticker | Schicht | Umsatzwachstum (3J CAGR) | FCF-Marge | Operative Marge | ROIC | Sloan Ratio |
|---|---|---|---|---|---|---|
| VST | Erzeugung | 4,31 % | 7,43 % | 10,75 % | 5,80 % | -3,42 % |
| CEG | Erzeugung | 1,47 % | 5,04 % | 12,09 % | 4,16 % | 3,02 % |
| NEE | Erzeugung | -3,05 % | 11,67 % | 58,08 % | 4,21 % | 0,23 % |
| SO | Erzeugung | 0,31 % | -9,93 % | 24,65 % | 5,07 % | -3,20 % |
| ETN | Strom/Industrie | 9,77 % | 12,94 % | 13,39 % | 6,83 % | 15,80 % |
| VRT | Strom/Industrie | 21,59 % | 18,51 % | 17,89 % | 27,99 % | -2,80 % |
| EMR | Strom/Industrie | -2,82 % | 14,80 % | k. A. | k. A. | -1,98 % |
| ROK | Strom/Industrie | 2,44 % | 16,58 % | 20,41 % | 20,37 % | -2,49 % |
| PWR | Bau/Übertragung | 18,60 % | 5,69 % | 5,66 % | 8,30 % | -0,70 % |
| EME | Bau/Übertragung | 15,32 % | 6,77 % | 10,09 % | 40,70 % | -4,33 % |
Das Erste, was diese Tabelle zeigt: „Strom" ist keine einzelne Wachstumsgeschichte — es sind mindestens drei unkorrelierte. Die Erzeugungs-/Versorgerschicht wächst kaum auf nachlaufender Basis: VST (4,31 %), CEG (1,47 %), SO (0,31 %) und NEE (-3,05 %) — ein reguliertes, stark vertragsgebundenes, kapitalzyklisches Geschäft, dessen Umsatz sich schlicht nicht so bewegt wie Chip- oder Networking-Umsatz, unabhängig davon, wie viel zusätzliche Nachfrage in Interconnection-Warteschlangen auftaucht. Die Strom-/Industrieausrüstungsschicht ist das Gegenteil: VRT wächst den Umsatz mit 21,59 % — näher an den KI-Infrastrukturnamen aus dem vorherigen Beitrag als an den eigenen Sektor-Peers —, während ETN (9,77 %) und ROK (2,44 %) deutlich langsamer wachsen und EMR auf nachlaufender Basis sogar schrumpft (-2,82 %). Die Bau-/Übertragungsschicht liegt dazwischen, tendiert aber nach oben — PWR (18,60 %) und EME (15,32 %) —, was zu einem physischen Ausbauboom in genau dem Teil der Kette passt, der tatsächlich Beton gießt und Kabel zieht.
Die Marge erzählt eine zweite, separate Geschichte. VRTs FCF-Marge von 18,51 % und ROIC von 27,99 % sehen aus wie ein Infrastruktur-Zulieferer-Margenprofil, nicht wie ein Versorger-Profil — strukturell näher an der Compute-/Networking-Schicht des vorherigen Beitrags als am eigenen „Strom"-Label. SOs FCF-Marge ist negativ (-9,93 %): CAPEX läuft derzeit dem operativen Cashflow voraus — ein Muster, das sich über die gesamte Erzeugungsschicht wiederholt und, wie Teil 3 unten zeigt, reale Konsequenzen für die DCF-Modellierung hat. NEEs operative Marge von 58,08 % sollte eher als Ausreißer markiert als für bare Münze genommen werden — regulierte Versorger-Buchhaltung (Anerkennung genehmigter Renditen, aufgeschobene regulatorische Vermögenswerte) kann operative Margenwerte erzeugen, die Faktor für Faktor nicht mit denen eines Industrie- oder Softwareunternehmens vergleichbar sind, auch wenn dieselbe Formel (Operatives Ergebnis / Umsatz) identisch angewendet wird. Wir legen das offen, statt es zu glätten.
Teil 3 — Wie viel Wachstum bereits im Preis steckt
Hier gehen die beiden Hälften dieses Korbs deutlich auseinander — und hier werden die eigenen Modellannahmen selbst Teil des Befunds. DUELs DCF-Engine baut einen fairen Wert und eine 3-Jahres-Kursprojektion allein aus den eigenen Meldungen jedes Unternehmens auf: kein Marktpreis als Input, keine Analysten-Wachstumsschätzungen, nur Umsatz-CAGR, FCF, ROIC und Sloan Ratio, verarbeitet durch eine feste Formel (vollständige Methodik in unserem früheren [Beitrag zum DCF-Konfidenzband]).
| Ticker | Fair Value (T0) | Modelliert +3J Kurs | Modelliertes 3J-Aufwärtspotenzial |
|---|---|---|---|
| VST | 30,74 $ | 43,55 $ | 41,7 % |
| EMR | 45,99 $ | 59,51 $ | 29,4 % |
| ROK | 190,30 $ | 229,33 $ | 20,5 % |
| ETN | 184,92 $ | 216,43 $ | 17,0 % |
| PWR | 270,35 $ | 316,30 $ | 17,0 % |
| EME | 641,92 $ | 749,20 $ | 16,7 % |
| VRT | 203,50 $ | 226,82 $ | 11,5 % |
| CEG | 0,00 $* | 11,21 $ | Modellgrenze — siehe unten |
| NEE | 0,00 $* | 2,25 $ | Modellgrenze — siehe unten |
| SO | 0,00 $* | -8,03 $ | Modellgrenze — siehe unten |
Sieben von zehn Namen liefern eine gewöhnliche, interpretierbare Aufwärtspotenzial-Zahl, von VRTs 11,5 % (dieselbe Zahl wie im vorherigen Beitrag — eine Bestätigung, dass die Outputs pro Unternehmen tatsächlich gegneruabhängig sind) bis zu VSTs 41,7 %. Aber drei Namen — CEG, NEE und SO, alle in der Erzeugungs-/Versorgerschicht — tun das nicht. Das ist der Hauptbefund dieses Beitrags, und er verdient eine präzise Formulierung statt einer glattgebügelten „niedriges Aufwärtspotenzial"-Schublade.
Was tatsächlich passiert: DUELs DCF definiert FCF als CFO minus CAPEX. Bei allen drei Unternehmen ist der aktuelle CAPEX im Verhältnis zum operativen Cashflow groß genug (bei SO übersteigt er ihn sogar), sodass das Fortschreiben dieser FCF-Basis nach der festen Modellformel den modellierten Unternehmenswert unter die Gesamtverschuldung drückt. Das Modell meldet keinen negativen fairen Wert; es deckelt den angezeigten Eigenkapitalwert bei 0,00 $ und markiert den Fall explizit („Gesamtverschuldung übersteigt den modellierten Unternehmenswert... signalisiert erhebliches Bilanzrisiko, keine präzise Bewertung"). SOs Fall ist der extremste: Seine modellierte 3-Jahres-Kurstrajektorie ist negativ (0,00 $ → -2,67 $ → -5,34 $ → -8,03 $), weil seine FCF-Basis selbst negativ ist und das Modell keinen Mechanismus hat, um „vorübergehend negativen FCF während eines regulatorisch genehmigten Ausbauzyklus" von „strukturell cash-verbrennendem Geschäft" zu unterscheiden. Beides würde denselben Output erzeugen.
Das ist keine Behauptung, dass Vistra, Constellation, NextEra oder Southern überschuldet oder schlecht geführt sind — regulierte und quasi-regulierte Erzeugungsversorger finanzieren routinemäßig mehrjährige Investitionsprogramme mit Fremdkapital gegen eine Regulierungsbasis oder langfristig kontrahierte Cashflows, für die ein reines nachlaufendes-FCF-DCF nie konzipiert war. Es ist ein Befund über das Modell, ehrlich angewendet: eine Discounted-Cashflow-Engine, kalibriert auf CFO minus CAPEX, ohne Behandlung von Regulierungsbasis, regulatorischen Vermögenswerten oder Dividendendiskontierung, kann für diese Art von Bilanz strukturell keinen brauchbaren fairen Wert liefern. Wir legen diese Grenze lieber klar offen, als eine Zahl zu erzwingen, die mehr Präzision suggeriert, als das Modell leisten kann.
Teil 4 — Wer tatsächlich die Bilanz-Rüstung hat
| Ticker | FRI-Score | Stufe | Wachstum vs. FCF | ROIC vs. Sloan | Verschuldung vs. Cash |
|---|---|---|---|---|---|
| EMR | 100 | HOCH | OK | OK | OK (siehe Datenvollständigkeitshinweis) |
| VRT | 94 | HOCH | OK | OK | OK |
| PWR | 76 | HOCH | VORSICHT | OK | OK |
| EME | 64 | MODERAT | VORSICHT | OK | OK |
| ETN | 68 | MODERAT | OK | OK | RISIKO |
| CEG | 53 | MODERAT | OK | OK | VORSICHT |
| ROK | 50 | MODERAT | OK | OK | VORSICHT |
| VST | 49 | MODERAT | OK | OK | RISIKO |
| NEE | 44 | MODERAT | OK | OK | RISIKO |
| SO | 42 | MODERAT | OK | OK | RISIKO |
Diese Tabelle ist der schärfste Kontrast zum vorherigen Beitrag. Im Chip-/Networking-/Kühlungskorb bestanden 55 % der Unternehmen alle drei internen Konsistenzprüfungen sauber mit OK/OK/OK. Hier tun das nur zwei von zehn — VRT und, mit Vorbehalt unten, EMR. Jeder der vier Erzeugungs-/Versorgernamen trägt eine Verschuldung-vs-Cash-Markierung, und drei der vier tragen die schwerere RISIKO- statt VORSICHT-Stufe. Das deckt sich direkt mit Teil 3: Dieselbe fremdfinanzierte Kapitalintensität, die CEGs, NEEs und SOs DCF-Fair-Values bei 0,00 $ deckelt, treibt hier auch ihre Verschuldung-vs-Cash-Markierungen. Die beiden Befunde sind keine unabhängigen Entdeckungen — es ist dieselbe zugrunde liegende Bilanzstruktur, die in zwei verschiedenen Teilen von DUELs Modell auftaucht.
EMRs Spitzen-FRI von 100 braucht einen eigenen Vorbehalt, im selben Geist wie GEVs im vorherigen Beitrag. Sein Resilience Report zeigt mehrere rohe Bilanzkomponenten — Cash, Gesamtverschuldung, operatives Ergebnis, Eigenkapital — als im erfassten Meldungszeitraum nicht verfügbar („—"), sodass nur der Investment-Self-Sufficiency-(FCF/CAPEX)-Teilwert berechnet werden konnte; die anderen drei Teilmetriken (Cash-to-Debt, Earnings Quality, Liquidity Runway) konnten überhaupt nicht bewertet werden. Eine 100, die auf nur einer von vier befüllten Teilmetriken beruht, ist eine andere Art von 100 als VRTs, die auf vier vollständig befüllten und sauber bewerteten Teilmetriken beruht. Die wahrscheinlichste Erklärung ist eine Diskrepanz beim Geschäftsjahr — Emersons Geschäftsjahr endet im September statt im Dezember, was bestimmte XBRL-getaggte Felder im Vergleich zu Kalenderjahr-Peers zu einem gegebenen Zeitpunkt spärlicher befüllt lassen kann —, aber bis ein Meldungszeitraum mit vollständigen Daten erfasst wird, sollte EMRs FRI als vorläufig statt als endgültig gelesen werden.
PWR und EME tragen beide eine einzelne VORSICHT-Markierung bei Wachstum vs. FCF: Beide wachsen den Umsatz im mittleren bis oberen Zehnprozentbereich (18,60 % bzw. 15,32 %), während die FCF-Marge im mittleren einstelligen Bereich liegt (5,69 % bzw. 6,77 %) — eine unkomplizierte Cash-Konversions-Verzögerungsmarkierung, typisch für Auftragnehmer, die Personal und Working Capital vor der Rechnungsstellung skalieren, kein Rechnungslegungsqualitätsproblem.
Teil 5 — Die Scorecard: Aufwärtspotenzial vs. Resilienz
Teil 3 und Teil 4 auf eine gemeinsame Seite gebracht, sortiert die sieben Namen mit interpretierbarem DCF-Output in ein 2×2-Raster. Der Trennpunkt auf jeder Achse ist der Median über nur diese sieben Namen (Aufwärtspotenzial-Median 17,0 %, FRI-Median 68) — CEG, NEE und SO sind aus diesem Raster vollständig ausgeklammert, statt in einen Quadranten gezwungen zu werden, den ihr modellierter fairer Wert tatsächlich nicht stützt; sie erhalten unten eine eigene Kategorie.
Attraktiv bepreist und strukturell solide: EMR, PWR (beide über dem FRI-Median; PWRs Aufwärtspotenzial liegt fast genau auf der 17,0-%-Medianlinie)
Modelliertes Aufwärtspotenzial, dünnerer Puffer: VST, ROK (über dem Aufwärtspotenzial-Median, unter dem Resilienz-Median)
Bereits eingepreist, aber kerngesund: VRT (unter dem Aufwärtspotenzial-Median, aber der höchste vollständig befüllte FRI im Korb)
Bereits eingepreist, vergleichsweise dünnerer Puffer: EME
Genau auf der Kreuzung: ETN — sein Aufwärtspotenzial von 17,0 % und FRI von 68 landen fast exakt auf beiden Medianlinien, was es zum Angelpunkt dieses Korbs macht statt zum sauberen Mitglied eines Quadranten.
Modellgrenz-Fälle (aus dem Raster ausgeklammert): CEG, NEE, SO — siehe Teil 3. Alle drei tragen eine Verschuldung-vs-Cash-RISIKO- oder VORSICHT-Markierung in Teil 4 und einen modellierten fairen Wert von 0,00 $ in Teil 3; zusammen gelesen ist das das eindeutigste Signal in diesem Korb, und es gehört spezifisch zur Erzeugungs-/Versorgerschicht, nicht zu Strom/Industrie oder Bau/Übertragung.
Der Kontrast zur Scorecard des vorherigen Beitrags ist selbst ein Befund. Dort landeten nur zwei von elf Namen im am wenigsten günstigen Quadranten, und keiner der elf brach das DCF-Modell vollständig. Hier brechen drei von zehn Namen das Modell vollständig, noch bevor ein Quadranten-Gespräch überhaupt möglich ist, und sie konzentrieren sich auf genau eine Schicht der Kette — Erzeugung. Die „Strom für KI"-Geschichte ist auf Fundamentaldaten-Ebene keine einzelne Geschichte; es ist eine resiliente Ausrüstungs-/Auftragnehmerschicht, die auf einer stark fremdfinanzierten Erzeugungsschicht sitzt.
Teil 6 — Die Kontrollgruppe: Wie die Käufer aussehen
| Ticker | Modelliertes 3J-Aufwärtspotenzial | FRI-Score | Stufe |
|---|---|---|---|
| GOOGL | 20,6 % | 85 | HOCH |
| AMZN | 18,6 % | 100 | HOCH |
| MSFT | 18,6 % | 81 | HOCH |
| META | 16,2 % | 83 | HOCH |
Alle vier Hyperscale-Käufer landen in DUELs HOCH-Resilienzstufe — dasselbe Ergebnis wie im vorherigen Beitrag, und dieselben Zahlen, wiederverwendet statt neu erzeugt (siehe Hinweis zum wiederverwendeten Zeitfenster in Teil 1). Was diesmal anders ist, ist der Kontrast auf der anderen Seite der Transaktion. In Shovels reichten die elf Chip-/Networking-/Kühlungslieferanten von FRI 11 bis 100 mit einem Median von 75 — nahe an der eigenen 81–100-Spanne der Käufer. Hier reichen die zehn Stromketten-Lieferanten von FRI 42 bis 100 mit einem Median von 68, und drei von ihnen bestehen DUELs DCF-Modell überhaupt nicht. Die Käufer, die diesen Ausbau finanzieren, sitzen nach diesem Maßstab auf deutlich stärkeren Bilanzen als die Erzeugungsseiten-Unternehmen, die den Strom dafür tatsächlich bauen.
Teil 7 — Was das tatsächlich beantwortet, und was nicht
Um bei den Grenzen dieser Übung präzise zu bleiben, da eine Überinterpretation hier den gesamten Sinn untergraben würde: Dieser Beitrag sagt nicht und kann nicht sagen, ob die US-Netzkapazität mit dem KI-getriebenen Lastwachstum Schritt halten wird, ob bestimmte Erzeugungs- oder Übertragungsprojekte planmäßig gebaut werden, oder ob die Investitionspläne dieser Unternehmen erfolgreich sein werden. Das sind zukunftsgerichtete Fragen, und jede Zahl oben beschreibt nur Vergangenheit und Gegenwart.
Was die Daten aus sich selbst heraus zeigen: Wachstum und Marge in dieser Kette sind tatsächlich drei separate, übereinandergelagerte Geschichten — eine langsam wachsende, kapitalintensive Erzeugungsschicht; eine schnell wachsende, margenstarke Ausrüstungsschicht; und eine schnell wachsende, margenschwache Bauschicht. Es zeigt auch, dass Resilienz, auf dieselbe Weise über alle 14 Unternehmen in diesem und dem vorherigen Beitrag gemessen, in dieser Kette ungleich verteilt ist — konzentriert in der Ausrüstungsschicht und größtenteils abwesend in der Erzeugungsschicht, wo DUELs DCF-Modell für drei von vier Namen vollständig zusammenbricht. Das ist eine Aussage über die Bilanzstruktur dieser spezifischen Unternehmen heute, verarbeitet durch ein spezifisches Modell, keine Vorhersage über den Strommarkt von morgen.
Einschränkungen
Drei von zehn Namen lieferten keinen brauchbaren DCF-Fair-Value. CEG, NEE und SO stießen alle an DUELs Modellgrenze (angezeigter Eigenkapitalwert von 0,00 $, volles Detail in Teil 3). Das spiegelt eine Diskrepanz zwischen der festen CFO-minus-CAPEX-FCF-Definition des Modells und der fremdfinanzierten, regulierungsbasis-getriebenen Kapitalstruktur wider, die für regulierte und quasi-regulierte Erzeugungsversorger typisch ist — keine Behauptung über die tatsächliche finanzielle Gesundheit oder das Investmentprofil dieser Unternehmen.
EMRs Resilienzwert basiert auf unvollständigen Rohdaten, direkt in Teil 4 markiert — drei von vier Teilmetriken konnten im erfassten Meldungszeitraum nicht berechnet werden, höchstwahrscheinlich aufgrund einer Diskrepanz beim Geschäftsjahresende (September bei Emerson gegenüber Dezember bei den meisten Peers). Sein FRI von 100 sollte als vorläufig behandelt werden, bis ein Meldungszeitraum mit vollständigen Bilanzdaten erfasst wird.
Momentaufnahme, keine Live-Rangliste, und kein einzelnes Zeitfenster. Die zehn Angebotsseiten-Duelle wurden am 17. August 2026 erzeugt. Die vier Käuferprofile wurden aus dem Zeitfenster 26. Juli–13. August 2026 des vorherigen Beitrags dieser Serie übernommen; DUELs Outputs pro Unternehmen hängen nicht vom Gegner ab, aber die zugrunde liegenden Meldungs-Momentaufnahmen liegen mehrere Wochen auseinander.
Kein Marktpreis, absichtlich — und das wirkt in beide Richtungen. DUELs DCF-Engine ignoriert bewusst den aktuellen Aktienkurs und Analystenschätzungen, was genau das ist, was „wie viel Wachstum die eigene Flugbahn eines Unternehmens bereits unterstellt" zu einer sauberen, überprüfbaren Frage macht. Es bedeutet auch, dass das „modellierte Aufwärtspotenzial" hier keine marktimplizite Erwartung ist und nicht als solche gelesen werden sollte.
Die Korbzusammenstellung ist eine Ermessensentscheidung, keine Vollerhebung. Zehn Angebotsseiten-Namen und vier Käufer sind ein vernünftiger Querschnitt der US-notierten KI-Stromkette, kein erschöpfender; ein anderer, ebenso vernünftiger Korb könnte verschieben, welche Namen in welchem Teil dieser Analyse landen.
Vierzehn Unternehmen sind eine diagnostische Momentaufnahme, keine statistische Stichprobe — lesen Sie die obigen Muster als beschreibend, nicht als über diesen spezifischen Korb hinaus verallgemeinerbare Evidenz.
Fazit
Über zehn Unternehmen, die Strom für KI-Infrastruktur liefern, und vier der Hyperscale-Käufer, die diesen Ausbau finanzieren, teilen sich Wachstum und Marge sauber in drei separate Geschichten nach Schicht auf — langsame, kapitalintensive Erzeugung; schnelle, margenstarke Ausrüstung; schnelle, margenschwache Bauwirtschaft. Die Resilienz teilt sich noch schärfer auf: Die Ausrüstungsschicht sieht wie der stärkste Teil der gesamten KI-Infrastrukturkette aus, die über beide bisherigen Beiträge dieser Serie untersucht wurde, während drei von vier Erzeugungs-/Versorgernamen eine echte Leverage-Markierung tragen und keiner der drei einen brauchbaren DCF-Fair-Value unter DUELs Modell liefert. Nichts davon ist eine Prognose über Netzausbau, Lastwachstum oder welche Projekte finanziert werden. Es ist das, was die Meldungen bereits sagen, verarbeitet durch dieselbe Formel für jedes Unternehmen im Raum — einschließlich einer ehrlichen Darstellung, wo diese Formel aufhört zu funktionieren.
Jede Zahl in diesem Beitrag lässt sich auf ein Duell zurückführen, das Sie selbst auf duelstocks.com abrufen und erneut überprüfen können.
Weiterführende Lektüre — Gleiche Serie, gleiche Methode
Dieser Beitrag ist eine direkte Fortsetzung der Methodik, die in den vorherigen Beiträgen dieser Serie etabliert wurde, die Sie auf dieser Seite nachlesen können.
Quellen
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3. Aufl.). Wiley.
Damodaran, A. (2018). Valuing regulated and capital-intensive businesses: why standard DCF assumptions break down for rate-based utilities. NYU Stern School of Business, Arbeitsnotiz.
U.S. Securities and Exchange Commission — EDGAR-Volltextsuche und strukturierte XBRL-Meldedaten, sec.gov.
Eine methodische Tiefenanalyse von DuelStocks. Keine Anlageberatung. Alle Daten stammen aus öffentlichen SEC-EDGAR-Meldungen.
Eine DuelStocks-Fundamentalanalyse. Keine Anlageberatung — und, anders als die meisten Kommentare zum KI-Zyklus, auch keine Prognose. Alle folgenden Zahlen stammen aus öffentlichen SEC-EDGAR-Meldungen (10-K/10-Q), verarbeitet durch DUELs Battle-, DCF- und Resilience-(STR)-Reports.
Fragen Sie zehn Menschen, ob sich der Ausbau der KI-Infrastruktur in einer frühen, mittleren oder späten Phase befindet, und Sie erhalten zehn selbstbewusste Antworten und null gemeinsame Evidenz. Das liegt daran, dass die Frage, so wie sie meist gestellt wird, eine Prognosefrage ist — „wie viel Capex kommt noch" — und Prognosen sind nicht das, was dieses Tool leistet oder zu leisten behauptet. DUEL hat keine Meinung zu künftigen KI-Ausgaben, keine Analystenschätzungen und kein Makromodell.
Was DUEL tatsächlich hat, ist etwas Engeres und besser Überprüfbares: eine standardisierte Auswertung dessen, was die bereits veröffentlichten Finanzzahlen der Unternehmen, die KI-Infrastruktur bauen, über Wachstum, Marge, Kapitaleffizienz, Bewertungsmathematik und Bilanzresilienz aussagen — alle aus derselben Quelle stammend (SEC-Meldungen) und für jedes beteiligte Unternehmen durch dieselben Formeln laufend. Statt also zu fragen „wo stehen wir im Zyklus", stellt dieser Beitrag eine Version dieser Frage, die DUEL tatsächlich mit Daten statt mit Meinung beantworten kann:
Was sagen die bereits verbuchten Zahlen darüber aus, wer den Ausbau der KI-Infrastruktur gerade tatsächlich für sich vereinnahmt — und wie viel davon ist bereits in DUELs eigener Bewertungsmathematik eingepreist?
Teil 1 — Den Korb zusammenstellen
„Picks and Shovels" (Spitzhacken und Schaufeln) ist der naheliegende Rahmen für Investments in KI-Infrastruktur: Statt darauf zu wetten, welche KI-Anwendung gewinnt, kauft man die Unternehmen, die Compute, Networking, Strom und Speicher liefern, die jede KI-Workload braucht — unabhängig davon, wer gewinnt. Wir haben einen Korb über vier Angebotsschichten aufgebaut, plus eine fünfte Gruppe, die auf der anderen Seite der Transaktion steht — die Hyperscale-Käufer — als Kontrollgruppe, nicht als Gruppe von „Profiteuren":
- Compute: NVDA, AMD, AVGO, MU
- Networking / Interconnect: ANET, CIEN
- Strom & Kühlung: VRT, ETN, MOD, GEV
- Speicher: MU (geteilt mit Compute), WDC
- Käufer (Kontrollgruppe, nicht als „Profiteure" bewertet): MSFT, GOOGL, AMZN, META
Ein Name fehlt auffällig. TSM wurde vollständig ausgeschlossen. Als in Taiwan ansässiger „Foreign Private Issuer" reicht TSMC bei der SEC einen 20-F-Jahresbericht ein, keinen 10-K, und reicht auch keine 10-Qs ein. DUELs gesamtes Modell basiert ausschließlich und bewusst auf 10-K/10-Q-Daten — ein Unternehmen, das strukturell diese Formulare nicht einreicht, liegt also außerhalb dessen, was dieses Tool messen kann, egal wie zentral es für die tatsächliche Wertschöpfungskette ist. Wir weisen diese Lücke lieber offen aus, als sie stillschweigend mit einer Zahl von anderswo zu füllen.
Damit bleiben 11 einzigartige „Schaufelverkäufer" und 4 Käufer — insgesamt 15 Unternehmen, jedes durch DUELs Battle Report, DCF Report und Resilience Report geführt, genau wie jedes andere Duell auf der Seite. Alle diesem Beitrag zugrunde liegenden Duelle wurden zwischen dem 26. Juli und dem 13. August 2026 erzeugt. Dies ist eine Momentaufnahme dieses Zeitfensters, keine dauerhafte Rangliste — die Methodik bleibt gültig, lange nachdem einzelne Zahlen veraltet sind.
Teil 2 — Wachstum und Marge: Wo das Kapital tatsächlich landet
| Ticker | Schicht | Umsatzwachstum (3J CAGR) | FCF-Marge | Operative Marge | ROIC | Sloan Ratio |
|---|---|---|---|---|---|---|
| NVDA | Compute | 100,1 % | 47,5 % | 60,4 % | 51,0 % | -6,9 % |
| AMD | Compute | 13,6 % | 19,4 % | 10,7 % | 4,5 % | -4,7 % |
| AVGO | Compute | 24,4 % | 42,1 % | 39,9 % | 14,1 % | -11,9 % |
| MU | Compute / Speicher | 6,7 % | 4,5 % | 26,1 % | 9,0 % | 36,9 % |
| ANET | Networking | 27,2 % | 48,4 % | 42,8 % | 23,1 % | 1,3 % |
| CIEN | Networking | 9,5 % | 14,0 % | 4,1 % | 4,4 % | -4,0 % |
| VRT | Strom/Kühlung | 21,6 % | 18,5 % | 17,9 % | 28,0 % | -2,8 % |
| ETN | Strom/Kühlung | 9,8 % | 12,9 % | 13,4 % | 6,8 % | 15,8 % |
| MOD | Strom/Kühlung | 11,5 % | 3,3 % | 10,8 % | 16,2 % | -4,6 % |
| GEV | Strom/Kühlung | 8,7 % | 2,4 % | 3,7 % | n/v | 5,6 % |
| WDC | Speicher | -20,3 % | 13,4 % | 24,5 % | 19,0 % | 32,3 % |
Keine einzige Zahl hier liest sich wie „der Zyklus ist vorbei". Neun der elf Namen wachsen ihren Umsatz weiterhin zweistellig, und die beiden Networking-Namen — ANET (27,2 %) und CIEN (9,5 %) — liegen innerhalb derselben Schicht an entgegengesetzten Enden dieser Spanne, was selbst aufschlussreich ist: Die Interconnect-Nachfrage hebt nicht jeden Networking-Namen gleichermaßen an. NVDAs 100-%-Zahl ist um eine Größenordnung ein Ausreißer gegenüber den eigenen Compute-Schicht-Peers — eine Erinnerung daran, dass „KI-Compute-Nachfrage" und „NVIDIAs Umsatzwachstum" nicht dieselbe Variable sind, auch wenn Schlagzeilen sie oft zu einer verschmelzen.
Das Margenbild ist die Stelle, an der sich der Korb in zwei sichtbar unterschiedliche Geschäfte aufspaltet. Compute- und Networking-Namen (NVDA, AVGO, ANET) weisen FCF-Margen im Bereich von 42–48 % aus — eine software-ähnliche Cash-Konvertierung trotz Hardware-Geschäft, größtenteils weil die eigentliche Fertigung ausgelagert ist. Strom- und Kühlungsnamen (VRT, ETN, MOD, GEV) weisen FCF-Margen zwischen 2 % und 19 % aus — kapitalintensive, margenschwächere Geschäfte von Natur aus, näher an klassischen Industrieunternehmen als am Chipdesign. WDC ist der einzige Name mit negativem Umsatzwachstum im gesamten Korb (-20,3 %) und spiegelt einen zyklischen Tiefpunkt bei NAND-/HDD-Preisen wider, der nichts mit KI-spezifischer Nachfrage zu tun hat — eine Erinnerung daran, dass „Speicher" als Kategorie mehr als einem Nachfragezyklus gleichzeitig ausgesetzt ist.
Teil 3 — Wie viel Wachstum bereits im Preis steckt
Das ist der Teil, der sich tatsächlich mit der Frage nach der „Zyklusphase" befasst — indirekt, und zu DUELs eigenen Bedingungen. DUELs DCF-Engine baut einen fairen Wert und eine 3-Jahres-Kursprojektion allein aus den eigenen Meldungen jedes Unternehmens auf: kein Marktpreis als Input, keine Analysten-Wachstumsschätzungen, nur Umsatz-CAGR, FCF, ROIC und Sloan Ratio, verarbeitet durch eine feste Formel (vollständige Methodik in unserem früheren [Beitrag zum DCF-Konfidenzband]). Das resultierende modellierte 3-Jahres-Aufwärtspotenzial ist kein Kursziel — es ist ein Maß dafür, wie viel von der eigenen historischen Flugbahn eines Unternehmens, nach den festen Regeln des Modells fortgeschrieben, bereits in der eigenen Fair-Value-Schätzung des Modells abgebildet ist, gegenüber dem Spielraum, den die Mathematik noch zeigt.
| Ticker | Fair Value (T0) | Modelliert +3J Kurs | Modelliertes 3J-Aufwärtspotenzial |
|---|---|---|---|
| WDC | 30,68 $ | 39,14 $ | 27,6 % |
| AMD | 67,72 $ | 83,98 $ | 24,0 % |
| GEV | 57,82 $ | 69,81 $ | 20,7 % |
| GOOGL | 106,91 $ | 128,91 $ | 20,6 % |
| CIEN | 88,73 $ | 105,80 $ | 19,2 % |
| AMZN | 254,94 $ | 302,36 $ | 18,6 % |
| MSFT | 200,09 $ | 237,23 $ | 18,6 % |
| MOD | 41,28 $ | 48,82 $ | 18,3 % |
| ANET | 105,29 $ | 123,88 $ | 17,6 % |
| ETN | 184,92 $ | 216,43 $ | 17,0 % |
| META | 524,18 $ | 609,31 $ | 16,2 % |
| NVDA | 176,47 $ | 202,24 $ | 14,6 % |
| AVGO | 205,67 $ | 233,87 $ | 13,7 % |
| MU | 38,29 $ | 43,06 $ | 12,5 % |
| VRT | 203,50 $ | 226,82 $ | 11,5 % |
NVIDIA — mit weitem Abstand der am schnellsten wachsende, ROIC-stärkste Name im gesamten Korb — landet auf Platz 12 von 15 beim modellierten Aufwärtspotenzial. Das ist kein Zufall des Modells; es ist die direkte rechnerische Konsequenz daraus, dass NVDAs eigener Unternehmenswert im Verhältnis zu seinen eigenen projizierten Cashflows bereits groß genug ist, sodass das Fortschreiben eines festen 3-Jahres-Wachstumspfads eine kleinere prozentuale Bewegung erzeugt, als dieselbe Übung auf einer kleineren Basis. Das ist dasselbe Muster, das unser erster Beitrag dieser Serie bereits in einem einzelnen NVDA-vs-AMD-Duell Anfang August fand; es über einen 11-Unternehmen-Infrastrukturkorb statt über ein einzelnes Paar laufen zu lassen, zeigt, dass es kein Artefakt jenes spezifischen Vergleichs ist.
Zwei Validitätshinweise, die es klar zu benennen gilt. Erstens erscheinen MUs Fair Value (38,29 $), 3-Jahres-Kurs (43,06 $) und jeder dahinterliegende Input identisch, egal ob MU gegen AMD oder gegen WDC verglichen wird — direkte, in der Praxis erbrachte Bestätigung, dass DUELs unternehmensbezogene DCF-Outputs nicht davon abhängen, wer der Gegner ist, genau wie das Modell konzipiert ist. Zweitens sitzt GEVs modelliertes Aufwärtspotenzial (20,7 %) nahe der Spitze dieser Tabelle, sollte aber zusammen mit Teil 4 unten gelesen werden, bevor man daraus isoliert eine Schlussfolgerung zieht.
Teil 4 — Wer tatsächlich die Bilanz-Rüstung hat
| Ticker | FRI-Score | Stufe | Wachstum vs. FCF | ROIC vs. Sloan | Verschuldung vs. Cash |
|---|---|---|---|---|---|
| AMD | 100 | HOCH | OK | OK | OK |
| ANET | 97 | HOCH | OK | OK | OK |
| VRT | 94 | HOCH | OK | OK | OK |
| CIEN | 90 | HOCH | OK | OK | OK |
| MU | 76 | HOCH | OK | OK | OK |
| AVGO | 75 | HOCH | OK | OK | VORSICHT |
| WDC | 69 | MODERAT | OK | OK | OK |
| ETN | 68 | MODERAT | OK | OK | RISIKO |
| NVDA | 64 | MODERAT | OK | OK | OK |
| MOD | 31 | NIEDRIG | OK | OK | OK |
| GEV | 11 | NIEDRIG | OK | OK | OK |
Hier wird die „Profiteur"-Geschichte komplizierter, als ein einzelnes Wachstumsdiagramm vermuten lässt. Zwei der vier Strom-und-Kühlung-Namen — MOD (31) und GEV (11) — landen in DUELs NIEDRIG-Resilienzstufe, derselben Kategorie, die das Modell Unternehmen vorbehält, deren Bilanzpuffer im Verhältnis zu ihren Cashflow-Anforderungen dünn erscheint, unabhängig davon, wie stark das zugrunde liegende Wachstumsnarrativ ist. GEV verdient dabei eher einen Datenqualitätsvorbehalt als ein Urteil: Mehrere seiner rohen Bilanzkomponenten (Cash, Gesamtverschuldung, operatives Ergebnis, Eigenkapital) waren im erfassten Meldungszeitraum nicht verfügbar, am plausibelsten, weil GE Vernovas SEC-Meldehistorie seit der Abspaltung von GE 2024 noch kurz ist. Seine NIEDRIG-Stufe sollte als vorläufig behandelt werden, bis sich umfassendere Nach-Spin-off-Meldungen ansammeln — ein Unternehmen mit kurzer Meldehistorie wird bei Komponenten, die das Modell noch nicht sehen kann, mechanisch dünner aussehen, unabhängig von seiner tatsächlichen finanziellen Verfassung.
ETN ist ein klarerer Fall: Seine Verschuldung-vs-Cash-Konsistenzprüfung löste eine echte RISIKO-Markierung aus — Verschuldungsgrad über 1,0x, wobei Cash im Wesentlichen keinen Teil der Gesamtverschuldung deckt — ein unkompliziertes Leverage-Signal auf einer bereits reifen Industriebilanz, kein Rechnungslegungsqualitätsproblem. AVGOs einzelne VORSICHT-Markierung ist dieselbe Geschichte in kleinerem Maßstab.
Zugleich gehören die höchsten Resilienzwerte im Korb nicht den wachstumsstärksten oder den Namen mit dem geringsten Aufwärtspotenzial — sie gehören AMD, ANET und VRT, drei Unternehmen mit bedeutend unterschiedlichen Wachstumsprofilen und Margenstrukturen, vereint einzig durch saubere, widerspruchsfreie Bilanzen über alle drei internen Konsistenzprüfungen von DUEL hinweg.
Teil 5 — Die Scorecard: Aufwärtspotenzial vs. Resilienz
Teil 3 und Teil 4 auf eine gemeinsame Seite gebracht — modelliertes 3-Jahres-Aufwärtspotenzial auf der einen Achse, Resilienzstufe auf der anderen — sortiert die Infrastrukturnamen in vier Gruppen, die keine einzelne Tabelle oben für sich zeigt. Der Trennpunkt auf jeder Achse ist der Median, berechnet über die 11 Unternehmen der Angebotsseite allein (17,65 % Aufwärtspotenzial, FRI 75); die vier Hyperscale-Käufer werden bewusst aus dieser Berechnung ausgeklammert und separat in Teil 6 gezeigt, damit ihre viel größeren, diversifizierteren Bilanzen den Lieferanten-Median nicht stillschweigend verzerren.
Attraktiv bepreist und strukturell solide (überdurchschnittliches Aufwärtspotenzial, überdurchschnittliche Resilienz): AMD, ANET, CIEN
Modelliertes Aufwärtspotenzial, dünnerer Puffer (überdurchschnittliches Aufwärtspotenzial, unterdurchschnittliche Resilienz): WDC, GEV, MOD
Bereits eingepreist, aber kerngesund (unterdurchschnittliches Aufwärtspotenzial, überdurchschnittliche Resilienz): AVGO, MU, VRT
Bereits eingepreist, vergleichsweise dünnerer Puffer (unterdurchschnittliches Aufwärtspotenzial, unterdurchschnittliche Resilienz): NVDA, ETN
Nur zwei Namen landen in diesem letzten, am wenigsten günstigen Quadranten — und NVIDIA ist einer davon, neben ETN, einem reifen Industrieunternehmen, das dieselbe Analyse in Teil 4 mit einer echten Leverage-RISIKO-Markierung versehen hat. Das ist die eigentliche Überraschung hier: Der Name, den jede Schlagzeile als den offensichtlichen „KI-Gewinner" behandelt, sitzt in dem Quadranten, den die eigene Mathematik dieses Korbs mit dem geringsten verbleibenden modellierten Spielraum und dem geringsten Resilienzpuffer verbindet — nicht weil mit dem Geschäft etwas nicht stimmt, sondern weil sowohl sein Wachstum als auch sein Unternehmenswert bereits weit genug gelaufen sind, dass die eigene Arithmetik des Modells auf beiden Achsen weniger Distanz zu überbrücken hat als bei neun der anderen zehn Lieferanten in der Kette, in deren Zentrum er steht.
Teil 6 — Die Kontrollgruppe: Wie die Käufer aussehen
| Ticker | Modelliertes 3J-Aufwärtspotenzial | FRI-Score | Stufe |
|---|---|---|---|
| GOOGL | 20,6 % | 85 | HOCH |
| AMZN | 18,6 % | 100 | HOCH |
| MSFT | 18,6 % | 81 | HOCH |
| META | 16,2 % | 83 | HOCH |
Alle vier Hyperscale-Käufer landen in DUELs HOCH-Resilienzstufe, anders als ihre Lieferanten, bei denen die Resilienz zwischen 11 und 100 schwankte. Das ist zu erwarten — es handelt sich um vier der größten, diversifiziertesten Cashflow-Generatoren im gesamten Markt, die KI-Infrastruktur als einen Posten unter vielen kaufen, statt davon abhängig zu sein wie ein reiner Pure-Play-Lieferant. Weniger zu erwarten: Ihr modelliertes Aufwärtspotenzial (16,2 %–20,6 %) liegt genau in derselben Spanne wie der Lieferantenkorb — nicht erkennbar höher oder niedriger. Der Käufer in dieser Transaktion zu sein, erzeugt strukturell keine andere Bewertungsmathematik-Signatur als der Lieferant zu sein — zumindest keine, die diese Momentaufnahme erkennen kann.
Teil 7 — Was das tatsächlich beantwortet, und was nicht
Um bei den Grenzen dieser Übung präzise zu bleiben, da eine Überinterpretation hier den gesamten Sinn untergraben würde: Dieser Beitrag sagt nicht und kann nicht sagen, ob die KI-Infrastrukturausgaben noch weiterlaufen, sich abflachen oder bereits ihren Höhepunkt erreicht haben. Das ist eine Frage über die Zukunft, und jede Zahl oben beschreibt ausschließlich Vergangenheit und Gegenwart.
Was die Daten aus sich selbst heraus zeigen: Die nachlaufenden Wachstumsraten in diesem Korb sind weiterhin hoch und weiterhin gestreut — nichts hier ähnelt einem Sektor, in dem sich das Wachstum synchronisiert und abgeflacht hat, was typischerweise so aussieht, wie ein „später, reifender" Zyklus in den Fundamentaldaten aussieht, statt in den Schlagzeilen. Es zeigt auch, dass die Resilienz unter einer Wachstumsgeschichte, die so erzählt wird, als gelte sie für jeden Beteiligten gleichermaßen, tatsächlich uneinheitlich ist — und dass DUELs eigene marktpreisfreie DCF-Mathematik dem meistdiskutierten Namen im Bereich bereits weniger verbleibenden modellierten Spielraum zuweist als den meisten anderen in der Kette um ihn herum — was eine Aussage über den heutigen Ausgangspunkt dieses spezifischen Unternehmens ist, keine Vorhersage über morgen.
Einschränkungen
TSM vollständig ausgeschlossen, und zwar aus strukturellen, nicht aus Datenqualitätsgründen: Als Foreign Private Issuer reicht das Unternehmen einen 20-F statt eines 10-K ein, was es außerhalb dessen platziert, was DUELs ausschließlich auf SEC-EDGAR basierende Pipeline lesen kann — unabhängig von seiner realen Bedeutung für die Compute-Schicht.
Momentaufnahme, keine Live-Rangliste. Jedes zugrunde liegende Duell wurde zwischen dem 26. Juli und dem 13. August 2026 erzeugt; die konkreten Zahlen oben werden mit jeder neuen Quartalsmeldung driften, die vergleichende Methode, aus der sie stammen, jedoch nicht.
Kein Marktpreis, absichtlich — und das wirkt in beide Richtungen. DUELs DCF-Engine ignoriert bewusst den aktuellen Aktienkurs und Analystenschätzungen, was genau das ist, was „wie viel Wachstum die eigene Flugbahn des Unternehmens bereits unterstellt" zu einer sauberen, überprüfbaren Frage macht. Es bedeutet auch, dass das „modellierte Aufwärtspotenzial" hier keine marktimplizite Erwartung ist und nicht als solche gelesen werden sollte.
Die Korbzusammenstellung ist eine Ermessensentscheidung, keine Vollerhebung. Elf Infrastrukturnamen und vier Käufer sind ein vernünftiger Querschnitt der KI-Wertschöpfungskette, kein erschöpfender; ein anderer vernünftiger Korb könnte verschieben, welche Namen in welchem Scorecard-Quadranten landen.
GEVs Resilienzwert sollte mit einem Datenvollständigkeitsvorbehalt gelesen werden, direkt in Teil 4 markiert — mehrere rohe Bilanz-Inputs waren angesichts der kurzen Meldehistorie des Unternehmens seit der Abspaltung 2024 nicht verfügbar, und seine NIEDRIG-Stufe könnte teilweise diese Lücke widerspiegeln statt ein vollständig aufgelöstes Bild seiner finanziellen Verfassung.
Fünfzehn Unternehmen sind eine diagnostische Momentaufnahme, keine statistische Stichprobe — lesen Sie die obigen Muster als beschreibend, nicht als über diesen spezifischen Korb hinaus verallgemeinerbare Evidenz.
Fazit
Über elf KI-Infrastrukturlieferanten und vier ihrer größten Käufer hinweg ist das Wachstum weiterhin breit stark und weiterhin ungleich verteilt — kein Bild eines abgeflachten Sektors. Die Resilienz hingegen folgt der Wachstumsgeschichte überhaupt nicht: Einige der meistgehypten Wachstumsnamen tragen die dünnsten Bilanzpuffer im Korb, und einige der am wenigsten diskutierten tragen die stärksten. Und die eine Kennzahl, die sich am direktesten mit der Frage „wie viel ist bereits eingepreist" befasst — DUELs eigenes gegnerunabhängiges, marktpreisfreies modelliertes Aufwärtspotenzial — weist derzeit dem Namen, den die meisten Menschen als das offensichtliche Zentrum dieses gesamten Zyklus bezeichnen würden, den geringsten verbleibenden Spielraum zu. Nichts davon ist eine Prognose. Es ist das, was die Meldungen bereits sagen, verarbeitet durch dieselbe Formel für jedes Unternehmen im Raum.
Jede Zahl in diesem Beitrag lässt sich auf ein Duell zurückführen, das Sie selbst auf duelstocks.com abrufen und erneut überprüfen können.
Weiterführende Lektüre — Gleiche Serie, gleiche Methode
Dieser Beitrag baut direkt auf der Methodik auf, die in sechs früheren Tiefenanalysen dieser Serie etabliert wurde, die Sie auf dieser Seite nachlesen können.
Quellen
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3. Aufl.). Wiley.
U.S. Securities and Exchange Commission — Meldepflichten für Foreign Private Issuer (Formular 20-F vs. Formular 10-K), sec.gov.
Eine methodische Tiefenanalyse von DuelStocks. Keine Anlageberatung. Alle Daten stammen aus öffentlichen SEC-EDGAR-Meldungen.
Bilanzielle Verschuldung, nicht Ertragsqualität, treibt die meisten Resilienz-Abstriche.
Die Frage
DUELs Resilience Report (STR) prüft jedes Unternehmen anhand von drei Paaren interner Konsistenz: Verwandelt sich Umsatzwachstum tatsächlich in freien Cashflow (Wachstum vs. FCF), hält ein starker ROIC stand, wenn man die Accrual-Qualität prüft (ROIC vs. Sloan), und entspricht die Verschuldung in der Bilanz tatsächlich dem verfügbaren Cash-Puffer (Verschuldung vs. Cash)? Jedes Paar, das durchfällt, löst einen Score-Abzug und einen markierten Hinweis aus.
Oracles (ORCL) ROIC-vs-Sloan-Signal — ein Schlagzeilen-ROIC von 84 %, direkt neben einer Sloan Ratio, die auf mögliche Ertragsaufblähung hindeutet — war überzeugend genug, um einen ganzen Beitrag darauf aufzubauen. Aber ein dramatischer Fall wirft eine naheliegende Frage auf: Ist das der normale Weg, wie ein Unternehmen diese Konsistenzprüfung des Modells nicht besteht, oder ist es die seltene Ausnahme, die als Norm getarnt wurde, nur weil es der Fall war, über den wir berichtet haben?
Forschungsfrage: Wie hoch ist über einen echten Querschnitt von Unternehmen hinweg die Basisrate für jeden der drei Konsistenzmatrix-Konflikte, und welcher davon treibt tatsächlich die meisten Resilienz-Abstriche?
Das ist ein statistisch anderes Tier als unser früherer PCA-Beitrag zur Kennzahlen-Redundanz. Jene Studie fragte, wie kontinuierliche Kennzahlen miteinander korrelieren. Diese hier fragt, wie oft eine binäre Bestehen/Nichtbestehen-Schwelle ausgelöst wird — ein Basisraten-Schätzproblem, das ein völlig anderes Werkzeugset erfordert.
Literatur
Sloan (1996) ist der theoretische Anker dafür, warum ROIC-vs-Sloan überhaupt als Frühwarnsignal fungieren sollte: Unternehmen mit hohen Accruals im Verhältnis zum Cashflow tendieren dazu, dass die Ertragsqualität — und letztlich die Renditen — enttäuschen. Aber die Basisratenfrage liegt in einer anderen, verwandten Literatur: Wie häufig sind Ertragsqualitäts-Warnsignale in einer allgemeinen, ungefilterten Population börsennotierter Unternehmen? Beneish (1999), der den ursprünglichen M-Score entwickelte, arbeitete mit einer bewusst unausgewogenen Stichprobe — 50 bekannte Ertragsmanipulatoren, gepaart mit 1.708 Nicht-Manipulatoren — genau weil echte Manipulatoren in der Wildnis selten sind; sein Design musste sie übersampeln, um überhaupt genug positive Fälle für eine Modellierung zu haben. Dechow, Ge, Larson und Sloan (2011), die SEC-Durchsetzungsmaßnahmen wegen fehlerhafter Rechnungslegung über 23 Jahre untersuchten, kommen aus tatsächlichen Populationsdaten zum gleichen Schluss: Wesentliche Falschdarstellung ist ein Ereignis mit niedriger Basisrate, kein Münzwurf. Unser Prior für den ROIC-vs-Sloan-Konflikt sollte von vornherein "selten" sein — und die Frage ist, ob die DUEL-Daten dem zustimmen, und ob die beiden anderen Konflikttypen diese Seltenheit teilen oder nicht.
Für die Statistik der Schätzung einer Rate selbst: Cochran (1977) liefert die Standardformel für die Stichprobengröße zur Schätzung eines Anteils mit einer angestrebten Fehlermarge. Aber sobald die Rate geschätzt ist, insbesondere in der Nähe der Grenzen (sehr niedrig oder sehr hoch), verhält sich das gewöhnliche Normalapproximations-("Wald")-Konfidenzintervall schlecht — es kann sogar unsinnige negative untere Grenzen erzeugen. Wilson (1927) schlug ein score-basiertes Intervall vor, das sich bei extremen Anteilen weiterhin gut verhält, und Newcombe (1998) bestätigt es als die zuverlässigere Wahl für Anteile mit kleiner Stichprobe oder seltenen Ereignissen wie den hier direkt behandelten. Alle Konfidenzintervalle unten verwenden daher die Wilson-Methode.
Daten und Methode
Panel: dieselben 60 Unternehmen (30 Duelle), die in unserem vorherigen PCA-Beitrag verwendet wurden, nun mit dem STR Resilience Report jedes Unternehmens statt seines Battle Reports — dieselbe zugrundeliegende Population, ein anderes Report-Artefakt, was es erlaubt, die beiden Studien nebeneinander auf einem konsistenten Panel zu betrachten.
Variablen: für jedes Unternehmen die drei Konsistenzmatrix-Ergebnisse wie berichtet (OK / VORSICHT / RISIKO), plus der Gesamt-FRI-Score, die Resilienzstufe (HOCH/MODERAT/NIEDRIG), der Basis-Score und der Abzug.
Methode: Basisrate = Anzahl der Nicht-OK-Ergebnisse ÷ 60, separat berechnet für (a) jedes Nicht-OK-Signal (VORSICHT oder RISIKO kombiniert) und (b) speziell RISIKO, für jeden der drei Checks. 95-%-Konfidenzintervalle nach der Wilson-Score-Methode. Cochrans (1977) Richtlinie für die minimal erwartete Zellhäufigkeit (≥5 Ereignisse für eine stabile Ratenschätzung) wird explizit angewendet, um zu markieren, welche der drei Raten bei dieser Stichprobengröße vertrauenswürdig sind und welche noch nicht.
Ergebnisse
Basisrate je Konflikttyp
| Check | Nicht-OK (VORSICHT+RISIKO) | Rate | 95-%-Wilson-KI | Nur RISIKO | Rate |
|---|---|---|---|---|---|
| Wachstum vs. FCF | 2 / 60 | 3,3 % | [0,9 %, 11,4 %] | 0 / 60 | 0,0 % |
| ROIC vs. Sloan | 2 / 60 | 3,3 % | [0,9 %, 11,4 %] | 1 / 60 | 1,7 % |
| Verschuldung vs. Cash | 26 / 60 | 43,3 % | [31,6 %, 55,9 %] | 19 / 60 | 31,7 % |
Das ist kein subtiler Unterschied. Verschuldung vs. Cash wird etwa dreizehnmal so häufig ausgelöst wie jeder der beiden anderen Checks. Wachstum vs. FCF und ROIC vs. Sloan — der Konflikttyp, der diese gesamte Untersuchungslinie inspiriert hat — landen bei genau derselben Rate, 3,3 %, gleichauf als seltenstes Ergebnis in der gesamten Matrix.
Wie viele Unternehmen tragen mehr als ein Signal
| Gleichzeitige Konflikte | Unternehmen | Anteil |
|---|---|---|
| 0 (sauber) | 33 | 55,0 % |
| 1 | 24 | 40,0 % |
| 2 | 3 | 5,0 % |
| 3 (alle Checks fehlgeschlagen) | 0 | 0,0 % |
55 % der Unternehmen in diesem Panel bestehen alle drei Checks sauber. Kein Unternehmen in der Stichprobe scheiterte gleichzeitig an allen drei — der theoretische schlechteste Fall trat nie auf. Von den 27 Unternehmen (45,0 %, 95-%-KI [33,1 %, 57,5 %]), die mindestens ein Signal tragen, tragen die überwiegende Mehrheit (24 von 27) genau eines, und es ist fast immer dasselbe.
Was "Verschuldung vs. Cash" tatsächlich markiert
Jeder RISIKO-Level-Hinweis zu Verschuldung vs. Cash in diesem Panel folgt demselben Muster: eine Verschuldungsquote deutlich über 1x, kombiniert mit Cash, der nur einen Bruchteil der Gesamtverschuldung abdeckt (z. B. HD: Verschuldungsgrad 3,3, Cash deckt 0,0x der Schulden; CAT: Verschuldungsgrad 1,9, Cash deckt 0,1x der Schulden). Das ist ein Leverage-Signal — wie viel Schulden in der Bilanz stehen im Verhältnis zum verfügbaren Cash-Puffer, um sie zu bedienen — kein Signal für Rechnungslegungsqualität. Es ist mechanisch weitaus üblicher, dass ein reifes, kapitalintensives Unternehmen bedeutende Verschuldung trägt, als dass seine Erträge akute Accrual-Manipulation zeigen, und die 13-fache Häufigkeitslücke in diesen Daten ist mit dieser grundlegenden Unterscheidung konsistent.
Nicht jedes Unternehmen mit niedriger Resilienz hat einen Konflikt
Sieben Unternehmen in diesem Panel landen in der Resilienzstufe NIEDRIG. Nur drei davon (STX, HD-ähnliche Fälle, SHW/KO mit Verschuldung-vs-Cash-RISIKO, STX mit zwei gleichzeitigen Signalen) kamen dorthin über einen Konsistenzmatrix-Abzug. Die anderen vier — INTC, OXY, SNDK, und eines mehr — erreichten NIEDRIGE Resilienz mit einem schwachen Basis-Score und null Konflikten: Jede einzelne Komponente (Cash-zu-Schulden-Deckung, Investitions-Selbstversorgung, Ertragsqualität, Liquiditätsreichweite) erzielte schlicht für sich genommen einen niedrigen Score, ohne dass etwas anderem widersprochen wurde. Das ist eine bedeutsam andere Situation als der Fall Oracle: "durchgängig schwach" und "in sich widersprüchlich" sind zwei unterschiedliche Ausfallmodi, und dieses Panel zeigt, dass beide auftreten, wobei das widerspruchsgetriebene Versagen das selteneres der beiden ist.
Diskussion
Der Befund kehrt die Intuition um, die dieses gesamte Projekt motiviert hat. Das Oracle-artige Signal — eine dramatisch aussehende Kennzahl neben einem Ertragsqualitäts-Warnsignal — ist tatsächlich selten, mit derselben Rate von 3,3 % wie der andere "Qualitäts"-Check (Wachstum vs. FCF). Es ist außerdem, nicht zufällig, die erzählerisch interessanteste Art von Signal, was genau der Grund ist, warum es sich von Anfang an für eine spannende Video-Berichterstattung eignete. Aber der Konflikt, der in einem breiten Querschnitt großer, bekannter börsennotierter Unternehmen tatsächlich fast alle Resilienz-Abstriche verursacht, ist der am wenigsten dramatische: gewöhnliche Bilanzverschuldung. Beneishs (1999) Übersampling von Manipulatoren, um überhaupt einen brauchbaren Datensatz zu erhalten, und Dechow et al.s (2011) populationsweite Bestätigung, dass Falschdarstellung selten ist, weisen beide in dieselbe Richtung wie unsere Daten: Die dramatische Geschichte über Rechnungslegungsqualität ist das Randereignis, nicht die Norm — und ein Modell, das darauf ausgelegt ist, sie zu erfassen, sollte erwarten, sie selten zu markieren, was genau hier passiert ist.
Praktische Erkenntnis für DuelStocks
Das ändert vermutlich, wie über die eigenen Signale des Resilience Reports gesprochen werden sollte, und es ist eine echte Content-Chance, nicht nur eine Forschungsfußnote:
- Den Marketing-Winkel neu framen. Die Oracle-artige "versteckte Ertragsaufblähung"-Geschichte ist ein großartiger Aufhänger, aber sie ist die Ausnahme, nicht das, was das Modell hauptsächlich einfängt. Die ehrliche, und wohl nützlichere Positionierung ist: "Unser Modell erfasst hauptsächlich gewöhnliches Leverage-Risiko — die Art, die bei etwa 4 von 10 überprüften Unternehmen auftritt — nicht nur seltenes Rechnungslegungs-Drama." Das ist ein stärkeres Vertrauenssignal, als zu suggerieren, jedes Signal sei eine Oracle-würdige Geschichte, und es wird von diesen Daten gestützt, nicht von einem einzigen Fall.
- Eine Kalibrierungszeile im STR-Report selbst — etwa "Verschuldung-vs-Cash-Signale treten bei ~43 % der von uns analysierten Unternehmen auf; ROIC-vs-Sloan-Signale bei ~3 %" — würde einen Leser sofort einschätzen lassen, ob ein bestimmtes Signal üblich oder tatsächlich ungewöhnlich ist, statt jeden VORSICHT/RISIKO-Hinweis als gleich alarmierend zu lesen. Das ist ein erwägenswerter Produktvorschlag, keine Änderung, die aufgrund eines einzelnen Piloten vorgenommen wird.
- Ein naheliegendes nächstes Kurzvideo: "Der wahre Grund für die meisten Resilienz-Abstriche (Tipp: Es ist keine Bilanzfälschung)" — die 43-%-Statistik zu Verschuldung vs. Cash ist ein starker, ehrlicher, nicht auf Klickzahlen getrimmter Aufhänger, der direkt mit echten Zahlen verteidigbar ist, im Gegensatz zu einem generischen "Achte auf Warnsignale"-Video.
Einschränkungen
Zwei der drei Raten sind noch nicht zuverlässig geschätzt. Wachstum vs. FCF und ROIC vs. Sloan haben jeweils nur 2 beobachtete Ereignisse unter 60 Unternehmen — unterhalb von Cochrans (1977) Faustregel-Minimum von 5 für eine stabile Ratenschätzung. Ihre Wilson-Intervalle (beide [0,9 %, 11,4 %]) sind relativ zu ihrer Punktschätzung breit, und die wahre Populationsrate jeder Kennzahl könnte plausibel doppelt oder halb so hoch sein wie hier beobachtet. Die Schätzung für Verschuldung vs. Cash, mit 26 Ereignissen, steht auf deutlich festerem Boden.
Querschnittlich, eine Momentaufnahme. Ob diese Basisraten in einem Jahr, oder über einen anderen Satz von 60 Unternehmen, Bestand haben, ist ungetestet.
Die Sektorzusammensetzung spielt eine Rolle und wird nicht kontrolliert. Dieses Panel neigt zu großen, etablierten börsennotierten Unternehmen; ein Panel mit mehr Gewicht auf kleinere oder neu börsennotierte Unternehmen könnte eine ganz andere Leverage-/Accrual-Mischung zeigen.
Absichtlich dasselbe Panel wie beim PCA-Beitrag — das erlaubt, die beiden Studien zusammen zu lesen, bedeutet aber auch, dass keine der beiden eine vollständig unabhängige Replikation der Population der anderen ist.
Nichts davon ändert DUELs tatsächliche Bewertungs- oder Abzugslogik im Produkt. Es ist ein Basisraten-Befund darüber, wie oft jedes Signal in der realen Welt auslöst, kein Vorschlag, die zugrundeliegenden Schwellenwerte zu ändern.
Fazit
Von drei Konsistenz-Checks in DUELs Resilienzmodell löst einer — Verschuldung vs. Cash — bei etwa 4 von 10 überprüften Unternehmen aus. Die anderen beiden, einschließlich genau der Art von Signal, die diese Forschung inspiriert hat (ROIC vs. Sloan), lösen jeweils bei etwa 1 von 30 aus. Die dramatische Geschichte ist die seltene. Die häufige ist gewöhnliches Leverage — was, auf seine eigene Art, das nützlichere Ding ist, das ein Resilienz-Check verlässlich erfassen sollte.
Wie immer: Der vollständige Resilience Report jedes Duells, mit jeder Rohzahl hinter diesen Signalen, ist auf duelstocks verfügbar.
Quellen
Beneish, M. D. (1999). The detection of earnings manipulation. Financial Analysts Journal, 55(5), 24–36.
Cochran, W. G. (1977). Sampling Techniques (3. Aufl.). Wiley.
Dechow, P. M., Ge, W., Larson, C. R., & Sloan, R. G. (2011). Predicting material accounting misstatements. Contemporary Accounting Research, 28(1), 17–82.
Newcombe, R. G. (1998). Two-sided confidence intervals for the single proportion: comparison of seven methods. Statistics in Medicine, 17(8), 857–872.
Sloan, R. G. (1996). Do stock prices fully reflect information in accruals and cash flows about future earnings? The Accounting Review, 71(3), 289–315.
Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212.
Eine methodische Tiefenanalyse von DuelStocks. Keine Anlageberatung. Alle Daten stammen aus öffentlichen SEC-EDGAR-Meldungen.
Neue Forschung zeigt: Ein 8-Faktor-Aktienmodell reduziert sich auf vier Signale: Cash-Konversion, Kapitaleffizienz, Accrual-Qualität und Wachstum.
Die Frage
DUEL bewertet jedes Duell anhand von acht Fundamentalkennzahlen, jede mit fester Gewichtung: Umsatzwachstum (16 %), operative Cashflow-Marge (15 %), ROIC (15 %), Sloan Ratio (12 %, invertiert), Asset Turnover (10 %), Receivables Turnover (8 %), operative Marge (12 %) und FCF-Marge (12 %). Das Winner-take-all-Design behandelt implizit jede Kennzahl als unabhängiges Beweisstück.
Finanzkennzahlen kooperieren selten mit dieser Annahme. Pinches, Mingo und Caruthers (1973) zeigten mittels Faktorenanalyse als erste, dass ein großes Set von Finanzkennzahlen auf eine Handvoll zugrundeliegender Dimensionen zusammenfällt — nicht auf die Anzahl der Kennzahlen, mit der man begann. Chen und Shimerda (1981) trieben den Punkt mit einer klaren Illustration weiter: Eigenkapital/Fremdkapital, Fremdkapital/Eigenkapital, Eigenkapital/Bilanzsumme und Fremdkapital/Bilanzsumme wirken wie vier Kennzahlen, tragen aber zusammen genau eine Information. Wenn sich zwei von DUELs acht Kennzahlen über Unternehmen hinweg gemeinsam bewegen, stimmt ein nominales Gesamtgewicht von 24–27 % möglicherweise wirklich nur einmal ab, nicht zweimal.
Forschungsfrage: Wie viele statistisch unabhängige Signale sind tatsächlich in DUELs acht Kennzahlen kodiert, und wie gruppieren sie sich?
Daten und Methode
Panel: 30 in diesem Zyklus neu durchgeführte Duelle, keine Wiederholungen aus früherer Berichterstattung — 60 Unternehmen aus Technologie, Gesundheitswesen, Industrie, Konsumgütern des täglichen Bedarfs, Einzelhandel, Energie, Telekommunikation, Halbleitern, Werkstoffen sowie Reisen & Freizeit. Die Branchenvielfalt ist hier ein Merkmal, kein Rauschen: Sie testet, ob die Korrelationsstruktur über sehr unterschiedliche Geschäftsmodelle hinweg Bestand hat, nicht nur innerhalb einer Branche.
Variablen: die acht Rohwerte je Kennzahl pro Unternehmen, direkt aus dem Berechnungsdetail jedes Battle Reports entnommen (nicht das Sieg/Niederlage-Ergebnis).
Fehlende Daten: ROIC und operative Marge waren für OXY und COP nicht verfügbar (branchenspezifische Posten-Lücken), und Receivables Turnover war für NFLX und PEP nicht verfügbar. Pearson- und Spearman-Korrelationen verwenden paarweise vollständige Beobachtungen (Standardpraxis); die PCA verwendet die 56 Unternehmen mit vollständigen Datensätzen über alle acht Kennzahlen.
Korrelation: Sowohl Pearson (linear) als auch Spearman (rangbasiert) wurden berechnet. Spearman ist hier relevant, weil mehrere Kennzahlen — Sloan Ratio, FCF-Marge, ROIC in einigen Fällen — Ausreißer und Schiefe aufweisen (Fords (F) -34-%-ROIC-Jahr, MOs 82x Receivables Turnover), und Pearson allein durch eine Handvoll Extremwerte verzerrt werden kann.
PCA: standardisierte (z-transformierte) Inputs, korrelationsbasierte Hauptkomponentenanalyse, Kaiser-Kriterium (Eigenwert > 1) als erster Schnitt, kumulierte erklärte Varianz als zweiter, und eine Varimax-Rotation (Kaiser, 1958) auf die zur Erreichung von 80 % Varianz benötigten Komponenten, für eine interpretierbarere Ladungsstruktur.
Stichprobengröße, ehrlich betrachtet: 56–60 Beobachtungen liegen noch unter dem Lehrbuch-Komfortniveau, haben sich aber gegenüber dem ersten Durchlauf dieser Analyse (46–50) deutlich verbessert. Comrey und Lee (1992) bewerten N=50 als "sehr schlecht" und N=100 als "schlecht" für faktoranalytische Arbeit; Nunnallys (1978) Regel von 10 Beobachtungen pro Variable würde 80 erfordern. Was für uns spricht: Guadagnoli und Velicer (1988) fanden heraus, dass die benötigte Stichprobengröße stark sinkt, wenn Ladungen stark und klar getrennt sind — und, wie die Ergebnisse unten zeigen, sind unsere das größtenteils. Dies ist eine explorative Pilotstudie, im selben Geist wie unsere frühere Bradley-Terry-Sektorstudie — ein erster Durchgang, der erweitert werden soll, kein konfirmatorisches Ergebnis. (Es lohnt sich, vorab zu erwähnen, dass das Hinzufügen dieser 10 Unternehmen die Struktur der Antwort veränderte — siehe unten. Das ist kein Fehler der Methode; es ist genau die Art von Instabilität, die ein Pilot mit kleinem N aufdecken soll.)
Ergebnisse
Korrelationsstruktur
Die stärksten paarweisen Beziehungen im 60-Unternehmens-Panel (Pearson / Spearman):
| Paar | Pearson r | Spearman ρ |
|---|---|---|
| Operative Cashflow-Marge ↔ Operative Marge | 0,76 | 0,75 |
| Operative Cashflow-Marge ↔ FCF-Marge | 0,70 | 0,75 |
| Operative Marge ↔ FCF-Marge | 0,66 | 0,60 |
| Asset Turnover ↔ Receivables Turnover | 0,56 | 0,56 |
| Operative Cashflow-Marge ↔ Asset Turnover | -0,49 | -0,53 |
| ROIC ↔ Operative Marge | 0,49 | 0,53 |
| ROIC ↔ Asset Turnover | 0,46 | 0,62 |
| Umsatzwachstum ↔ Operative Marge | 0,45 | 0,23 |
| Umsatzwachstum ↔ FCF-Marge | 0,45 | 0,26 |
Drei von DUELs margenbasierten Kennzahlen — operative Cashflow-Marge, operative Marge und FCF-Marge — korrelieren untereinander bei r ≈ 0,66–0,76. Das ist kein Zufall der Namensgebung: Alle drei sind mechanisch unterschiedliche Zähler (operativer Cashflow, operatives Ergebnis, operativer Cashflow minus CapEx), geteilt durch denselben Nenner (Umsatz). Ein Unternehmen mit hoher operativer Marge tendiert dazu, diese in ähnlichem Verhältnis in Cash umzuwandeln. Getrennt davon bewegen sich Asset Turnover und Receivables Turnover — beide Umsatz-über-Bilanzposten-Kennzahlen — bei r ≈ 0,56 gemeinsam, genau die Art von "gleicher-Nenner"-Clusterbildung, die Chen und Shimerda (1981) vor vierzig Jahren in einem anderen Datensatz dokumentierten. ROIC zeigt jetzt eine klarere Beziehung sowohl zum Margen-Cluster als auch zum Turnover-Cluster als in der kleineren Stichprobe — ein Punkt, auf den wir unten zurückkommen.
Die eine Kennzahl, die in beiden Matrizen, bei beiden Stichprobengrößen, für sich steht: die Sloan Ratio. Ihre stärkste Korrelation mit irgendetwas anderem im Panel beträgt -0,30 (Spearman, gegenüber Receivables Turnover) — schwächer als fast jedes Paar in der obigen Tabelle. Die Sloan Ratio misst etwas, das die anderen sieben Kennzahlen nicht messen: ob buchhalterische Gewinne mit ungewöhnlich hohen Accruals statt mit Cash generiert werden. Das ist eine grundlegend andere Frage als "wie profitabel" oder "wie effizient", und die Korrelationsmatrix spiegelt das bei 50 wie bei 60 Unternehmen wider.
Wie viele Komponenten? (und warum sich die Antwort verändert hat)
| HK | Eigenwert | Erklärte Varianz | Kumuliert |
|---|---|---|---|
| HK1 | 3,17 | 39,0 % | 39,0 % |
| HK2 | 2,15 | 26,4 % | 65,4 % |
| HK3 | 0,91 | 11,1 % | 76,6 % |
| HK4 | 0,73 | 8,9 % | 85,5 % |
| HK5–HK8 | je <0,5 | — | 100 % |
Nach dem Kaiser-Kriterium (Eigenwert > 1) sind weiterhin zwei Komponenten relevant — konsistent mit dem ersten Durchlauf. Aber die Schwelle von 80 % kumulierter Varianz liegt jetzt bei vier Komponenten (76,6 % bei drei, 85,5 % bei vier), nicht bei drei. Das Hinzufügen von 10 Unternehmen hat nicht nur Präzision hinzugefügt — es hat verändert, welche Schwelle die dritte Komponente überschreitet.
Es lohnt sich, hierüber transparent zu sein, statt es still zu glätten. Es ist ein Lehrbuchbeispiel für genau die Instabilität, vor der Guadagnoli und Velicer (1988) sowie Comrey und Lee (1992) bei dieser Stichprobengröße warnen: Komponentenlösungen mit kleinem N können sich verschieben, wenn Daten hinzukommen, und eine Komponente, die genau an einer Schwelle liegt (HK3 lag bei 80,0 % mit 46 Unternehmen, bei 76,6 % mit 56), ist das Erste, das sich bewegt. Wir berichten unten die 4-Komponenten-Lösung, weil sie diejenige ist, die das genannte 80-%-Kriterium bei der größeren, aktuelleren Stichprobe tatsächlich erfüllt — nicht weil sie eine ordentlichere Geschichte erzählt.
Was die Komponenten tatsächlich messen
Varimax-Rotation der vier für 80 %+ Varianz benötigten Komponenten, auf den 56 Unternehmen mit vollständigen Datensätzen:
| Kennzahl | RC1 "Cash-Konversion" | RC2 "Kapitaleffizienz" | RC3 "Accrual-Qualität" | RC4 "Wachstum" |
|---|---|---|---|---|
| Operative Marge | 0,59 | 0,08 | 0,04 | -0,07 |
| Operative Cashflow-Marge | 0,50 | -0,17 | 0,04 | 0,05 |
| FCF-Marge | 0,43 | -0,12 | -0,22 | 0,17 |
| ROIC | 0,41 | 0,58 | 0,12 | -0,24 |
| Asset Turnover | -0,14 | 0,60 | 0,08 | 0,06 |
| Receivables Turnover | -0,14 | 0,49 | -0,23 | 0,11 |
| Sloan Ratio | -0,02 | -0,03 | 0,93 | 0,05 |
| Umsatzwachstum | 0,07 | 0,09 | 0,04 | 0,94 |
Die größere Stichprobe trennte das Umsatzwachstum vom Margen-Cluster, statt damit zu verschmelzen — bei 50 Unternehmen lag die dominante Ladung des Umsatzwachstums bei 0,42 auf dem Margenfaktor; bei 60 liegt sie bei 0,94 auf seinem eigenen Faktor und praktisch bei null überall sonst. Im Rückblick ergibt das ökonomischen Sinn: Ein Unternehmen kann schnell wachsen und dabei dünne Margen haben (viele der neueren Software- und Reise-Namen in diesem Update — CCL, RCL, XYZ — sind genau diese Mischung), sodass Wachstum und Margenqualität sich nicht zwangsläufig gemeinsam bewegen müssen, und mit mehr Unternehmen im Panel machte der Datensatz diese Unterscheidung klar, statt sie in einen Faktor zu verwischen.
Auch das Bild des ROIC wurde schärfer: Er lädt jetzt sowohl auf den Cash-Konversions-Faktor (0,41) als auch auf die Kapitaleffizienz (0,58, weiterhin dominant) — eine Erinnerung daran, dass ROIC konstruktionsbedingt eine Mischung aus einem margenähnlichen Element (Rendite) und einem umschlagähnlichen Element (Kapitalintensität) ist, sodass eine gewisse Querladung eher zu erwarten als ein Datenartefakt ist.
Auf DUELs tatsächliche Bewertungsgewichte abgebildet, lösen sich die acht Kennzahlen nun in vier statt drei effektive Blöcke auf:
| Empirischer Faktor | Kennzahlen | Kombiniertes Nominalgewicht |
|---|---|---|
| RC1 — Cash-Konversion | Operative Cashflow-Marge, Operative Marge, FCF-Marge | 39 % |
| RC2 — Kapitaleffizienz | ROIC, Asset Turnover, Receivables Turnover | 33 % |
| RC4 — Wachstum | Umsatzwachstum | 16 % |
| RC3 — Accrual-Qualität | Sloan Ratio | 12 % |
39/33/16/12 — merklich ausgewogener als die 55/33/12-Dreifaktoraufteilung aus der kleineren Stichprobe, und das ergab sich von selbst, aus mehr Daten, nicht aus irgendeiner Anpassung des Modells.
Diskussion
Der Befund weist in eine Richtung, die leicht zu übersehen ist, wenn man "Redundanz" nur als Fehler betrachtet. Zwei Dinge sind gleichzeitig wahr:
Erstens: Etwa 72 % des nominalen Gewichts des Modells (der 39-%-Cash-Konversions-Block plus der 33-%-Kapitaleffizienz-Block) beruhen auf zwei empirischen Signalen, nicht auf sechs. Wenn operative Marge, operative Cashflow-Marge und FCF-Marge alle dasselbe Unternehmen favorisieren — was laut Korrelationsstruktur häufiger passiert als durch Zufall — sammelt dieses Unternehmen nicht drei unabhängige Stimmen. Es sammelt eine starke Stimme, dreifach gezählt. Das führt nicht notwendigerweise zu einem "falschen" Sieger; Margenqualität ist tatsächlich informativer als jede einzelne Kennzahl, die sie misst. Aber es bedeutet, dass sich die praktische Gewichtsverteilung wie ein 4-Faktor-Modell (39/33/16/12) verhält, nicht wie das 8-Faktor-Modell, das die Scorecard zeigt.
Zweitens, und das ist der Teil, bei dem es sich lohnt zu verweilen: Die Kennzahl, die ein flüchtiger Leser vielleicht für die "redundanteste Zugabe" hält — die Sloan Ratio, jene, die die meisten nicht dem Namen nach kennen — ist statistisch die am wenigsten redundante Kennzahl im gesamten Modell, bei beiden von uns getesteten Stichprobengrößen. Sie teilt fast keine Varianz mit irgendetwas anderem, das DUEL misst. In unserer früheren Duell-Berichterstattung erwies sich die Sloan Ratio als die einzige Kennzahl, die Ertragsqualitätsrisiken in einem sonst stark aussehenden Unternehmen aufzeigte. Diese Analyse zeigt, dass das kein Zufall eines Einzelfalls ist: Strukturell erfüllt die Sloan Ratio eine Aufgabe, für die keine der anderen sieben Kennzahlen ausgelegt ist, und genau deshalb ist sie mit ihnen unkorreliert.
Ein praktischer Hinweis für Leser, die "39/33/16/12" sehen und denken "einfach die Gewichte reparieren"
Zwei intuitive Reaktionen auf einen solchen Befund lohnt es sich, direkt anzusprechen, weil beide auf dieselbe subtile Weise falsch sind.
Reaktion eins: "Wenn die reale Struktur vier Faktoren hat, dann kürze das Modell einfach auf vier Kennzahlen." Das verwechselt statistische Überlappung mit Verschwendung. Wenn drei Margenkennzahlen sich bei einem Unternehmen einig sind, sagen diese drei Kennzahlen nicht dreimal dasselbe, ohne etwas Neues zu sagen — es sind drei unabhängig berechnete Zahlen (aus operativem Cashflow, aus operativem Ergebnis, aus operativem Cashflow minus CapEx), die zur selben Schlussfolgerung konvergieren. Diese Konvergenz ähnelt eher einer Zweit- und Drittmeinung aus unterschiedlichen Tests als einem einzigen, dreimal gestellten Test. Ein Arzt, der Blutdruck, Ruhepuls und ein EKG anordnet, verschwendet nicht zwei Tests nur weil sich alle drei bei einem gesunden Patienten meist gemeinsam bewegen — die Übereinstimmung selbst ist informativ, und bei dem seltenen Unternehmen, bei dem sie sich widersprechen, ist genau dieser Widerspruch die Art von Signal, die ein Ein-Kennzahl-Modell völlig übersehen würde. Auf vier Kennzahlen zu reduzieren würde diese Gegenprüfung entfernen, nicht nur die Redundanz.
Reaktion zwei: "Wenn die Sloan Ratio am wenigsten redundant ist, gib ihr ~30 % Gewicht, damit die Faktoren bei etwa 33/33/33 landen." Das ist eine ausgefeilter klingende Version desselben Fehlers. PCA sagt Ihnen, wie stark eine Kennzahl mit den anderen überlappt — sie sagt nichts darüber aus, wie zuverlässig oder prognosestark diese Kennzahl für sich allein ist. Die Sloan Ratio wird aus nur einer buchhalterischen Beziehung berechnet (Nettoergebnis gegenüber Cashflow gegenüber Gesamtvermögen), sie ist anfälliger für das in jedem Battle-Report-Disclaimer erwähnte Quartal/Jahr-Periodenmismatch-Problem, und — wie dieses Panel selbst zeigt (SNDKs Sloan Ratio von +27,6 %, getrieben durch ein ungewöhnliches Jahr mit Vermögensverkäufen, ist der extremste Wert im gesamten Datensatz) — sie kann durch einmalige Buchhaltungsereignisse stark ausschlagen. Ihr Gewicht zu verdreifachen, nur weil sie statistisch mit allem anderen unkorreliert ist, würde bedeuten, ein Drittel des Endergebnisses auf die einzige verrauschteste, am wenigsten diversifizierte Kennzahl im Modell zu setzen. "Unabhängig" zu sein und "bei hoher Gewichtung vertrauenswürdig" zu sein, sind nicht dieselbe Eigenschaft, und beides zu vermischen ist ein größerer Fehler als die Redundanz, mit der dieser Beitrag begonnen hat.
Wofür das konkret spricht:
- Keine Änderung an den acht veröffentlichten Kennzahlen oder ihren Gewichten auf duelstocks.com. Jede Kennzahl ist weiterhin eine reale, eigenständige, aus SEC-Daten abgeleitete Berechnung, vollständig sichtbar im Berechnungsdetail jedes Reports — nichts hier legt nahe, dass eine Zahl erfunden, verdoppelt oder falsch ist. Dies ist ein Befund über statistisches Verhalten über viele Unternehmen hinweg, kein Mangel in einem einzelnen Duell.
- Die ehrliche Lesart von "39/33/16/12" ist eine Karte, kein Urteil. Sie sagt Ihnen, dass das Verschieben einer der drei Cash-Konversions-Kennzahlen oder einer der drei Kapitaleffizienz-Kennzahlen weniger bewirken wird, als Sie erwarten würden (ihre Schwester-Kennzahlen ziehen zur gleichen Schlussfolgerung), während Sloan Ratio und Umsatzwachstum jeweils ihr volles, unverdünntes Nominalgewicht tragen, falls Sie das Ergebnis eines Duells maßgeblich ändern wollen.
- Der eigentliche nächste Test ist eine Robustheitsprüfung, keine Neugewichtung. Die offene, testbare Frage, die dies für künftige Berichterstattung aufwirft: Ändert eine tatsächliche Halbierung des kombinierten Gewichts der drei Cash-Konversions-Kennzahlen den Sieger irgendeines vergangenen Duells? Wenn die Antwort "selten" lautet, ist das beruhigend — es bedeutet, dass die Überlappung eine Bestätigung ist, keine Manipulation des Scores durch Dreifachzählung. Wenn sie mehrere Ergebnisse ändert, ist das auch wissenswert. In jedem Fall ist das eine Frage für einen Folgebeitrag mit einer Backtesting-Infrastruktur, die dieses Projekt noch nicht hat — kein Grund, eine Formel basierend auf einem einzigen explorativen PCA-Durchlauf händisch anzupassen.
Einschränkungen
Dies ist eine Pilotstudie und sollte auch so gelesen werden:
- Stichprobengröße. 56–60 Unternehmen sind näher an einem komfortablen Niveau als unser erster Durchlauf (46–50), liegen aber weiterhin unter Comrey und Lees (1992) "schlecht"-Schwelle von 100. Die Komponentenstruktur hat sich bereits einmal zwischen 50 und 60 Unternehmen verschoben (drei Faktoren → vier) — ein direkter Beleg dafür, dass sie sich mit der nächsten Charge erneut verschieben könnte. Behandeln Sie die 39/33/16/12-Aufteilung als aktuell beste Schätzung, nicht als feststehende Zahl.
- Querschnittlich, nicht längsschnittlich. Dies ist eine Momentaufnahme. Ob dieselbe Vierfaktorstruktur in einem Jahr, über einen vollen Marktzyklus hinweg, Bestand hat, ist eine offene Frage — und wahrscheinlich der natürliche nächste Schritt für diese Forschungslinie.
- Gemischte Berichtsperioden. Mehrere Unternehmen in diesem Panel mischen quartalsweise und jährliche Perioden für einzelne Kennzahlen (wie in jedem Battle Report vermerkt). Wir haben hier keine TTM-Harmonisierungskorrektur angewendet; falls diese Korrektur einzelne Unternehmenswerte spürbar verschiebt, könnte sie auch die Korrelationsstruktur am Rand verschieben. Das ist eine separate methodische Frage, die wir möglicherweise in einem künftigen Beitrag direkt aufgreifen.
- Vier Unternehmen mit fehlenden Kennzahlen. OXY und COP wurden von der PCA ausgeschlossen (fehlende ROIC-/operative-Marge-Daten), und NFLX/PEP wurden in die Korrelationen, aber nicht in die PCA einbezogen (fehlender Receivables Turnover). Keines wurde wegen seiner Ergebnisse ausgeschlossen — nur wegen Datenlücken.
Nichts davon ändert DUELs tatsächliche Bewertung im Produkt. Es ist ein methodischer Befund, keine Produktentscheidung — dieselbe Unterscheidung, die wir in jedem Beitrag dieser Serie einzuhalten versucht haben.
Fazit
Acht Kennzahlen, ein festes Gewichtungsschema, und — in diesem nun 60-Unternehmen-Piloten — vier empirisch unterscheidbare Signale darunter: Cash-Konversion, Kapitaleffizienz, Accrual-Qualität und Wachstum, jedes davon verhält sich getrennt von den anderen. Die nominale Aufteilung von 16/15/15/12/10/8/12/12 % ist in der Praxis näher an einer Aufteilung von 39/33/16/12 %, sobald man berücksichtigt, was die Kennzahlen tatsächlich messen im Vergleich zu dem, wie sie benannt sind — und diese Zahl bewegte sich mit wachsender Stichprobe in Richtung mehr Balance, nicht weniger, ohne dass jemand die Formel angerührt hat. Das ist ein Grund, weiter Daten zu sammeln, kein Grund, Gewichte basierend auf einem einzigen Durchlauf händisch anzupassen.
Wie immer: Rechnen Sie die Zahlen selbst auf duelstocks.com nach — jeder Duell-Report zeigt sein vollständiges Berechnungsdetail, was diese Analyse überhaupt erst möglich gemacht hat.
Quellen
Chen, K. H., & Shimerda, T. A. (1981). An empirical analysis of useful financial ratios. Financial Management, 10(1), 51–60.
Comrey, A. L., & Lee, H. B. (1992). A First Course in Factor Analysis (2. Aufl.). Erlbaum.
Gombola, M. J., & Ketz, J. E. (1983). A note on cash flow and classification patterns of financial ratios. The Accounting Review, 58(1), 105–114.
Guadagnoli, E., & Velicer, W. F. (1988). Relation of sample size to the stability of component patterns. Psychological Bulletin, 103(2), 265–275.
Jolliffe, I. T. (2002). Principal Component Analysis (2. Aufl.). Springer.
Kaiser, H. F. (1958). The varimax criterion for analytic rotation in factor analysis. Psychometrika, 23(3), 187–200.
Nunnally, J. C. (1978). Psychometric Theory (2. Aufl.). McGraw-Hill.
Pinches, G. E., Mingo, K. A., & Caruthers, J. K. (1973). The stability of financial patterns in industrial organizations. Journal of Finance, 28(2), 389–396.
Sloan, R. G. (1996). Do stock prices fully reflect information in accruals and cash flows about future earnings? The Accounting Review, 71(3), 289–315.
Keine Anlageberatung. Alle Daten stammen aus öffentlichen SEC-EDGAR-Meldungen.
Historischer Hinweis. Dieser Beitrag beschreibt die inzwischen abgeschaffte Winner-take-all-Regel von DUEL, bei der das besser bewertete Unternehmen pro Kennzahl das gesamte Gewicht dieser Kennzahl erhielt. DUEL verwendet heute weiche Relativscores, die jede Kennzahl nach der Größe des Abstands skalieren, nicht nur nach ihrem Vorzeichen — siehe „Wie anfällig ist der neue relative Aktien-Score?" weiter oben.
Methodische Tiefenanalyse, echte Zahlen aus echten Duellen, von Grund auf berechnet und verifiziert. Keine Anlageberatung.
Unser erster Beitrag in dieser Serie hat etwas markiert, das eine erneute Betrachtung wert ist: Die Gewichtungen hinter unserem relativen "Duell"-Score — Umsatzwachstum 16 %, operative Cashflow-Marge 15 %, ROIC 15 %, Sloan Ratio 12 %, Asset Turnover 10 %, Receivables Turnover 8 %, operative Marge 12 %, FCF-Marge 12 % — sind ein vernünftiger Expertenausgangspunkt, kein gegen realisierte Renditen zurückgetestetes Ergebnis. Das Tool erlaubt jedem Nutzer, diese durch eigene Gewichtungen zu überschreiben, was eine Frage aufwirft, die es wert ist, auf drei unterschiedlichen Rigor-Ebenen tatsächlich getestet zu werden: Wie stark ändert sich der Sieger, wenn eine vernünftige Person andere, gleichermaßen vertretbare Gewichtungen wählt?
Ebene 1: Wie der Score funktioniert, und eine klare Fragilitätszahl
Für jede der acht Kennzahlen werden die beiden Unternehmen verglichen, und das besser bewertete (bei der Sloan Ratio, die invertiert ist, das niedriger bewertete) erhält das gesamte Gewicht dieser Kennzahl — Winner-take-all pro Kennzahl, nicht abgestuft nach der Größe der Lücke. Der Endscore ist die Summe der Gewichte, die den Kennzahlen zugeordnet sind, die das jeweilige Unternehmen gewinnt. Wir haben dies validiert, indem wir den exakten Score aller 8 bisher veröffentlichten Duelle aus den Rohkennzahlwerten neu abgeleitet haben — jeder stimmte exakt überein.
Diese Struktur liefert kostenlos ein klares, modellfreies Fragilitätsmaß: Das Verschieben von Gewicht Δ von einer Kennzahl, die der Sieger gewonnen hat, zu einer Kennzahl, die der Verlierer gewonnen hat, verändert die Score-Lücke um 2Δ — die minimale Umverteilung, die nötig ist, um ein Duell zu kippen, ist also einfach Lücke ÷ 2.
| Duell | Score | Lücke | Gewichtspunkte zum Kippen |
|---|---|---|---|
| NVDA vs. AMD | 92:8 | 84 | 42,0 |
| GOOGL vs. META | 10:90 | 80 | 40,0 |
| AMZN vs. WMT | 55:45 | 10 | 5,0 |
| CRM vs. NOW | 32:68 | 36 | 18,0 |
| VRTX vs. REGN | 61:39 | 22 | 11,0 |
| GFF vs. WOR | 73:27 | 46 | 23,0 |
| BHE vs. PLAB | 30:70 | 40 | 20,0 |
| KO vs. PEP | 75:25 | 50 | 25,0 |
AMZN vs. WMT ist der klare Ausreißer — um eine Größenordnung anfälliger als alles andere im Datensatz.
Ebene 2: Monte Carlo — stimmt der Zufall mit der Algebra überein?
Die Zahl Lücke÷2 ist exakt, aber statisch — sie sagt nicht, wie wahrscheinlich ein Kippen ist, wenn Gewichtungen aus einer realistischen Spanne gezogen werden, statt gezielt konstruiert zu sein. Wir führten 10.000 Simulationen pro Duell durch, wobei jedes Gewicht unabhängig aus ±50 % seines Standardwerts gezogen und anschließend auf eine Summe von 100 % renormalisiert wurde — ein Standard-Perturbationsansatz zum Testen der Sensitivität in Multi-Kriterien-Bewertungssystemen.
| Duell | Lücke | Monte-Carlo-Kipprate (10.000 Ziehungen) |
|---|---|---|
| NVDA vs. AMD | 84 | 0,0 % |
| GOOGL vs. META | 80 | 0,0 % |
| AMZN vs. WMT | 10 | 14,8 % |
| CRM vs. NOW | 36 | 0,0 % |
| VRTX vs. REGN | 22 | 1,3 % |
| GFF vs. WOR | 46 | 0,0 % |
| BHE vs. PLAB | 40 | 0,0 % |
| KO vs. PEP | 50 | 0,0 % |
Simulation und Algebra stimmen vollständig überein: Jedes Duell mit einer Lücke ≥36 kippte in keiner der 10.000 zufälligen Ziehungen. Die beiden knapperen Duelle (Lücke ≤22) sind die einzigen, die überhaupt kippen, und die Rate skaliert damit, wie nahe die Lücke bei null liegt. Diese Übereinstimmung ist selbst bemerkenswert — eine rein kombinatorische Abkürzung (Lücke÷2) sagte das empirische Simulationsergebnis voraus, ohne eine einzige Zufallsziehung durchzuführen.
Eine weitere Sache, die die Simulation offenbart, die die Algebra allein nicht zeigen kann: welche Kennzahl typischerweise das Kippen verursacht. Betrachtet man speziell die 14,8 % der AMZN-vs.-WMT-Simulationen, in denen der Sieger wechselte, kann man fragen, welcher Faktor in diesen spezifischen Ziehungen zufällig das größte Gewicht trug:
- ROIC war in 64,6 % der Kipp-Fälle das größte Gewicht
- Sloan Ratio in 12,4 %
- Umsatzwachstum in 9,6 %
- Alles andere zusammen unter 14 %
ROIC dominiert den Kippmechanismus für dieses Paar mit deutlichem Abstand — eine nützliche, konkrete Antwort auf "was entscheidet das hier eigentlich", nicht nur "wie wahrscheinlich ist ein Kippen".
Ebene 3: Entspricht das Gewicht einer Kennzahl tatsächlich ihrer Macht? (Shapley-Shubik- und Banzhaf-Indizes)
Hier ist eine subtilere Frage, die die ersten beiden Ebenen überhaupt nicht behandeln: Ist das angegebene Gewicht einer Kennzahl dasselbe wie ihr tatsächlicher Einfluss darauf, wer gewinnt? 1954 stellten Lloyd Shapley und Martin Shubik genau diese Frage zu gewichteten Abstimmungsgremien (es ist dieselbe Mathematik, die später zur Analyse der Abstimmungsmacht im EU-Ministerrat und im UN-Sicherheitsrat verwendet wurde) — und zeigten, dass nominaler Stimmenanteil und tatsächliche entscheidende Macht häufig nicht dieselbe Zahl sind. Ein Stimmblock kann 20 % der Stimmen halten und fast keine Macht haben, irgendein Ergebnis zu ändern, oder 10 % halten und ständig ausschlaggebend sein, je nachdem, wie sich die übrigen Stimmen verteilen.
Unsere Winner-take-all-pro-Kennzahl-Struktur ist, mathematisch betrachtet, genau diese Art von gewichtetem Abstimmungsspiel: acht "Wähler" (die Kennzahlen), jeder mit einem festen Gewicht, entscheiden per einfacher Mehrheit (>50 %), welche Seite gewinnt. Also berechneten wir den Shapley-Shubik-Index (und, als Gegenkontrolle, den verwandten Banzhaf-Index) für jede Kennzahl unter den Standardgewichtungen — indem wir über alle 2⁸ = 256 möglichen Arten, wie die acht Kennzahlen zwischen zwei Seiten aufgeteilt werden könnten, auswerteten, wie oft jede Kennzahl diejenige ist, die das Ergebnis über die Linie kippt.
| Kennzahl | Angegebenes Gewicht | Shapley-Shubik-Macht | Macht ÷ Gewicht |
|---|---|---|---|
| Umsatzwachstum | 16,0 % | 18,2 % | 1,14x |
| Operative Cashflow-Marge | 15,0 % | 16,1 % | 1,07x |
| ROIC | 15,0 % | 16,1 % | 1,07x |
| Sloan Ratio | 12,0 % | 11,8 % | 0,98x |
| Operative Marge | 12,0 % | 11,8 % | 0,98x |
| FCF-Marge | 12,0 % | 11,8 % | 0,98x |
| Asset Turnover | 10,0 % | 8,2 % | 0,82x |
| Receivables Turnover | 8,0 % | 6,1 % | 0,76x |
Das Muster ist real, wenn auch begrenzt statt dramatisch: Größere Kennzahlen tragen systematisch mehr entscheidende Macht, als ihr angegebenes Gewicht nahelegt, kleinere systematisch weniger. Receivables Turnover ist der klarste Fall — sein veröffentlichtes Gewicht (8 %) überschätzt seinen tatsächlichen Einfluss auf Ergebnisse stärker als bei jeder anderen Kennzahl, und dasselbe Muster (kleinstes Gewicht, am stärksten überschätzt) bestätigte sich, als wir die Berechnung unter allen vier offiziell dokumentierten alternativen Gewichtungsprofilen von DUEL (Growth, Quality, Value, Dividend & Stability) erneut durchführten. Das ist kein Fehler, der spezifisch für dieses Tool ist — es ist eine strukturelle Eigenschaft jedes Winner-take-all-gewichteten Bewertungssystems, erstmals vor 70 Jahren in einem völlig anderen Feld (Abstimmungstheorie) formalisiert, und sie gilt hier, ohne dass sie jemand absichtlich eingebaut hätte.
Test gegen die echten, veröffentlichten Anlegerprofile
DUEL dokumentiert vier benannte Gewichtungsprofile für unterschiedliche Anlegerstile. Wendet man alle vier auf unsere 8 Duelle an:
| Duell | Standard | Growth | Quality | Value | Dividend |
|---|---|---|---|---|---|
| NVDA vs. AMD | 92:8 | 95:5 | 95:5 | 85:15 | 92:8 |
| GOOGL vs. META | 10:90 | 8:92 | 8:92 | 18:82 | 10:90 |
| AMZN vs. WMT | 55:45 | 67:33 | 44:56 (gekippt) | 40:60 (gekippt) | 60:40 |
| CRM vs. NOW | 32:68 | 37:63 | 17:83 | 32:68 | 40:60 |
| VRTX vs. REGN | 61:39 | 64:36 | 56:44 | 65:35 | 56:44 |
| GFF vs. WOR | 73:27 | 72:28 | 74:26 | 80:20 | 66:34 |
| BHE vs. PLAB | 30:70 | 21:79 | 31:69 | 48:52 | 28:72 |
| KO vs. PEP | 75:25 | 72:28 | 84:16 | 72:28 | 71:29 |
Nur AMZN vs. WMT kippt — dasselbe Duell, das jede andere Methode in diesem Beitrag unabhängig als das fragile markiert hat. BHE vs. PLAB ist es wert, gesondert genannt zu werden: Es verdichtet sich von einem 40-Punkte-Blowout unter dem Value-Profil auf einen Fast-Münzwurf (48:52), ohne technisch zu kippen, weil BHE speziell die beiden Kennzahlen — Asset Turnover und Receivables Turnover — gewinnt, auf die das Value-Profil sein Gewicht konzentriert.
Was das tatsächlich löst, und was nicht
Die ursprüngliche Einschränkung war, dass die Basisgewichtungen eine heuristische Wahl sind, keine zurückgetestete. Keine der drei hier vorgestellten Methoden beantwortet, ob 16/15/15/12/10/8/12/12 zukünftige Renditen besser vorhersagt als jede Alternative — diese Kalibrierungsfrage bleibt offen. Was wir jetzt mit drei unabhängigen, übereinstimmenden Methoden sagen können: Die Basisgewichtung ist nicht in einer Weise fragil, die für die praktische Nutzung relevant wäre. Ein breiter Duell-Score (Lücke ≥30-ish) überlebte jede zufällige Störung, die wir auf ihn anwandten, und jedes echte, benannte alternative Profil. Ein knapper Score ist genau der Punkt, an dem alle drei Methoden in derselben Warnung konvergieren — und dank der Shapley-Shubik-Ebene wissen wir jetzt auch, dass die zugrundeliegende Bewertungsstruktur systematisch kleinere Kennzahlen wie Receivables Turnover unterbewertet, unabhängig davon, welches Duell man betrachtet. Das ist ein echt neuer, struktureller Befund über den Mechanismus selbst, nicht nur über einen einzelnen Vergleich — die Art von Ergebnis, die man nur erhält, wenn man die Grundlagen des Modells mit Werkzeugen testet, die genau für diese Frage entwickelt wurden, statt Gewichtungen ein Profil nach dem anderen zu testen.
Quellen
Shapley, L. S., & Shubik, M. (1954). "A Method for Evaluating the Distribution of Power in a Committee System." American Political Science Review, 48(3), 787–792.
Banzhaf, J. F. (1965). "Weighted Voting Doesn't Work: A Mathematical Analysis." Rutgers Law Review, 19, 317–343.
Sloan, R. G. (1996). "Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings?" The Accounting Review, 71(3), 289–315.
Saaty, T. L. (1980). The Analytic Hierarchy Process. McGraw-Hill.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3. Aufl.). Wiley.
Wenn Sie irgendetwas davon selbst nachvollziehen möchten — eigene Gewichtungen einsetzen oder ein von uns nicht behandeltes Paar testen — das Live-Tool kann kostenlos auf duelstocks.com ausprobiert werden; jede Zahl in diesem Beitrag lässt sich auf einen Report zurückführen, den Sie dort direkt abrufen können.
Keine Anlageberatung. Alle Daten stammen aus öffentlichen SEC-EDGAR-Meldungen.
Methodische Tiefenanalyse, echte Zahlen aus echten Duellen. Keine Anlageberatung.
Vor zwei Beiträgen haben wir in unserer Liste ehrlicher Einschränkungen diese markiert: Unser DCF-Modell gibt eine einzelne Zahl aus — 176,47 $, nicht "165–190 $" — ohne jeden Anhaltspunkt dafür, wie sehr man dieser Präzision vertrauen sollte. Damodaran weist seit Jahrzehnten darauf hin: Allein der Terminalwert macht typischerweise 60–80 % des Unternehmenswerts aus, aufgebaut auf einer nicht überprüfbaren Annahme über ewiges Wachstum. Eine auf den Cent genaue Zahl, die auf einem so wenig präzisen Fundament ruht.
Dieser Beitrag befasst sich damit, genau diese Lücke zu schließen — eine einzelne Fair-Value-Zahl in eine verteidigbare Bandbreite zu verwandeln, ohne irgendetwas zu verwenden, das das Modell nicht bereits veröffentlicht.
Warum nicht Monte Carlo
Eine vollständige Simulation benötigt angenommene Wahrscheinlichkeitsverteilungen für jeden Input — Formen, die wir mit den vorliegenden Daten nicht ehrlich rechtfertigen können. Also verwendeten wir etwas Älteres und Einfacheres: die Dreipunktschätzung (PERT), 1959 für das Polaris-Raketenprogramm der US-Marine entwickelt und bis heute Standard in der Projektkostenschätzung.
Die Logik: Aus den bereits veröffentlichten Qualitätsstufen des Modells selbst ein Bear- und ein Bull-Szenario konstruieren, dann kombinieren:
Erwartungswert ≈ (Bear + 4×Basis + Bull) / 6 SD ≈ (Bull − Bear) / 6
Dieser Aufbau behandelt die Spanne (Bear, Bull) als grob ±3 Standardabweichungen und liefert ein interpretierbares 1-Sigma-Band, ohne einen einzigen neuen Input zu erfinden. Für Bear/Bull verschieben wir die eigenen dokumentierten Stufen des Modells symmetrisch um eine Stufe in jede Richtung — den ROIC-Wachstumsmultiplikator, den FCF-Margen-Multiplikator und die ROIC-basierte Beta-Stufe, die den WACC treibt — und nutzen dabei ausschließlich Schwellenwerte, die das Modell bereits offenlegt.
Das Ergebnis: 16 Unternehmen, eine Methode
| Ticker | Fairer Wert T0 | Punktschätzung 3J-Aufwärtspotenzial | PERT-angepasstes Aufwärtspotenzial | 1σ-Spanne |
|---|---|---|---|---|
| NVDA | 176,50 $ | +14,6 % | 12,0 % ± 2,6 % | [9,4 %, 14,6 %] |
| AMD | 67,77 $ | +24,0 % | 26,1 % ± 3,9 % | [22,2 %, 30,0 %] |
| GOOGL | 129,53 $ | +18,2 % | 18,8 % ± 5,2 % | [13,6 %, 24,0 %] |
| META | 524,34 $ | +16,2 % | 15,9 % ± 4,8 % | [11,1 %, 20,7 %] |
| AMZN | 255,02 $ | +18,6 % | 18,6 % ± 4,8 % | [13,8 %, 23,4 %] |
| WMT | 77,87 $ | +18,7 % | 19,1 % ± 4,5 % | [14,6 %, 23,6 %] |
| CRM | 416,84 $ | — | 13,1 % ± 4,5 % | [8,6 %, 17,6 %] |
| NOW | 113,89 $ | — | 18,4 % ± 5,4 % | [13,0 %, 23,8 %] |
| VRTX | 257,98 $ | — | 18,5 % ± 4,1 % | [14,4 %, 22,6 %] |
| REGN | 728,55 $ | — | 22,0 % ± 4,4 % | [17,6 %, 26,4 %] |
| GFF | 0,00 $ | — | — | siehe Anmerkung unten |
| WOR | 17,68 $ | — | 44,1 % ± 0,9 % | [43,2 %, 45,0 %] |
| BHE | 26,76 $ | — | 25,4 % ± 1,9 % | [23,5 %, 27,3 %] |
| PLAB | 19,78 $ | — | 16,0 % ± 1,7 % | [14,3 %, 17,7 %] |
| KO | 18,70 $ | — | 20,4 % ± 1,5 % | [18,9 %, 21,9 %] |
| PEP | 117,24 $ | — | 21,3 % ± 0,3 % | [21,0 %, 21,6 %] |
Die Breite des Bandes ist an sich schon aufschlussreich: Namen mit hohem Wachstum und hohen Multiplikatoren (NVDA, GOOGL, NOW) tragen breitere Bänder als langsame, stetige Cash-Generatoren (KO, PEP, PLAB) — genau das, was eine Sensitivitätsmethode zeigen sollte, da eine zukunftsgerichtetere Annahme mehr Raum für Uneinigkeit über sie bedeutet.
Die Frage, die dieser Beitrag eigentlich beantworten sollte
Unser erster Beitrag in dieser Serie behauptete etwas, das Aufmerksamkeit erregte: NVIDIA gewann sein relatives Fundamental-"Duell" gegen AMD mit 92:8, aber AMDs modelliertes DCF-Aufwärtspotenzial (+24,0 %) war höher als das von NVIDIA (+14,6 %) — trotz einer deutlichen Niederlage bei den operativen Kennzahlen. Die naheliegende Anschlussfrage: War diese Lücke real, oder nur Rauschen aus einer Punktschätzung, die nie Fehlerbalken hatte?
Mit angewandten PERT-Bandbreiten liegt NVIDIAs Band bei [9,4 %, 14,6 %] und AMDs bei [22,2 %, 30,0 %]. Die beiden überlappen sich nicht. Der ursprüngliche Befund überlebt die direkte Prüfung unter Parameterunsicherheit — genau die Art von Kontrolle, die unserer Meinung nach mehr Bewertungsinhalte bereit sein sollten, auf ihre eigenen früheren Behauptungen anzuwenden, statt eine Punktschätzung mit mehr Zuversicht zu wiederholen, als ihr zusteht.
Ein stiller Nebeneffekt dieser Beitragsserie
Ein Zweck dieser Serie auf duelstocks.com ist, dass sie zugleich als Audit unseres eigenen Modells dient — und dieser Beitrag hat bereits zwei kleine, konkrete Verbesserungen am Live-Tool bewirkt. Der Aufbau der Sensitivitätsbänder erforderte, die DCF-Formel von Hand gegen echte Meldungen neu herzuleiten, was einen Grenzfall zutage brachte, wie der Eigenkapitalwert für stark verschuldete Unternehmen nach unten begrenzt wird (nun transparenter behandelt statt über eine Platzhalter-Substitution) sowie eine undokumentierte Wachstums-Sicherheitsbegrenzung, die jetzt direkt im Methodikabschnitt des Reports selbst ausgewiesen ist. Wir haben die tatsächlichen Grenzen dieser Begrenzung gegen die eigene mathematische Obergrenze des Stufensystems überprüft und die Zahlen selbst unverändert gelassen — sie erwiesen sich als bereits gut kalibriert und lagen fast genau auf dem Niveau, das das Stufensystem von sich aus überhaupt erzeugen kann. Keine der beiden Änderungen verändert irgendeine Zahl in diesem Beitrag; beide werden hier der Vollständigkeit halber offengelegt, nicht weil sie der Kern des Beitrags sind.
Wie eine "Spanne" im Produkt selbst aussehen könnte
Derzeit bedeutet der Erhalt dieses Bandes, die Stufenverschiebungs-Mathematik von Hand gegen einen veröffentlichten DCF-Report zu rechnen — genau das, was dieser Beitrag Schritt für Schritt demonstriert, ohne über das hinauszugehen, was bereits in jedem DCF-Report steckt, den Sie heute abrufen können. Ein naheliegender nächster Schritt — keine Verpflichtung, nur eine Richtung, die es wert ist, benannt zu werden — wäre, dass der DCF-Report selbst diesen Korridor irgendwann direkt zeigt: eine Ober- und Untergrenze neben der Punktprognose jedes Jahres im Diagramm, plus eine kleine ergänzende Tabelle mit denselben Bear-/Basis-/Bull-Werten wie oben gezeigt. Ob das kommt oder nicht — die hier vorgestellte Methode ist von Hand vollständig aus dem Report reproduzierbar, den Sie bereits haben.
Wie viel der ursprünglichen Kritik das tatsächlich löst
Hier lohnt es sich, präzise zu sein, denn eine Übertreibung würde den Zweck der Übung zunichtemachen. Die ursprüngliche Einschränkung war, dass das Modell keine Möglichkeit bietet, einzuschätzen, wie sehr man einer einzelnen DCF-Zahl vertrauen sollte. Dieser Beitrag schließt diese Lücke auf Methodikebene: Es gibt nun einen reproduzierbaren, ohne neue Daten auskommenden Weg, um eine verteidigbare Spanne um jeden DCF-Output zu konstruieren, und wir haben gezeigt, dass sie einem echten Stresstest (dem NVDA/AMD-Vergleich) standhält. Auf Produktebene schließt sie die Lücke noch nicht — der Report selbst zeigt weiterhin nur eine Zahl, und der Aufbau der Spanne erfordert weiterhin, dass die Leserin oder der Leser die hier beschriebene Rechnung selbst durchführt. Es löst auch eine dritte, schwierigere Frage nicht, die wir nicht für uns beanspruchen beantwortet zu haben: ob diese Bänder, einmal konstruiert, tatsächlich realisierte zukünftige Preise mit einer Rate nahe der genannten ~68 % enthalten — das erfordert eine Validierung gegen tatsächliche Ergebnisse über die Zeit, was dieser Beitrag nicht versucht. Teilweiser, ehrlicher Fortschritt bei einer spezifischen, zuvor nicht angegangenen Einschränkung.
Quellen
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3. Aufl.). Wiley.
Malcolm, D. G., Roseboom, J. H., Clark, C. E., & Fazar, W. (1959). "Application of a Technique for Research and Development Program Evaluation (PERT)." Operations Research, 7(5), 646–669.
Howard, R. A. (1988). "Decision Analysis: Practice and Promise." Management Science, 34(6), 679–695.
Sloan, R. G. (1996). "Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings?" The Accounting Review, 71(3), 289–315.
Project Management Institute — PMBOK Guide, Three-Point Estimating Technique.
Keine Anlageberatung. Alle Daten stammen aus öffentlichen SEC-EDGAR-Meldungen. Offenlegung: Ich halte seit langem (~5 Jahre) eine Position in NVDA; keine Position in irgendeiner anderen genannten Aktie.
Eine DuelStocks-Pilotstudie — Absolute vs. relative Bewertung, Teil 2
1. Die offene Frage aus Teil 1
Teil 1 dieser Serie trennte zwei Fragen, die routinemäßig als eine behandelt werden:
- Relative Bewertung: Ist Unternehmen A im Vergleich zu Unternehmen B günstig oder teuer?
- Absolute Bewertung (DCF): Wie viel ist Unternehmen A für sich allein wert, basierend auf seinen eigenen prognostizierten Cashflows?
Beide Methoden auf echte Duelle anzuwenden (NVDA vs. AMD, GOOGL vs. META, AMZN vs. WMT), plus eine dritte Perspektive — unser Fundamental Resilience Index (FRI), der die Qualität von Bilanz und Cashflow unabhängig von Preis oder Wachstum bewertet — zeigte, dass der "Sieger" nach einer Methode nicht verlässlich auch der Sieger nach einer anderen ist. Drei unterschiedliche, legitime Fragen; drei unterschiedliche, legitime Antworten.
Wir haben in diesem Beitrag auch eine ehrliche Einschränkung festgehalten (Abschnitt 2.4): Ein Duell vergleicht immer nur zwei Unternehmen. Die klassische relative Bewertung vergleicht ein Unternehmen mit einer Peer-Gruppe, nicht mit einem beliebig für eine Schlagzeile ausgewählten Rivalen. Ein paarweiser "Sieger" kann gegen einen anderen Gegner völlig anders aussehen.
Dieser Beitrag ist ein direkter Versuch, diese Lücke zu schließen — und, ebenso wichtig, zu messen, wie sehr sie tatsächlich geschlossen wird, statt das nur zu behaupten.
2. Was wir zu finden erwarteten, festgehalten bevor wir hinsahen
Bevor wir die Zahlen berechneten, haben wir drei überprüfbare Erwartungen niedergeschrieben, damit die folgenden Ergebnisse gegen sie geprüft werden können, statt ihnen nachträglich angepasst zu werden:
- H1 — Beständigkeit der Divergenz. Wenn die Aufspaltung relativ/absolut/Resilienz aus Teil 1 eine reale Eigenschaft der Daten war (und kein Artefakt der Wahl eines bestimmten Paares), sollte sie auf Sektorebene erneut auftreten: Mehrere Unternehmen sollten bei einer Perspektive nahe der Spitze und bei einer anderen nahe dem Ende liegen.
- H2 — Resilienz ist orthogonal. Der FRI misst etwas strukturell anderes (Bilanzqualität) als Wachstums- und Margenfaktoren (relativer Score) oder cashflow-implizierten Wert (DCF). Wir erwarteten, dass sein Ranking schwach, nicht stark, mit den anderen beiden korreliert.
- H3 — Kleine Stichproben sind verrauscht, selbst bei einem "prinzipiengeleiteten" Modell. Ein Pilotprojekt mit 2 Runden liefert jedem Unternehmen nur 2 Datenpunkte. Wir erwarteten, dass die resultierende Rangordnung — wie mathematisch ausgefeilt die Aggregationsmethode auch sein mag — deutlich instabiler ist, als sie aussieht, und entwarfen einen Weg, genau zu quantifizieren, wie instabil, statt nur mit dem Wort "Pilot" darauf hinzuweisen.
Alle drei bestätigten sich, teilweise auf Weisen, die wir nicht vollständig vorhersahen (siehe Abschnitt 6).
3. Methode
3.1 Turnierdesign
Ein vollständiges Rundenturnier (Round-Robin) über 12 Unternehmen (jeder gegen jeden) hätte 66 Duelle erfordert — zu viel für einen Content-Piloten. Wir verwendeten die Kreismethode, den Standardalgorithmus zur Planung von Teil-Rundenturnieren im Sport und in der Psychometrie, um einen Zweirunden-Spielplan zu erstellen, bei dem der resultierende "Wer hat gegen wen gespielt"-Graph ein einzelner, zusammenhängender Zyklus ist, der alle 12 Unternehmen berührt (SWKS wurde aus der ursprünglichen 13-Namen-Gruppe entfernt — kleinstes Indexgewicht, geringste Verzerrung durch die Entfernung).
Runde 1: NVDA–ON, AVGO–MCHP, MU–MPWR, AMD–MRVL, INTC–QCOM, TXN–ADI Runde 2: NVDA–MCHP, ON–MPWR, AVGO–MRVL, MU–QCOM, AMD–ADI, INTC–TXN
Konnektivität ist hier keine Formalität, sondern entscheidend: Bradley-Terry-Stärkeschätzungen breiten sich über den Graphen von "wer hat wen geschlagen" aus. Wäre der Graph in zwei unverbundene Cluster gespalten, hätte das Modell keine Grundlage, ein Unternehmen aus dem einen Cluster mit einem aus dem anderen zu vergleichen. Ein einzelner, zusammenhängender Zyklus ist die minimale Struktur, die nötig ist, um alle 12 Namen gegeneinander zu ranken, obwohl die meisten Paare nie direkt gegeneinander gespielt haben.
3.2 Sieg/Niederlage in ein Ranking überführen
Aus den 12 Ergebnissen berechneten wir zwei relative Stärkemaße:
- Copeland-Score — Siege minus Niederlagen. Transparent, aber grob: Bei nur 2 Spielen landen die meisten Unternehmen in einem von drei Töpfen (+2, 0 oder −2), was zu breiten Gleichständen führt.
- Bradley-Terry-Bewertung (BT) — das Standardmodell für paarweise Vergleichsdaten (1952; mathematischer Vorfahre des Elo-Systems). Nach BT ist die Wahrscheinlichkeit, dass i gegen j gewinnt, s_i / (s_i + s_j), wobei s_i die geschätzte Stärke von i ist. Wir haben die Stärken durch iterative Maximum-Likelihood-Schätzung (den MM/Zermelo-Algorithmus) ermittelt, was es der Stärke erlaubt, sich transitiv auszubreiten: Ein Sieg gegen ein Team, das selbst ein starkes Team geschlagen hat, zählt mehr als ein Sieg gegen ein Team ohne jegliche Bilanz — selbst ohne direkten Vergleich zwischen den beiden indirekt verknüpften Unternehmen.
Zwei Bilanzen in diesem Datensatz sind im für BT relevanten mathematischen Sinne "perfekt": Ein Unternehmen, das jedes gespielte Spiel gewinnt, hat ohne Korrektur eine geschätzte Stärke von unendlich; ein Unternehmen, das jedes Spiel verliert, hat eine geschätzte Stärke von null. Beide sprengen das Modell. Wir haben eine Standard-Regularisierung verwendet — eine kleine Anzahl fiktiver Spiele gegen einen ligadurchschnittlichen Gegner, die jedem Unternehmen hinzugefügt werden —, die jede Schätzung endlich hält. Das ist keine kosmetische Korrektur; es ist der Mechanismus, der das Ranking mit so wenig Daten überhaupt erst möglich macht, und es bedeutet, dass die genaue numerische Lücke zwischen benachbarten Rängen nicht überinterpretiert werden sollte (mehr dazu in Abschnitt 6).
Anschließend fügten wir zwei weitere Rankings hinzu, die aus den eigenen Meldungen jedes Unternehmens stammen, unabhängig davon, gegen wen es angetreten ist:
- DCF-implizierter Bewertungsmultiplikator — Unternehmenswert ÷ Umsatz, ein Output der DUEL-DCF-Engine für jedes Unternehmen einzeln (als identisch über beide Duell-Reports eines Unternehmens verifiziert, was bestätigt, dass er nicht vom Gegner abhängt). Höher bedeutet, dass die Cashflow-Engine des Modells, gegeben die eigenen Wachstums-, Margen- und ROIC-Inputs des Unternehmens, pro Dollar Umsatz mehr Unternehmenswert zuweist. Das ist kein "Aufwärtspotenzial gegenüber dem Marktpreis" — es wird kein aktueller Marktpreis verwendet — sondern eine Querschnittsbetrachtung, welche Cashflow-Profile das Modell belohnt.
- Fundamental Resilience Index (FRI) — unser Bilanzqualitäts-Kompositindikator, ebenfalls unternehmensspezifisch.
4. Ergebnisse
4.1 Ergebnisse des Rundenturniers
| Duell | Ergebnis | Sieger |
|---|---|---|
| NVDA vs. ON | 80–20 | NVDA |
| AVGO vs. MCHP | 100–0 | AVGO |
| MU vs. MPWR | 27–73 | MPWR |
| AMD vs. MRVL | 73–27 | AMD |
| INTC vs. QCOM | 12–88 | QCOM |
| TXN vs. ADI | 57–43 | TXN |
| NVDA vs. MCHP | 100–0 | NVDA |
| ON vs. MPWR | 12–88 | MPWR |
| AVGO vs. MRVL | 100–0 | AVGO |
| MU vs. QCOM | 31–69 | QCOM |
| AMD vs. ADI | 34–66 | ADI |
| INTC vs. TXN | 8–92 | TXN |
4.2 Vier Rankings im Vergleich
| Unternehmen | Bilanz | Copeland | BT-Rang | DCF EV/Umsatz | DCF-Rang | FRI-Score | FRI-Rang |
|---|---|---|---|---|---|---|---|
| TXN | 2-0 | +2 | 1 | 1,90x | 9 | 60 (Moderat) | 11 |
| QCOM | 2-0 | +2 | 2 | 3,54x | 5 | 89 (Hoch) | 3 (gleich) |
| MPWR | 2-0 | +2 | 3 | 5,27x | 3 | 98 (Hoch) | 2 |
| NVDA | 2-0 | +2 | 4 | 19,84x | 1 | 64 (Moderat) | 10 |
| AVGO | 2-0 | +2 | 5 | 16,06x | 2 | 75 (Hoch) | 8 |
| ADI | 1-1 | 0 | 6 | 3,87x | 4 | 87 (Hoch) | 6 |
| AMD | 1-1 | 0 | 7 | 3,12x | 7 | 100 (Hoch) | 1 |
| INTC | 0-2 | -2 | 8 | k. A. (negativer EV) | 12 | 32 (Niedrig) | 12 |
| MU | 0-2 | -2 | 9 | 0,64x | 11 | 76 (Hoch) | 7 |
| ON | 0-2 | -2 | 10 | 1,93x | 8 | 88 (Hoch) | 5 |
| MCHP | 0-2 | -2 | 11 | 1,71x | 10 | 73 (Hoch) | 9 |
| MRVL | 0-2 | -2 | 12 | 3,45x | 6 | 89 (Hoch) | 3 (gleich) |
5. Wo die drei Perspektiven auseinandergehen
TXN hat beide Duelle gewonnen und liegt auf BT-Rang #1, steht aber beim DCF-Multiplikator auf #9 von 12 und bei der Resilienz auf #11 (markiert wegen erhöhter Verschuldung — Verschuldungsgrad nahe 0,9, dünne Cash-zu-Schulden-Deckung). Die beste relative Bewertungsbilanz im Turnier gehört zu einer der schwächeren absoluten Wert- und Bilanzgeschichten der Gruppe.
MRVL ist fast ein Spiegelbild: letzter Platz bei BT, aber Platz #3 (gleichauf) bei der Resilienz (FRI 89) und Mittelfeld (#6) beim DCF-Multiplikator. Eine rein relative Lesart sagt Ihnen praktisch nichts Zutreffendes über die Bilanz von MRVL.
AMD liegt sowohl bei der relativen Bilanz (1-1) als auch beim DCF-Multiplikator (#7) im Mittelfeld, hat aber den mit Abstand besten Resilienz-Score im Sektor (FRI 100 — keine markierten Widersprüche, volle Punktzahl bei jeder Untermetrik). Nichts davon ist daraus erkennbar, gegen wen AMD gewonnen hat.
NVDA und AVGO sind die beiden Namen, bei denen die DCF-Ebene mit der relativen Ebene übereinstimmt (#1 und #2 bei beiden) — aber die Resilienz weicht ab. NVDA fällt beim FRI auf #10, getrieben von einer Liquiditätsreichweite deutlich unter der Schwelle für einen "starken Puffer": ein echter Trade-off zwischen Wachstums-/Bewertungsstärke und Bilanzpuffer, kein Rauschen.
INTC ist der Kontrollfall: bei jeder Perspektive letzter oder nahezu letzter Platz, und das einzige Unternehmen, bei dem die DCF-Engine einen tatsächlich negativen Unternehmenswert zurückgibt (negativer freier Cashflow sprengt das Modell, statt die Zahl nur zu senken). Wenn das zugrundeliegende Bild insgesamt wirklich schwach ist, stimmen alle drei Methoden überein — das ist selbst aufschlussreich: Es deutet darauf hin, dass die anderswo beobachtete Divergenz ein Signal für tatsächlich gemischte Fundamentaldaten ist, nicht dafür, dass das Modell zufällig mit sich selbst uneins ist.
6. Wie sehr sollten Sie dem #1-Platz vertrauen?
Bevor man "TXN rangiert auf #1" als Erkenntnis über TXN behandelt, lohnt es sich, genau zu benennen, was diese Zahl tatsächlich treibt.
TXNs zwei Siege waren gegen INTC (0-2, keine Siege irgendwo im Netzwerk) und ADI (1-1 — dessen einzige Referenz ein einzelner Sieg gegen AMD ist). In einem Bradley-Terry-Modell zählt ein Sieg gegen ein Team, das selbst schon jemanden geschlagen hat, mehr als ein Sieg gegen ein Team mit leerer Bilanz, weil sich Stärke transitiv über den Graphen ausbreitet. NVDA, AVGO, QCOM und MPWR — die anderen vier 2-0-Teams — haben jeweils zwei Gegner geschlagen, die 0-2 waren und nirgendwo im Netzwerk einen Sieg hatten. TXN ist das einzige 2-0-Team, dessen zweiter Sieg gegen einen Gegner (ADI) kam, der selbst einen aktiven Sieg vorweisen konnte. Genau diese eine indirekte Verbindung trennt TXNs BT-Rang #1 von einem Vierer-Gleichstand an der Spitze.
Das ist kein Fehler in der Methode — genau das ist es, wofür Bradley-Terry konzipiert ist. Aber es ist auch genau die Art von Ergebnis, die Sie vorsichtig machen sollte, zu viel in ein auf 2 Spielen pro Unternehmen basierendes Ranking hineinzulesen. Um diese Vorsicht zu quantifizieren statt nur zu behaupten, führten wir eine Monte-Carlo-Prüfung durch: Simulieren Sie 12 Unternehmen mit zufälligen "wahren" Stärken, führen Sie denselben Kreismethoden-Spielplan aus, und fragen Sie, wie oft der Bradley-Terry-#1 und der einfache Copeland-#1 allein aufgrund von Stichprobenschwankung bei verschiedenen Spielplanlängen nicht übereinstimmen (4.000 simulierte Turniere pro Datenpunkt):
| Runden pro Unternehmen | BT und Copeland uneinig bei #1 |
|---|---|
| 2 (dieser Pilot) | 64,4 % |
| 4 | 34,4 % |
| 6 | 25,2 % |
| 11 (vollständiges Rundenturnier) | 4,9 % |
Bei 2 Runden ist es fast ein Münzwurf, ob die verwendete Methode für "wer ist #1" mit der einfacheren zählbasierten Methode übereinstimmt — das zeigt, dass die Raffinesse von Bradley-Terry bei dieser Stichprobengröße noch keine stabile Antwort erkauft, sondern nur eine anders instabile. Diese Instabilität ist eine Eigenschaft der Stichprobengröße, nicht spezifisch für TXN, und genau deshalb präsentieren wir dies als Pilotbefund, der mit mehr Daten überprüft werden soll, nicht als bestätigte Behauptung eines Sektorführers.
7. Wie viele Runden wären tatsächlich nötig?
Abschnitt 6 zeigt, dass der #1-Platz bei 2 Runden wackelig ist. Die naheliegende nächste Frage — und diejenige, die dieser Beitrag quantitativ statt qualitativ beantworten wollte — lautet: Wie viele Runden wären genug, und was gewinnt man bei jedem Schritt?
Wir simulierten Rundenturniere desselben 12-Unternehmen-Kreismethoden-Designs, bei Spielplanlängen von 1 Runde bis zum vollständigen 11-Runden-Rundenturnier (jedes Unternehmen spielt gegen jedes andere genau einmal), mit zufällig zugewiesenen "wahren" Stärken in jeweils 3.000 simulierten Turnieren pro Zeile. Anschließend haben wir gemessen, wie genau das resultierende Bradley-Terry-Ranking mit der (in der Simulation bekannten) wahren Stärkeordnung übereinstimmt:
| Runden pro Unternehmen | Duelle insgesamt (12 Unt.) | Rangkorrelation mit wahrer Ordnung (Spearman) | Top-3-Trefferquote | % Unternehmen mit "perfekter" Bilanz |
|---|---|---|---|---|
| 1 | 6 | 0,32 | 37,0 % | 100 % |
| 2 (dieser Pilot) | 12 | 0,47 | 48,5 % | 56,7 % |
| 3 | 18 | 0,55 | 51,1 % | 34,5 % |
| 4 | 24 | 0,60 | 55,9 % | 22,8 % |
| 5 | 30 | 0,65 | 59,4 % | 16,1 % |
| 6 | 36 | 0,68 | 60,6 % | 11,2 % |
| 8 | 48 | 0,74 | 64,2 % | 6,4 % |
| 11 (vollständiges Rundenturnier) | 66 | 0,78 | 66,9 % | 3,1 % |
Zwei Dinge fallen auf. Erstens liegt das hier verwendete Pilotdesign (2 Runden) bei einer Rangkorrelation von etwa 0,47 mit der "wahren" Ordnung — nützlich, um grobe Schichten zu erkennen, nicht verlässlich, um einen bestimmten #1-Platz zu behaupten. Zweitens beendet mehr als die Hälfte des Feldes (56,7 %) ein Zweirunden-Turnier mit einer mathematisch "perfekten" 2-0- oder 0-2-Bilanz — was entscheidend klingt, aber laut Abschnitt 6 genau die Bedingung ist, die die individuelle Rangordnung instabil macht, da eine perfekte Bilanz keine Information darüber enthält, wie viel besser ein Unternehmen ist, sondern nur, dass es jedes Spiel gewonnen hat, das es zufällig gespielt hat.
Liest man die Tabelle als Planungsleitfaden für zukünftige Turniere dieser Art:
- 1–2 Runden: günstig, schnell, gut geeignet, um grobe Schichten (klare Gewinner vs. klare Nachzügler) in Inhalten rund um einen Piloten oder einen einzelnen Publikationszyklus zu markieren. Die individuelle Platzierung innerhalb der oberen oder unteren Schicht sollte nicht als gesichert behandelt werden.
- 3–4 Runden: bei moderaten Zusatzkosten (18–24 Duelle) deutlich besser (Korrelation ~0,55–0,60); ein vernünftiges Minimum, wenn das Ranking selbst der Punkt des Beitrags ist, nicht nur die Divergenz-mit-DCF-Geschichte.
- 5–6 Runden: ein brauchbarer Mittelweg (Korrelation ~0,65–0,68) zwischen voller gruppenweiter Stringenz und den Produktionskosten für Dutzende von Duellen.
- 8+ Runden, bis hin zum vollständigen 66-Duelle-Rundenturnier: abnehmender Grenzertrag pro zusätzlicher Runde, aber das einzige Regime, in dem man einen bestimmten nummerierten Rang (statt nur eine Schicht) mit echter Zuversicht verteidigen kann.
8. Löst das die Kritik aus Teil 1?
Strukturell ja, teilweise: 12 paarweise Duelle zu einem zusammenhängenden Netzwerk zu aggregieren und jedes Unternehmen gegen die implizierte Stärke der gesamten Gruppe zu bewerten, statt gegen einen willkürlichen Gegner, ist ein echtes methodisches Upgrade gegenüber einem einzelnen Duell — es ist das, was das "Vergleich mit einer Peer-Gruppe" der klassischen relativen Bewertung tatsächlich erfordert, übersetzt in Statistik für paarweise Vergleiche.
Empirisch ist die Antwort differenzierter, und die Tabelle in Abschnitt 7 ist die ehrliche Version dieser Differenzierung. Das hier verwendete konkrete Zweirunden-Design reduziert die ursprüngliche Kritik — hebt sie aber nicht vollständig auf. Die Position eines Unternehmens im Ranking dieses Piloten ist aussagekräftiger als der Sieger eines einzelnen Duells, liegt aber laut Abschnitt 6 und 7 immer noch näher an einer grobkörnigen Einteilung in Schichten als an einem präzisen, stabilen Rang. Die Kritik aus Teil 1 (Abschnitt 2.4) liest sich jetzt am besten so: "der Art nach gelöst, dem Grad nach noch nicht" — die Methode zum Vergleich mit einer Peer-Gruppe existiert und funktioniert; sie bei einer Stichprobengröße auszuführen, die individuelle Platzierungen vertrauenswürdig macht, ist ein separater, quantifizierbarer Kostenpunkt, wie oben gezeigt.
9. Schlussfolgerungen
Die relative/absolute/Resilienz-Divergenz aus Teil 1 ist kein Artefakt der Wahl eines bestimmten Paares. Sie tritt auf Sektorebene erneut auf: TXN (#1 relativ, #9 DCF, #11 Resilienz) und MRVL (#12 relativ, #6 DCF, #3 Resilienz) zeigen Rangunterschiede von 6–8 Plätzen zwischen Perspektiven, die tatsächlich Verschiedenes messen.
Resilienz ist, wie erwartet (H2), die unabhängigste der drei Perspektiven. AMDs #1-Resilienz-Score koexistiert mit einer mittelmäßigen relativen Bilanz und einem mittelmäßigen DCF-Multiplikator; die von NVDA und AVGO geteilte #1/#2-Position bei relativ und DCF koexistiert mit Resilienz-Rängen von #10 und #8. Ein hoher Score bei Wachstums- und Margenfaktoren oder bei einem DCF-Cashflow-Multiplikator sagt Ihnen praktisch nichts über den Bilanzpuffer.
Der einzige Fall ohne Divergenz (INTC) ist auch der einzige Fall eindeutiger Notlage — bei jeder Perspektive letzter oder nahezu letzter Platz, und das einzige Unternehmen, bei dem der Output der DCF-Engine nicht nur niedrig, sondern degeneriert ist (negativer Unternehmenswert). Das ist ein Beleg dafür, dass die anderswo beobachtete Divergenz tatsächlich gemischte zugrundeliegende Bilder widerspiegelt, nicht Rauschen in den Bewertungsmethoden selbst.
Ein Zweirunden-Pilot ist richtungsweisend nützlich und individuell instabil, und das wird nun gemessen statt behauptet. Die Simulation zeigt bei dieser Designgröße eine Rangkorrelation von ~0,47 mit der "wahren" Ordnung, eine Wahrscheinlichkeit von 64,4 %, dass eine einfachere Zählmethode (Copeland) allein durch Stichprobenschwankung einen anderen #1 gekrönt hätte, und dass 56,7 % des Feldes mit einer "perfekten", informationsarmen 2-0- oder 0-2-Bilanz abschließen. Der #1-Platz in diesem Piloten (TXN) beruht auf einer einzigen indirekten Verbindung im Vergleichsgraphen (dem Sieg gegen ADI, dessen einzige Referenz ein einziger Sieg gegen AMD ist) — ein Lehrbuchbeispiel für genau diese Instabilität, kein spezifischer Mangel von TXN.
Die Kritik "Paar gegen Peer-Gruppe" aus Teil 1 ist strukturell adressiert, aber in der Praxis nur teilweise ausgeräumt. Die Methode, viele Duelle zu einem gruppenrelativen Ranking zu aggregieren, existiert und funktioniert; laut der Tabelle in Abschnitt 7 erfordert es, individuelle Rangplatzierungen (nicht nur Schichtplatzierungen) vertrauenswürdig zu machen, etwa 5–8 Runden (30–48 Duelle) statt 2 — eine konkrete, wiederverwendbare Zahl zur Planung des nächsten Turniers dieser Art, statt eines vagen Rufs nach "mehr Daten".
Dies ist ein methodischer Beitrag, keine Anlageberatung. Alle Zahlen stammen aus öffentlichen SEC-EDGAR-Meldungen (10-K/10-Q).
Jede Aktienbewertung beantwortet letztlich eine von zwei unterschiedlichen Fragen, und die meisten Debatten darüber, "welche Methode richtig ist", entstehen, weil den Beteiligten nicht bewusst ist, dass sie über unterschiedliche Fragen streiten.
Dieser Beitrag geht zunächst auf die Theorie ein und testet sie anschließend an echten Zahlen — NVIDIA (NVDA) gegen AMD (AMD), Google (GOOGL) gegen Meta (META), Amazon (AMZN) gegen Walmart (WMT) — mit einem selbst entwickelten Tool, das Fundamentaldaten direkt aus SEC-10-K/10-Q-Meldungen zieht. Keine Analystenschätzungen, keine Sentiment-Daten, keine Kursbewegungen — nur die offiziellen Meldungen.
Teil 1 — Zwei Wege, "Was ist dieses Unternehmen wert?" zu fragen
Intrinsische (absolute) Bewertung baut den Unternehmenswert von innen nach außen auf — zukünftige Cashflows projizieren, mit einem risikogerechten Satz abdiskontieren, fertig. Das geht auf John Burr Williams' The Theory of Investment Value (1938) zurück: Ein Vermögenswert ist so viel wert wie der Barwert dessen, was er künftig auszahlt. DCF-, Dividendendiskontierungs- und Residualgewinnmodelle gehören hierher.
Relative Bewertung bewertet ein Unternehmen nie für sich allein — sie bewertet es im Vergleich zu Peers, unter der Annahme, dass der Markt vergleichbare Unternehmen im Schnitt ungefähr richtig einpreist; die Lücke zwischen Ihrem Zielunternehmen und der Gruppe ist das Signal. Multiplikatoren (KGV, EV/EBITDA) und Peer-Ranking-Systeme gehören hierher.
Keine der beiden ist "richtiger". Beide beruhen auf unterschiedlichen Annahmen darüber, was man wissen kann. Absolute Bewertung setzt voraus, dass man den Markt in der Prognose übertreffen kann. Relative Bewertung setzt voraus, dass der Markt im Schnitt ungefähr richtig liegt und die eigene Aufgabe darin besteht, den Ausreißer zu finden.
Wo DCF überzeugt, und wo sie versagt
DCF ist die einzige Methode, die den Wert aus dem tatsächlichen cash-generierenden Kern des Unternehmens ableitet — unabhängig davon, was jemand für ein vergleichbares Unternehmen zahlt. Das ist mächtig, wenn ganze Sektoren durchdrehen (2000, 2021). Der Haken — von Aswath Damodaran gut dokumentiert — ist, dass DCF-Ergebnisse absurd sensibel auf drei Inputs reagieren: Wachstumsrate, Diskontsatz und Terminalwert. Allein der Terminalwert macht routinemäßig 60–80 % des gesamten Unternehmenswerts aus, basierend auf einer einzigen Punktschätzung ewigen Wachstums. Man erhält eine auf den Cent genaue Zahl, aufgebaut auf einer Annahme, die niemand überprüfen kann.
Wo Multiplikatoren überzeugen, und wo sie versagen
Sie sind schnell, skalieren über Hunderte von Titeln und erfassen Informationen, die eine Tabelle kaum abbilden kann — Managementqualität, regulatorisches Risiko, Sektor-Sentiment. Die strukturelle Schwäche ist Zirkularität: Relative Bewertung funktioniert nur, wenn die Peer-Gruppe im Schnitt korrekt bepreist ist. Ist ein ganzer Sektor überbewertet, bestätigt die relative Bewertung bereitwillig, dass Ihr Zielunternehmen "günstig im Vergleich zu Peers" ist — während die gesamte Gruppe im Verhältnis zur Realität teuer ist.
Tabelle 1 — Direkter Vergleich
| Kriterium | Absolute Bewertung (DCF / DDM / RIM) | Relative Bewertung (Multiplikatoren / Peer-Scoring) |
|---|---|---|
| Theoretische Grundlage | Barwert zukünftiger Cashflows (Williams, 1938) | Law of One Price, schwache Markteffizienz |
| Datenquelle | Prognosen der eigenen zukünftigen Unternehmensleistung | Aktuelle/historische Daten vergleichbarer Unternehmen |
| Marktabhängigkeit | Unabhängig vom aktuellen Kurs | Vollständig abhängig — Wert ist eine Funktion der Peer-Preise |
| Anzahl kritischer Annahmen | Hoch (Wachstum, WACC, terminales Wachstum) | Niedrig (Wahl der Peer-Gruppe, Gewichtung) |
| Fehleranfälligkeit | Sehr hoch — Terminalwert dominiert den Unternehmenswert | Moderat — verteilt über die Peer-Gruppe |
| Risiko systematischer Verzerrung | Analysten-Optimismus bei Wachstumsprognosen | Zirkularität — ein falsch bewerteter Sektor bestätigt sich selbst |
| Unternehmensspezifisches Risiko | Explizit (über WACC, Cashflow-Qualität) | Meist implizit oder gar nicht erfasst |
| Geschwindigkeit / Skalierbarkeit | Niedrig — arbeitsintensiv je Unternehmen | Hoch — problemlos auf Dutzende Titel anwendbar |
| Transparenz für den Nutzer | Niedrig, sofern Annahmen nicht offengelegt werden | Hoch — "günstiger als Peers" ist intuitiv |
| Widerstandsfähigkeit gegen Sektor-Blasen | Theoretisch widerstandsfähig | Anfällig — erbt die Fehlbewertung des Sektors |
| Typischer Anwender | Gutachter, langfristige Value-Investoren | Sell-Side-Analysten, Retail-Screening |
Teil 2 — Beide Methoden gleichzeitig an denselben Unternehmen testen
Statt sich für eine Methode zu entscheiden, habe ich ein Tool gebaut, das beide parallel auf denselben SEC-Daten laufen lässt, plus eine dritte Ebene zur Messung der Bilanz-Resilienz. Drei getrennte Reports, drei getrennte Fragen:
- Battle Report (relativ) — 8 Fundamentalkennzahlen (Umsatzwachstum, operative Cashflow-Marge, ROIC, Sloan Ratio, Asset Turnover, Receivables Turnover, operative Marge, FCF-Marge), gewichtet zu einem Score von 0–100 je Seite.
- DCF Report (absolut) — ein vollständiges 3-Jahres-DCF mit qualitätsadjustiertem Wachstum: ein Sloan-Ratio-Abschlag für aggressive Accrual-Buchhaltung, ein ROIC-Multiplikator, der das prognostizierte Wachstum an die Kapitaleffizienz koppelt, und ein FCF-Margen-Multiplikator für die Qualität der Cash-Konversion. Der WACC wird aus einer ROIC-Stufe abgeleitet, nicht aus historischer Kursvolatilität.
- Resilience Report — ein Fundamental Resilience Index (0–100), gebildet aus Cash-zu-Schulden-Deckung, Investitions-Selbstversorgung (FCF/CapEx), Ertragsqualität (operativer Cashflow/operatives Ergebnis) und Liquiditätsreichweite, mit einer Konsistenzmatrix, die interne Widersprüche markiert.
Ehrlich zu den Grenzen dieses Ansatzes: Es gibt keine Sensitivitätstabelle oder Monte-Carlo-Bandbreite bei der DCF-Ausgabe (ein bekannter Trade-off gegenüber einem vollständigen Punktschätzungsmodell), keine explizite Länderrisikoprämie (unproblematisch für große US-Werte, eine Lücke bei internationalen Titeln), und die relative Ebene vergleicht jeweils ein Paar statt eines vollständigen Peer-Gruppen-Medians. Nichts davon macht die Zahlen wertlos — es bedeutet nur, sie als richtungsweisenden Hinweis zu lesen, nicht als endgültige Wahrheit.
Teil 3 — Fallstudie: NVIDIA gegen AMD
Der relative Score: 92–8, "Dominant", zugunsten von NVIDIA.
| Kennzahl | NVDA | AMD | Gewichtung |
|---|---|---|---|
| Umsatzwachstum (3J CAGR) | 100,05 % | 13,64 % | 16 % |
| Operative Cashflow-Marge | 47,57 % | 22,26 % | 15 % |
| ROIC | 51,01 % | 4,46 % | 15 % |
| Operative Marge | 60,38 % | 10,66 % | 12 % |
| FCF-Marge | 47,50 % | 19,44 % | 12 % |
| Asset Turnover | 0,83x | 0,43x | 10 % |
| Receivables Turnover | 5,30x | 5,74x | 8 % |
Eine ROIC-Lücke von 51 % gegenüber 4,5 % ist kein Rundungsfehler. Rein operativ betrachtet ist das nicht knapp.
Die absolute Kennzahl erzählt eine andere Geschichte:
| Parameter | NVDA | AMD |
|---|---|---|
| Unternehmenswert (T0) | 4.285,24 Mrd. $ | 108,03 Mrd. $ |
| Fairer Wert pro Aktie (T0) | 176,47 $ | 67,72 $ |
| WACC (aus ROIC-Stufe) | 8,95 % | 11,56 % |
| Fairer Wert, +3 Jahre | 202,24 $ (+14,6 %) | 83,98 $ (+24,0 %) |
Trotz der 8:92-Niederlage im Duell fällt AMDs modelliertes 3-Jahres-Aufwärtspotenzial höher aus. NVIDIAs Dominanz ist bereits in einen Unternehmenswert von rund 4,3 Billionen Dollar eingepreist; selbst bei der im Modell gedeckelten Wachstumsrate von 35 % ist das prozentuale Aufwärtspotenzial von einer bereits riesigen Basis kleiner als AMDs bescheideneres, von einer viel niedrigeren Basis aus zusammengesetztes Wachstum. Relative Bewertung sagt Ihnen, wer gerade gewinnt. DCF sagt Ihnen, wie viel Sie für diesen Sieg bereits bezahlt haben.
Die Resilienz-Ebene fügt eine dritte, unerwartete Wendung hinzu:
| Kennzahl | NVDA | AMD |
|---|---|---|
| Resilience Index (FRI) | 64 — Moderat | 100 — Hoch |
| Cash-zu-Schulden-Deckung | 12,24x | 4,12x |
| Investitions-Selbstversorgung (FCF/CapEx) | 739,39x | 6,91x |
| Ertragsqualität (OCF/Operatives Ergebnis) | 0,79x — markiert | 2,09x |
| Liquiditätsreichweite | 0,5 Jahre — markiert | Unendlich |
Ein Unternehmen, das das Duell gerade 92:8 gewonnen hat und einen DCF-abgeleiteten Unternehmenswert von 4,28 Billionen Dollar trägt, erzielt bei der Resilienz einen niedrigeren Score als das Unternehmen, das es vernichtend geschlagen hat. Ein Vorbehalt sei erlaubt: Bei einem operativen Cashflow von 102,7 Mrd. Dollar denkt niemand ernsthaft, NVIDIA hätte ein Liquiditätsproblem — die Reichweiten-Kennzahl ist hier mit ziemlicher Sicherheit ein Formel-Artefakt bei einer Bilanzstruktur, für die die Kennzahl nicht konzipiert wurde. Aber das Ertragsqualitäts-Signal (operatives Ergebnis übersteigt operativen Cashflow) ist ein echtes, wenn auch kleines Signal, das man kennen sollte.
Gegengeprüft an zwei weiteren Paaren, am selben Tag:
| Paar | Relativer Duell-Score | Resilience Index (FRI) | DCF-Aufwärtspotenzial (+3J) |
|---|---|---|---|
| NVDA vs. AMD | 92 : 8 (NVDA) | 64 vs. 100 — AMD höher | NVDA +14,6 % vs. AMD +24,0 % |
| GOOGL vs. META | 10 : 90 (META) | 85 vs. 83 — praktisch gleich | GOOGL +18,2 % vs. META +16,2 % |
| AMZN vs. WMT | 55 : 45 (AMZN) | 100 vs. 71 — AMZN höher | AMZN +18,6 % vs. WMT +18,7 % — gleich |
Dasselbe Muster, dreimal unabhängig bestätigt: Ein einseitiger relativer Score sagt weder das Resilienz-Ranking noch das Ranking der absoluten Rendite verlässlich voraus.
Fazit
Relative Bewertung beantwortet die Frage "welches Unternehmen ist operativ gerade stärker" — und das macht sie gut. Absolute Bewertung beantwortet die Frage "wie viel von dieser Stärke ist bereits eingepreist". Eine Resilienz-Ebene beantwortet die Frage "was passiert, wenn sich die Bedingungen verschlechtern". Das sind drei unterschiedliche Fragen, und genau dort, wo man eine davon als vollständige Antwort behandelt, gehen die meisten Bewertungsdebatten — bei Profis wie bei Privatanlegern — schief.
Dies ist ein methodischer Beitrag, keine Anlageberatung. Alle Zahlen stammen aus öffentlichen SEC-EDGAR-Meldungen (10-K/10-Q).