哪只股票会 胜出?
输入两个股票代码,DUEL基于SEC EDGAR数据的8项基本面因素进行对比,几秒内显示相对赢家。
试用 DUELDUEL 能做什么
对比两只股票
几秒内对比任意两家美国上市公司。
8项基本面因素
营收增长、ROIC、现金利润率等,均基于SEC数据。
相对对比
不是绝对评分,而是回答此刻哪只股票更强。
免费 + PRO
每天5次免费对决;PRO版本无限对决并可自定义权重。
使用方法
输入两个代码
点击 DUEL
查看结果和详细分析
方法论文章
现金转化、杠杆诊断与资本配置路径——来自美国非金融大盘股同业公司 SEC 申报文件的证据。描述性方法研究。不构成投资建议。
摘要
单一因子得分能告诉投资者谁更强,却无法说明这种强势在比较的两侧是否以同样的方式形成,也无法说明今年的格局是在向去年的格局靠拢还是渐行渐远。本文提出一个更窄、更偏诊断性的问题:在分属八个 GICS 行业的十对非金融同业公司中,一家公司的静态因子水平,是否与(a)关于其会计结构的诊断标记(纸面利润、非正账面权益、资本开支吞噬、无安全垫),(b)其利润率与增长因子的同比方向,以及(c)其实际现金在最近三个财年中的去向相吻合?我们将八个源自 SEC 数据的因子、四个二元诊断标记、由连续的 10-K 直接计算的年度上期变动、构建于同一因子体系之上的行业定位图,以及覆盖二十家公司的三年资本配置台账(股息、股票回购、并购、股票发行、净债务、现金)结合起来。三项发现尤为突出。第一,纸面利润标记既不预示对决失利,也不预示现金故事恶化:本面板中最清晰的两个案例(Coca-Cola、Chevron)都赢得了配对比较,并且都同比改善了经营现金转化,因此该标记说明的是会计结构,而不是走势,也不是谁会获胜。第二,非正账面权益并非一个故事,而是两个故事:McDonald's 与 Starbucks 带有同一标记,对决结果同为 50–50,但二者的上期变动方向相反,而且当 Debt/Equity 比率本身无法获得时,两对中只有一对真正可以区分。第三,三年资本配置台账经常能回答单一因子快照留下的问题,即所报告的自由现金流利润率究竟反映的是自主的资本回馈、再投资,还是面对现金消耗路径时结构性偏薄的缓冲。我们将此视为基于公开申报文件的描述性同业诊断,而不是收益预测或择时练习,并在全文中明确声明这一边界。
1. 引言
对两家公司在同一组源自 SEC 的因子上进行相对配对比较(本站另有一篇配套文章专门讨论),解决的是一个具体问题:它抵消了会污染任何孤立比率的行业与宏观噪声,使读者比较的是信号与信号,而不是水平与水平。第二篇配套文章表明,支撑这一比较的八个因子并不是八条相互独立的信息;对最初的八因子集合做主成分分析后,它们可归结为四个在经验上可区分的成分:现金转化、资本效率、增长与应计质量。当前使用的因子集合已将 Receivables Turnover(应收账款周转率)替换为 Debt/Equity,产品将其作为第五个单独呈现的组别,与原有四组并列。凡涉及因子分组之处,本文均采用这一当前的五组分类(Growth,即增长;Margin Conversion,即利润率向现金的转化;Capital Efficiency,即资本效率;Accrual Quality,即应计质量;Financial Strength,即财务实力),包括第 6.5 节解读 Relative Price Chart(相对价格图)中的差距时。两篇文章回答的都是每个因子应占多大权重,以及两家公司此刻在这组因子上相对如何。
两篇文章都没有回答同样具有实践意义的第三个问题:这幅图景是否自洽?一家公司可以展示出诱人的营业利润率,而其现金转化却远远落后,这种模式本身就值得标记,无论该公司处于对决的哪一侧。一家公司可以显示 Debt/Equity 恰好为零,并非因为它没有杠杆,而是因为其账面权益本身已变为负数,该比率无从计算。一家公司今年报告的自由现金流利润率,既可能是相对去年申报文件的真实改善,也可能是被规模较小的回购计划所掩盖的真实恶化。这些都无法从单一的横截面得分中看出。只要把四件事并排放在同一配对上,一切便清晰可见:静态因子水平、少量结构性诊断标记、依据上一份 10-K 得出的同一批因子的同比方向,以及公司实际现金在最近三个财年的去向。
本文的贡献在于,把这一由四部分构成的诊断(标记、上期变动、定位图的几何结构与三年资本配置)形式化为一个统一的描述性框架,并将其应用于由十对非金融同业公司构成的、刻意保持多样性的横截面,而不是单一的案例研究。我们并不声称所得诊断能够预测收益,也不声称它构成了公司申报文件可能产生的全部模式的完整分类。我们声称的是:这四个部分合在一起阅读,能给配对比较的读者带来多于各部分之和的东西——使其不仅能问「谁更强」,还能问「这家公司的故事内部是否自洽,并且随时间推移是越来越自洽还是越来越不自洽」。
2. 相关文献
应计质量的文献始于 Sloan(1996),他表明盈余中的应计部分在系统上比现金部分更不持久,且市场对这一区别反应不足。Dechow、Ge 与 Schrand(2010)综述了更广泛的盈余质量文献,以及由这一起点衍生出的诸多代理指标(应计项目、平滑、及时性、持续性);我们的纸面利润标记(经营现金利润率,即 Operating Cash Margin 或 OCM,低于营业利润率 OM 的某一固定比例)与 Sloan Ratio 因子正处于这一传统之中,只是应用于单个同业比较的层面,而非横截面回归。Ohlson(1995)以及 Penman 在 Financial Statement Analysis 中综合的剩余收益框架,为把账面权益及其符号视为本身即具信息量,而非理所当然的分母,提供了依据;我们的非正权益标记是对这一思想直接而刻意粗糙的运用:当杠杆比率的分母变为负数时,该比率就不再是杠杆信号,而是变成另一种信号(关于累计亏损或持续的高回购强度),读者应当看到它被点明,而不是被悄悄抹去。Lev 与 Nissim(2006)用更新的数据和更细分的应计成分重新审视应计异象,并进一步确认应计项目的经济含义在各个子成分之间并不均一;我们把这一审慎态度带入我们自己基于单一比率的应计标记,将其视为粗略的筛查,而不是完整的诊断。
在股东回报方面,Grullon 与 Michaely(2002,2004)记录了美国派息政策中回购对股息的长期替代,以及这对市场应如何解读两者之一的削减或增加所具有的含义;这促使我们把三年资本配置台账当作一个完整的会计恒等式来阅读(自由现金流对应股息、回购、并购、发行与净债务),而不是孤立地看回购或股息。关于融资约束的更广泛文献(有多种形式的综述,例如 Almeida、Campello 与 Weisbach 关于流动性价值的研究)构成了我们这样处理的基础:把一家烧钱公司的现金余额除以其消耗速度,视为现金跑道(runway)信号,而不是估值信号。
最后,我们明确遵循 XBRL 与 SEC 申报文献中关于标签覆盖缺口的指引:并非每家公司都以相同方式标记每个概念,尤其是「mergers and acquisitions」与「operating income」,各申报主体所用的颗粒度明显不同,而缺失的标签说明的是某一申报主体 XBRL 文件中的数据可得性,并不证明相关业务活动没有发生。我们据此处理自己表格中的破折号,并将在局限性部分明确回到这一点。
3. 研究问题与假设
RQ1. 在哪些情形下,OCM 落后于 OM 的程度足以触发纸面利润标记(OCM 低于 OM 的 0.7 倍),并且这种情形是否与(a)现金转化逐年恶化的路径,或(b)建立在疲弱自由现金流基础上的激进回购计划同时出现?
RQ2. Debt/Equity 因账面权益本身非正而无法获得的情形有多常见?这种无法获得,是否与以累计股票回购为主导的资本配置历史相吻合(这正是非正权益标记意在呈现的故事),而不是简单的数据缺失?
RQ3. 行业定位图(x 轴为 Sustainable Growth,即可持续增长;y 轴为 Quality-Adjusted Cash Margin,即质量调整后的现金利润率;点的颜色依据 Debt/Equity)所给出的视觉图景,是否与各对决中「较强」与「较弱」一侧的因子分解和上期变动相一致?
RQ4. 仅基于 10-K 的三年资本配置,是否提供了在单一横截面八因子快照中看不到的信息,例如把由回购式分配推高的高自由现金流利润率与由再投资推高的区分开,或把跑道很长的烧钱公司与接近耗尽的公司区分开?
RQ5(仅作描述). 在相对价格图所显示的窗口内,两家同业公司之间价格比率的方向,是否与它们各因子组之间基本面差距所暗示的方向一致,还是价格与基本面出现背离?纳入这一问题是为了完整,不应被解读为交易信号。
H1. 纸面利润标记更常与 FCF 利润率或 Sloan Ratio 中性乃至为负的上期变动相伴出现,而不是与明显改善的现金转化趋势相伴出现。
H2. 非正权益与资本配置台账中较大的累计回购存在系统性关联,不应仅仅因为某一比率无法计算就被解读为「低杠杆」。
H3. 定位图中高增长、高现金质量象限内的点,更常对应非负的自由现金流与积极的资本回馈,而不仅仅是营收增长。
H4. 对于反向指标(Sloan Ratio、Debt/Equity,其下降即为改善)而言,有利的上期变动是比同一指标孤立的静态水平更有信息量的「走强」信号。
H5. 三年资本配置路径解释了静态 FCF 利润率所无法解释的一部分,即现金实际流向了哪里:偿还债务、回购、并购,还是积累。
4. 制度背景与度量
所有数据均来自 SEC EDGAR 公司事实数据(10-K 申报文件;Relative Price Chart 中「最新」因子值在明确标注之处使用 10-Q),并通过 duelstocks.com 上的比较引擎获取。八个因子以默认权重进入每一个配对得分:营收增长 18%、营业利润率(OM)9%、Operating Cash Margin(OCM)9%、FCF 利润率 9%、ROIC 17%、Asset Turnover 7%、Sloan Ratio 17%、Debt/Equity 14%。营收增长以三年复合年增长率(CAGR)度量;Sloan Ratio 与 Debt/Equity 在评分前均被反转,因此二者的数值越低越强。对每个因子,两家公司的原始值进入一个柔性归一化,t = (a' − b') / (|a'| + |b'| + ε),N_a = 0.5 + 0.5·t,N_b = 0.5 − 0.5·t,这样差距很小时得到近乎平局的结果,差距很大时得到近乎压倒性的结果,而不是采用非此即彼的权重分配。最终得分为 N 值加权和的 100 倍。
在同一因子集合上定义了四个结构性标记,并独立于配对得分进行评估:
- 纸面利润(Paper profits)——OCM < OM × 0.7。会计口径的营业利润率远高于其经营活动实际转化为现金的水平的公司。
- 非正权益(Non-positive equity)——账面权益 ≤ 0,因而 Debt/Equity 无法计算;杠杆信号不是普通比率,须结合资本配置历史来解读。
- 资本开支吞噬(CapEx vacuum)——FCF 利润率 < OCM × 0.3。经营现金的产出在变成自由现金流之前,几乎被资本支出全部吞掉。
- 无安全垫(No safety cushion)——FCF 利润率 < 0 且 Debt/Equity > 1.5。自由现金流为负并叠加已经偏高的杠杆,而不是在资产负债表其余部分健康的情况下自由现金流为负。
上期变动(Δ prior)是某一因子在向 SEC 提交的两份连续的同类型申报文件之间的变化;在本样本中即逐年、由 10-K 到 10-K。利润率与增长的变动以百分点报告;Asset Turnover 与 Debt/Equity 的变动以倍数(×)报告;Sloan Ratio 与 Debt/Equity 的配色约定是反向的,因为二者下降即为改善方向。我们直接根据每家公司最近两份年度申报文件计算这些变动,而不是依据单次横截面提取,并保持与在线比较工具相同的同期类型纪律:10-K 只与上一份 10-K 比较,绝不与中期 10-Q 比较,从而使变动不会被部分年度的基数所污染。
行业定位图在两个轴上展示某一 GICS 行业的每个成分股,这两个轴由与配对得分相同的因子体系构建:横轴为 Sustainable Growth,纵轴为 Quality-Adjusted Cash Margin,点的颜色由 Debt/Equity 决定(杠杆低为绿色,中等为灰色,超过 1.5× 阈值为红色,对于因非正权益而根本无法计算 Debt/Equity 的公司则使用单独的颜色),这使非正权益标记不仅出现在因子表中,也直接显示在图上。
三年资本配置是一份基于相同最近三份 10-K 构建的闭合恒等式台账:自由现金流、已付股息、股票回购、收购、股票发行、净债务变动以及由此产生的现金变动,最终落在所报告的现金余额上。某一行中的破折号表示该项目在该财年没有被标记的活动,而不是被插补的零,我们在全文中始终保持这一区分,而不是把破折号与真正的零归入同一类别。
5. 样本与配对
面板涵盖十对同业公司,共二十家公司,来自八个非金融 GICS 行业;样本范围有意排除金融(其资本结构与「杠杆」的含义因监管构造而不同)与房地产(REIT 特有的分配要求使回购与股息相对于自由现金流的直接解读变得复杂)。配对的选取旨在确保四个结构性标记均被覆盖,并使行业横截面足够宽,避免某一行业的会计惯例主导研究结果。
| 配对 | 行业 | 入选面板的原因 |
|---|---|---|
| MCD vs SBUX | 可选消费 | 双方均带有非正权益标记;RQ2/H2 的锚点案例 |
| KO vs PEP | 日常消费 | KO 带有纸面利润标记并赢得对决;RQ1/H1 的锚点案例 |
| AAPL vs MSFT | 信息技术 | 成熟的自由现金流创造者,回购对再投资 |
| GOOGL vs META | 通信服务 | 新的股息计划,高额回购,供局限性部分讨论的一处并购标签缺口 |
| TSLA vs RIVN | 可选消费 | 已规模化的盈利生产商对早期阶段的烧钱同业 |
| CAT vs DE | 工业 | 资本密集的周期性公司,派息者,杠杆对比 |
| XOM vs CVX | 能源 | CVX 在大宗商品现金周期中带有纸面利润标记 |
| AMZN vs WMT | 可选消费 / 日常消费 | 资本密集度对比;与关于相对指标的配套文章为同一配对 |
| JNJ vs PFE | 医疗保健 | PFE 带有纸面利润标记;规模大且不均衡的并购活动 |
| NEE vs SO | 公用事业 | 二者均带有资本开支吞噬标记;仅 SO 另有无安全垫标记 |
6. 研究发现
6.1 标记诊断:纸面利润与非正权益究竟说明什么
本面板中有三家公司带有纸面利润标记:KO(营业利润率 28.7%,OCM 15.5%,比率 0.54)、CVX(营业利润率 39.8%,OCM 18.0%,比率 0.45)和 PFE(营业利润率 35.6%,OCM 18.7%,比率 0.53)。在配对得分上,三家中的两家,即 KO 与 CVX,明确赢得了对决(对 PEP 为 56–44;对 XOM 为 53–47);只有 PFE 落败(对 JNJ 为 38–62)。这种分布本身就很有启发:纸面利润标记并不等同于输掉比较。它指出的是会计收入与现金收入之间一种特定的结构性缺口,一家公司可以带有这一缺口,同时在其余七个因子上仍是配对比较中较强的一侧。
同比走势使图景进一步清晰,而 H1 在这里只得到部分支持。就 KO 而言,营业利润率同比变动 +7.5 个百分点,而 OCM 仅变动 +1.0 个百分点:会计与现金之间的缺口扩大了,尽管 KO 赢得了对决,其 FCF 利润率在同一期间也改善了 +1.0 个百分点。结合 H1 来看,这正是该假设所预见的边界情形:缺口在扩大,但 FCF 利润率并未恶化;该标记捕捉到的是两种利润率变动方式上的真实背离,而不是现金质量的全面崩塌。就 CVX 而言,OCM 同比改善了 +2.1 个百分点,而 OCM 对 OM 的静态比率(0.45)仍远低于 0.7 的阈值:该标记在最新快照中依然存在,恰恰是因为 CVX 的营业利润率在大宗商品周期的会计一侧足够高,即便现金转化确实有所改善,也未能追上。两个案例都支持把该标记与其自身的变动一并阅读,而不是当作静态的是非判断。
有两家公司带有非正权益标记:MCD 与 SBUX,二者恰好也是本面板中唯一真正的平局,50–50。权益 ≤ 0 意味着双方的 Debt/Equity 均不予计算,而这正是该标记的用意所在,并非偶然的数据缺口。两家公司的三年资本配置台账直接印证了这一机制:MCD 每年通过回购向股东返还 2.06–3.05十亿美元,另有 4.53–5.12十亿美元的股息,而自由现金流为 6.67–7.25十亿美元,这样的分配强度完全符合这样一种权益基础:它是被持续的资本回馈,而不是被经营亏损,推入了负值区间。SBUX 在 FY2024 之前以较小规模呈现了相同的定性模式(回购 0.98–1.27十亿美元),随后在最近一个财年把回购降至零,同时其 FCF 在三年窗口内大致减半,由 3.68十亿美元降至 2.44十亿美元,这是一条实质上不同的路径,却抵达了同一个结构性标记。H2 对两家公司各自而言都得到了很好的支持;配对比较所增加的是:相同的标记与相同的平局得分,可能建立在两种不同的资本配置故事之上,而这正是静态得分单独无法揭示的那种遮蔽。
6.2 上期变动与静态水平
下表列出了整个面板中营收增长、营业利润率、OCM 与 FCF 利润率的年度上期变动(10-K 对 10-K)。数值以百分点计;破折号表示相关数字适用第 4 节所述的同期类型规则,并锚定于网站自身报告的因子水平,而不是在此重新推导。
| Ticker | 期间(最新 → 上期) | Δ 营收增长 | Δ 营业利润率 | Δ Op. Cash Margin | Δ FCF Margin | 解读 |
|---|---|---|---|---|---|---|
| AAPL | 2025→2024 | −0.4 | +0.5 | −3.5 | −4.1 | 增长与利润率水平保持不变,现金利润率却在走弱 |
| MSFT | 2026→2025 | +3.7 | +1.2 | +6.8 | −5.2 | 增长与现金转化双双上升;FCF 受资本开支与 AI 建设拖累 |
| AMZN | 2025→2024 | +1.0 | +0.4 | +1.3 | −4.1 | 利润率改善;FCF 被投资挤压 |
| WMT | 2026→2025 | −0.7 | −0.1 | +0.5 | +0.2 | 同比基本持平 |
| CAT | 2025→2024 | −4.0 | −3.7 | −1.2 | −2.3 | 增长与利润率同步出现周期性回落 |
| DE | 2025→2024 | −4.6 | −3.7 | −1.5 | −1.3 | 与 CAT 同向的周期性走势,幅度较小 |
| GOOGL | 2025→2024 | +1.8 | −0.1 | +5.1 | −2.6 | 营业利润率持平,现金转化上升 |
| META | 2025→2024 | +8.2 | −0.7 | +2.1 | −9.9 | 增长强劲,OCM 持续改善,因再投资 FCF 明显走低 |
| KO | 2025→2024 | −3.1 | +7.5 | +1.0 | +1.0 | 营业利润率跃升;现金转化勉强跟上:纸面利润缺口扩大 |
| PEP | 2025→2024 | −2.1 | −1.8 | −0.7 | n/a | 温和而普遍的走弱 |
| MCD | 2025→2024 | +1.3 | +0.9 | +2.8 | +1.0 | 尽管带有非正权益标记,所列每一项利润率均改善 |
| SBUX | 2025→2024 | −2.7 | −7.1 | −4.1 | −2.6 | 所列每一项利润率均明显恶化 |
| XOM | 2025→2024 | −15.1 | — | −0.1 | −1.7 | 受大宗商品周期影响营收下降;现金利润率几乎不变 |
| CVX | 2025→2024 | −15.4 | — | +2.1 | +1.2 | 营收随周期下滑;现金转化仍有改善 |
| JNJ | 2025→2024 | +3.7 | — | −1.3 | −1.4 | 现金利润率小幅走弱 |
| PFE | 2025→2024 | −7.2 | — | −1.3 | −1.0 | 现金转化仍落后于营业利润率;标记在水平与趋势上均持续存在 |
| NEE | 2025→2024 | −3.8 | ~0 | −8.0 | n/a | 营业利润率其余方面稳定,现金利润率下降 |
| SO | 2025→2024 | −4.6 | −1.8 | −3.5 | −13.0 | 在本已偏高的杠杆结构中 FCF 急剧恶化 |
| TSLA | 2025→2024 | −16.8 | −2.7 | +0.3 | +2.9 | 利润率持平或小幅改善,增长却大幅放缓 |
| RIVN | 2025→2024 | −300.6 | +27.8 | +20.1 | +11.3 | 所有因子均从极低的基数出发而改善;见第 6.4 节 |
有两点约束着对此表的解读。第一,对于 DE、JNJ、XOM 与 CVX,营业利润率的变动留空而非估算:能源与制药行业若干申报主体对营业利润的现有 XBRL 标记,无法在本面板每个申报主体的连续年份中干净地归并为单一可比行,我们给出破折号,而不是给出无法为之辩护的数字,这与第 4 节的数据来源纪律一致。第二,RIVN 巨大的营收增长变动,是上一年分母极小所产生的假象,本身并不是具有经济意义的放缓信号;这正是第 6.4 节通过资本配置得出的现金跑道,而不是仅凭此表来解读 RIVN 的原因。
有三个案例值得直接对照 H4 点明。MCD 在所列每一项利润率上都在改善,尽管它带有其配对中两家公司里看似更严重的标记(非正权益):判断情况在好转还是恶化,更有信息量的信号是变动,而不是静态标记,这恰如 H4 所预测。SBUX 带有同一标记,却在所列每一项利润率上恶化,即使静态得分把两家公司同判为 50–50,标记文字也一字不差,仅凭变动就能正确地把这两家公司区分开来。SO 把强烈为负的 FCF 利润率变动(−13.0 个百分点)与本已偏高的 Debt/Equity(1.72×,高于无安全垫的 1.5× 阈值)结合在一起:变动显示,缓冲不仅偏薄,而且还在继续变薄。
6.3 定位图与因子分解
行业图直接以视觉方式编码了面板的两个结构性维度:横向位置对应可持续增长,纵向位置对应质量调整后的现金利润率,点的颜色对应 Debt/Equity 档位。图与因子表之间有三处吻合值得报告,因为它们合起来关系到 RQ3。
第一,图的颜色编码独立地标出了非正权益。在可选消费图上,MCD 与 SBUX 都显示为黄色点,这是专为无法计算 Debt/Equity 的公司保留的颜色,而不是同一张图上其他所有公司所用的由绿到红光谱中的任何一种色调。一位只看图、无法查阅标记文字的读者,已经能看出这两家公司处在正常的杠杆色阶之外。在公用事业图上,SO 显示为红色(Debt/Equity 1.72×,高于 1.5× 阈值),而 NEE 为 1.47×,显示在相邻的灰色区间而不是红色,这准确反映出 NEE 恰好位于把 SO 标记为无安全垫的同一阈值之下。
第二,图上的纵向分离紧密对应各配对内部经营现金利润率的差距。在通信服务图上,META 明显高于 GOOGL,与 META 的 OCM 57.6% 对 GOOGL 的 40.9% 相符。在日常消费图上,KO 与 PEP 彼此靠近,位于该行业横向中线附近,与二者较窄的 OCM 差距(15.5% 对 12.9%)相符,相比之下 META 与 GOOGL 之间的距离更大。在能源图上,XOM 与 CVX 显示为接近重叠的绿色点,位于行业点云中心附近:二者的 Debt/Equity 都较低(0.18× 与 0.21×),现金利润率也相近(15.6% 对 18.0%),这是视觉上的近似平局,对应本面板得分分布中较窄的一侧(CVX 以 53–47 获胜,是仅次于 MCD-SBUX 的面板内第二小差距)。
第三,图把 RIVN 隔离为一个清晰可见的离群点,而不是把它融入可选消费的主体点云。RIVN 出现在行业图的右下方很远处:横向(增长)位置很高,这是第 6.2 节所述低基数效应所致;现金质量则远低于横向中线,与 −14.5% 的 OCM 相符。该图上可见的其他成分股,没有一个接近这种极端增长与深度为负的现金质量的组合,这在读者打开那张表之前,就已从视觉上预示了第 6.4 节的资本配置解读。
就 H3 而言,来自定位图的证据好坏参半,并非一律证实。这些图上高增长、高现金质量象限,主要由十对焦点配对之外的较小成分股占据(信息技术图上的 SNDK 与 PLTR、可选消费图上的 DASH 与 CCL 等名称),而本面板的各配对更常位于各自行业点云中心附近。这本身就是一项发现:在本面板中,要成为两家公司对决中较强的一侧,并不需要占据一张含三十至八十个成分股的行业图的极端象限:MSFT、META 与 CVX 都是在位于各自行业点云的中上部或中心、而不是最外侧的情况下赢得对决的。
6.4 三年资本配置
本面板中的三个故事直接支持 H5:资本配置台账回答了单一期间 FCF 利润率留下的问题。
仅凭 RIVN 的静态因子表,传达的是一家烧钱的公司(FCF 利润率 −46.2%),ROIC 为负,Sloan Ratio 为负。资本配置台账补上了真正决定这是急性问题还是慢性问题的信息:现金余额为 3.58十亿美元,而最近一年的 FCF 消耗按当前速度意味着约 1.4 年的现金跑道,其资金部分来自股票发行(最近一年 0.75十亿美元,较两年前的 0.06十亿美元大幅上升),而不是债务。这与单纯的「自由现金流为负」在实质上是不同的解读:它是一家处于扩张期的早期生产商,通过稀释为一笔不断扩大但仍有资金支撑的消耗提供融资,而不是一家面临可用现金即将耗尽的公司。
SO 的静态因子显示出资本开支吞噬标记,且最近一年 FCF 利润率为负。三年台账表明这并非一次性现象:在所列三年中,FCF 从 −1.54十亿美元变为 +0.83十亿美元,又回到 −2.94十亿美元,而股息在窗口内的每一年都大致持平,维持在约 3十亿美元,无论当年自由现金流为正还是为负,净债务在最近两年均有所上升。结合 Debt/Equity 比率已高于本面板无安全垫的 1.5× 阈值,这份台账显示出一家公司:在最近三个财年中有两年自由现金流为负的基础上,靠发行债务维持其分配承诺,这正是无安全垫标记设计用来呈现的构型,也正是单一期间 FCF 利润率快照无法与由投资时点造成的暂时性下滑区分开来的那类模式。
AMZN 的三年台账讲述了第三种故事。自由现金流在所列前两年保持在 32–33十亿美元的狭窄区间,随后在最近一年骤降至 7.7十亿美元,三年均无股息和回购,最近一年则由偿还债务转为净发行债务 11.14十亿美元。仅对照静态因子表来看(AMZN 的 FCF 利润率 21.5% 与经营现金利润率 22.5% 都明显领先于 WMT),台账补充了这样的背景:AMZN 自身的现金创造同比出现了显著收缩,尽管它在每一个现金转化因子上仍领先于 WMT;而 AMZN 是用债务为这一收缩融资,而不是削减股东回报,而它本来就没有这类回报。相比之下,WMT 的台账显示,在同样三年里,回购从 2.78十亿美元增至 8.09十亿美元,同时自由现金流稳步增长:这是一次常规的、以现金融资的股东回报提速,而在静态因子表中(WMT 在每一项利润率因子上都落后于 AMZN),这是无法自行显现的。
6.5 价格比率与基本面差距(仅作描述)
对于唯一一对同时获取了相对价格图与完整诊断集的配对(MCD 对 SBUX),MCD/SBUX 价格比率由 6 月的约 2.95 降至 10 月初的约 2.45,其 50 日均线为 2.53:在所示窗口内,这是一种 SBUX 跑赢 MCD 的市场价格趋势。同一图表中的基本面差距面板,采用第 4 节所述相同的柔性 t 归一化构建,并按第 1 节所述的五组分类归并,显示 Margin Conversion(OCM)偏向 MCD(t = +0.51),而 Capital Efficiency(ROIC,t = −0.43)与 Accrual Quality(Sloan Ratio,t = −0.35)都偏向 SBUX,Growth 接近持平(t = +0.02),Financial Strength(Debt/Equity)则因双方共有的非正权益标记而对两侧均被阻断。四个可用组别的中位数 t = −0.16,略微偏向 SBUX,与同一图表所示的价格趋势方向一致。
我们把这一个案视为描述而非证明:一对公司、一个窗口、一个基本面与价格方向一致而非背离的案例。第 6.2 节的变动表显示,同一配对的上期走势,更明显地指向对 SBUX 不利的方向(Δ 营业利润率 −7.1 个百分点,Δ FCF 利润率 −2.6 个百分点),而不是对 MCD 有利的方向,这至少与以下解释相容:市场价格的变动,跟随的是在该窗口开始之前就已在上期变动中显现的基本面恶化——尽管这远不足以证明。我们不把这一描述性观察推广到另外九对公司,因为它们没有获取价格比率图,我们也不把它解读为价格与基本面更普遍地同向变动的证据。
7. 讨论
合起来阅读,第 6.1 至 6.5 节从四个不同方向指向同一个解释原则:标记点明结构性模式,变动点明方向,图上的位置点明在更广泛同业群体中的相对位置,资本配置台账点明现金究竟流向了哪里;而这四者中没有一个可以取代其他任何一个。KO 的纸面利润标记持续存在,相对上期甚至有所扩大,但 KO 仍然从容赢得对决,因为该标记关乎两个特定利润率之间的关系,而不是八个因子的综合结果。MCD 与 SBUX 带有相同的标记,得分平局也相同,却在每一项所列变动上朝相反方向移动,并为截然不同的三年分配路径提供资金。RIVN 的单期因子表单独阅读时一律令人警惕;其资本配置台账读来则像一家有资金支撑的跑道、正在扩张的公司,而不是迫在眉睫的危机。在每一种情形下,更丰富的诊断都不与更简单的诊断相矛盾——它增加了更简单的诊断本就不是为承载而设的一个维度。
对于在实践中使用配对比较工具的投资者或分析师而言,操作上的含义是一个阅读顺序,而不是单一的数字:先看得分与标记,了解每家公司孤立来看的会计结构;再看上期变动,判断这种结构在改善还是在恶化;用定位图把两家公司放在其更广泛的行业之中,而不只是彼此对照;最后用三年资本配置台账,查看利润率所暗示的现金是否真的到账,以及流向了哪里。这些步骤都不要求放弃本站一篇配套文章已就其自身依据所辩护的单一配对得分;每一步只是回答一个单一得分从其构造上就无法回答的问题。
8. 局限性
- XBRL 标签覆盖在各申报主体之间并不一致。本面板中若干能源与制药公司并未把营业利润标记在逐年直接可比的单一行中,这正是第 6.2 节对 JNJ、PFE、XOM 与 CVX 给出破折号而非估算的营业利润率变动的原因;破折号反映的是申报结构的差异,而不是相关业务活动的缺失。DE 的营业利润率变动(第 6.2 节)以数字而非破折号报告,因为其 10-K 标记在所比较的两个年份中都得到了干净的解析。
- 资本配置表中的破折号表示该项目在该财年没有被标记的活动,而不是被插补的零;二者在本文中始终分开处理,我们提醒不要在其他场合把它们互换阅读。
- 面板由十对、二十家公司构成,选取目的是覆盖全部四个结构性标记和一个八行业的横截面:这是一种结构化的、按标记平衡的案例系列设计,而不是对整个非金融范围的随机或统计上具有代表性的样本,本文中的描述性频率应据此阅读,而不应视为总体估计。
- RIVN 的营收增长上期变动(第 6.2 节)是异常偏小的上期基数所造成的假象,不应被解读为独立的增长信号;出于这一原因,我们有意通过第 6.4 节的资本配置台账,而不是通过变动表来引导对 RIVN 的解读。
- 三年资本配置窗口在设计上固定于最近三份 10-K,不再向前延伸;更长的窗口会对某些公司(特别是 NEE 资本密集的可再生能源扩张)显示出比本窗口单独所能显示的更完整的分配周期。
- 金融与房地产在设计上被排除在外(第 5 节);若不对其不同的杠杆与分配惯例另行处理,本文的任何内容都不应被解读为可延伸至这两个行业中的任何一个。
- 第 6.5 节明确是描述性的,仅限于一对公司和一个观察窗口;它不是择时主张,也未推广到本面板其余九对公司。
- 本文中的任何诊断(标记、变动、图上位置或资本配置)都没有针对后续股票收益进行校准,也未被证明能够预测后者。本文描述的是一家公司自身报告数字相对于其同业、相对于其自身上一份申报文件的内部一致性;它并不检验这种一致性或其缺失是否已反映在价格之中。
9. 结论
配对得分回答谁更强。它本身并不回答这种强势在结构上是否干净、是否在改善、相对更广泛的同业群体处于什么位置,或其背后的现金究竟流向了哪里。本文在十对跨行业非金融同业公司上结合了四种诊断(结构性标记、由连续 10-K 直接计算的年度上期变动、由同一因子体系构建的行业定位图,以及三年资本配置台账),并发现每一种诊断确实都补充了其他诊断所不具备的信息。纸面利润标记可以在对决的获胜一侧持续存在,甚至扩大(KO),而不是指向失败者。相同的非正权益标记与相同的平局得分,可以建立在两条相反的同比路径(MCD 在改善,SBUX 在恶化)与两条不同的资本配置路径之上。对于一家三年资本配置台账显示出有资金支撑且可持续融资的跑道、而非迫在眉睫的危机的公司(RIVN),单期因子表可能一律显得令人警惕。以上这些都不能取代读者在比较两家公司时最终想要的单一相对得分:它们是告诉读者该得分及其背后趋势应占多大权重的背景。
参考文献
Sloan, R. G. (1996). Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings? The Accounting Review, 71(3), 289–315.
Dechow, P., Ge, W., & Schrand, C. (2010). Understanding Earnings Quality: A Review of the Proxies, Their Determinants and Their Consequences. Journal of Accounting and Economics, 50(2–3), 344–401.
Ohlson, J. A. (1995). Earnings, Book Values, and Dividends in Equity Valuation. Contemporary Accounting Research, 11(2), 661–687.
Penman, S. H. (2013). Financial Statement Analysis and Security Valuation (5th ed.). McGraw-Hill.
Lev, B., & Nissim, D. (2006). The Persistence of the Accrual Anomaly. Contemporary Accounting Research, 23(1), 193–226.
Richardson, S. A., Sloan, R. G., Soliman, M. T., & Tuna, I. (2005). Accrual Reliability, Earnings Persistence and Stock Prices. Journal of Accounting and Economics, 39(3), 437–485.
Grullon, G., & Michaely, R. (2002). Dividends, Share Repurchases, and the Substitution Hypothesis. The Journal of Finance, 57(4), 1649–1684.
Grullon, G., & Michaely, R. (2004). The Information Content of Share Repurchase Programs. The Journal of Finance, 59(2), 651–680.
Almeida, H., Campello, M., & Weisbach, M. S. (2004). The Cash Flow Sensitivity of Cash. The Journal of Finance, 59(4), 1777–1804.
DUEL 方法论:duelstocks.com/methodology
DuelStocks,「From Winner-Take-All to Soft Relative Scores」与「How Many Independent Signals? A Principal Component Analysis of an 8-Factor Stock Model」(本站配套方法论笔记)。
附录 A:三年资本配置,完整面板(十亿美元)
| Ticker | 财年 | FCF(FY−2 / FY−1 / 最新) | 股息 | 回购 | 并购 | 股票发行 | Δ 净债务(FY−1 / 最新) | 现金余额(FY−2 / FY−1 / 最新) |
|---|---|---|---|---|---|---|---|---|
| MCD | 2023/24/25 | 7.25 / 6.67 / 7.19 | −4.53 / −4.87 / −5.12 | −3.05 / −2.82 / −2.06 | — / — / — | — / — / — | −0.48 / +1.48 | 4.58 / 1.08 / 0.77 |
| SBUX | 2023/24/25 | 3.68 / 3.32 / 2.44 | −2.43 / −2.58 / −2.77 | −0.98 / −1.27 / 0 | 0 / 0 / −0.18 | 0.17 / 0.11 / 0.08 | +0.17 / +2.01 | 3.55 / 3.29 / 3.22 |
| KO | 2023/24/25 | 9.75 / 4.74 / 5.30 | −7.95 / −8.36 / −8.78 | −2.29 / −1.79 / −0.75 | — / — / — | 0.54 / 0.75 / 0.31 | +4.05 / +0.10 | 9.37 / 10.83 / 10.27 |
| PEP | 2023/24/25 | 7.92 / 7.19 / 7.67 | −6.68 / −7.23 / −7.64 | −1.00 / −1.00 / −1.00 | −0.31 / −0.26 / −3.39 | — / — / — | −0.29 / +5.12 | 9.71 / 8.51 / 9.16 |
| AAPL | 2023/24/25 | 99.58 / 108.81 / 98.77 | −15.03 / −15.23 / −15.42 | −77.55 / −94.95 / −90.71 | — / — / — | — / — / — | −7.35 / −4.55 | 29.96 / 29.94 / 35.93 |
| MSFT | 2024/25/26 | 74.07 / 71.61 / 66.99 | −6.17 / −6.76 / −26.45 | −17.25 / −18.42 / −22.27 | — / — / — | 2.00 / 2.06 / 2.01 | −1.04 / +3.37 | 18.32 / 30.24 / 20.93 |
| GOOGL | 2023/24/25 | 69.50 / 72.76 / 73.27 | 0 / −7.36 / −10.05 | −61.50 / −62.22 / −45.71 | — / — / — | — / — / — | −2.86 / +38.08 | 24.05 / 23.47 / 30.71 |
| META | 2023/24/25 | 43.85 / 54.07 / 46.11 | 0 / −1.27 / −1.33 | −19.77 / −30.12 / −26.25 | — / — / — | — / — / — | +10.44 / +29.92 | 41.86 / 43.89 / 35.87 |
| TSLA | 2023/24/25 | 4.36 / 3.58 / 6.22 | — / — / — | — / — / — | −0.06 / 0 / 0 | — / — / — | +2.85 / +1.05 | 16.40 / 16.14 / 16.51 |
| RIVN | 2023/24/25 | −5.89 / −2.86 / −2.49 | — / — / — | — / — / — | — / — / — | 0.06 / 0.06 / 0.75 | +0.01 / 0.00 | 7.86 / 5.29 / 3.58 |
| CAT | 2023/24/25 | 11.29 / 10.05 / 8.92 | −2.56 / −2.65 / −2.75 | −4.97 / −7.70 / −5.19 | −0.07 / −0.03 / −0.05 | 0.01 / 0.02 / 0.02 | +2.63 / +4.47 | 6.98 / 6.89 / 9.98 |
| DE | 2023/24/25 | 7.09 / 7.59 / 6.10 | −1.43 / −1.60 / −1.72 | −7.22 / −4.01 / −1.14 | −0.08 / — / −0.10 | — / — / — | n/a / n/a | 7.46 / 7.32 / 8.28 |
| XOM | 2023/24/25 | 33.45 / 30.72 / 23.61 | −14.94 / −16.70 / −17.23 | −17.75 / −19.63 / −20.27 | — / — / — | — / — / — | +0.15 / −1.21 | 31.54 / 23.03 / 10.68 |
| CVX | 2023/24/25 | 19.78 / 15.04 / 16.59 | −11.34 / −11.80 / −12.75 | −14.94 / −15.23 / −12.08 | −0.06 / 0 / −1.06 | — / — / — | +3.71 / +16.22 | 8.18 / 8.26 / 7.29 |
| AMZN | 2023/24/25 | 32.22 / 32.88 / 7.70 | — / — / — | 0 / 0 / — | — / — / — | — / — / — | −9.18 / +11.14 | 73.39 / 78.78 / 86.81 |
| WMT | 2024/25/26 | 15.12 / 12.66 / 14.92 | −6.14 / −6.69 / −7.51 | −2.78 / −4.49 / −8.09 | −0.01 / −1.90 / −0.05 | 0.72 / 0.36 / 0.11 | −1.39 / +5.70 | 9.87 / 9.04 / 10.73 |
| JNJ | 2023/24/25 | 18.25 / 19.84 / 19.70 | −11.77 / −11.82 / −12.38 | −5.05 / −2.43 / −5.95 | 0 / −15.15 / −17.54 | — / — / — | +7.58 / +11.55 | 21.86 / 24.11 / 19.71 |
| PFE | 2023/24/25 | 4.79 / 9.84 / 9.07 | −9.25 / −9.51 / −9.77 | 0 / 0 / — | −43.43 / 0 / −6.93 | — / — / — | −2.64 / +3.49 | 2.85 / 1.04 / 1.14 |
| NEE | 2023/24/25 | 11.30 / 13.26 / 12.48 | −3.78 / −4.24 / −4.68 | — / — / — | — / — / — | 4.51 / 0.05 / 2.04 | +12.14 / +12.61 | 2.69 / 1.49 / 2.81 |
| SO | 2023/24/25 | −1.54 / 0.83 / −2.94 | −3.04 / −2.95 / −3.02 | — / — / — | 0 / 0 / −0.64 | 0.04 / 0.14 / 1.62 | +0.58 / +6.26 | 0.75 / 1.07 / 1.64 |
附录 B:标记定义(工具原文的翻译)
- 纸面利润(Paper profits): Op. Cash Margin < Operating Margin × 0.7
- 非正权益(Non-positive equity): 账面权益 ≤ 0——不计算 Debt/Equity(通常是大额回购或累计亏损);杠杆信号并非普通比率
- 资本开支吞噬(CapEx vacuum): FCF Margin < Op. Cash Margin × 0.3
- 无安全垫(No safety cushion): FCF Margin < 0 且 Debt/Equity > 1.5
基于 SEC 公开申报文件的描述性同业诊断。不构成投资建议。所有数字均来自经由 duelstocks.com 获取的 SEC EDGAR 公司事实数据;在依赖任何单个数字之前,请在在线工具和原始文件中核实最新数值。
一篇关于测量方法的文章,不是个股推荐。不构成投资建议。
两份年报并排放着。甲公司:ROIC 22%,营业利润率 30%。乙公司:ROIC 15%,营业利润率 25%。从纸面上看,甲公司显然是赢家——筛选器会把它排得更高,表格排序会把它放在最上面,大多数投资者也会到此为止。
但资本轻的软件业务里的 22% ROIC,和资产结构、营运资金周期、竞争格局都不同的工业企业里的 15% ROIC,即便是同样的两个数字,也不是同一个经济对象。一个决策真正需要的数字——我应该持有甲而不是乙吗——并不单独存在于任何一页上。它存在于两者之间的差值里,前提是先剔除两家公司共同承担的噪声。工程师早在很久以前,在一个与金融毫无关系的领域,就解决了这个问题。
一台三万美元的接收机教会了测绘员什么是噪声
无论是手机级还是专业级,单一 GPS 接收机通过为来自数万公里外卫星的信号计时来报告位置。即使天空晴朗,这个位置的典型精度也只有 3 到 10 米左右。大气层会以不可预测的方式弯曲信号,卫星时钟的漂移换算成距离就是数米,轨道位置也从未被完全精确地知道。这些误差没有一项是你接收机独有的随机噪声——它是同一大致区域内任何接收机在同一时刻都会经历的共同偏差。
测绘员不会直接对抗这种偏差,而是把它抵消掉。第二台接收机——位于已知位置的固定基站——在同一时刻测量同样的共同大气和轨道误差。用基站的读数减去流动站的读数,误差中共同的那部分几乎完全从差值中消失。剩下的主要是两台接收机之间的短基线,而不是通往卫星那条漫长、嘈杂的路径。这种技术被称为实时动态定位(RTK),常规情况下能把精度从数米提升到约一厘米(Hofmann-Wellenhof, Lichtenegger & Wasle, 2008)。卫星本身没有任何变化。变化的是测量方式——从绝对位置变成了相对位置。
| 模式 | 测量的是什么 | 典型精度 | 金融对应 |
|---|---|---|---|
| 绝对 GNSS(单一接收机) | 全球参考系中的位置 | 3 到 10 米 | 单独一个比率:ROIC、利润率、增长率,孤立地读取 |
| 相对(RTK:基站加流动站) | 两个已知站点之间的向量 | 约 1 厘米 | 两家公司之间逐因子的对比 |
这个类比是一种结构,不是一个证明。市场不是卫星星座,公司申报文件也不是连续信号,而选错的一对——两家毫无共同点的企业——就像两台接收机之间没有共享天空视野的相对定位。这里的要点比这个比喻本身更窄、也更有用:只要两次测量共享同一个误差来源,把它们互相比较,就能比任何一次测量单独消除更多的这种误差。这不是一个金融观点,而是与把 10 米精度的 GPS 变成 1 厘米精度的 RTK 完全相同的算术事实。
一个绝对数字究竟有什么用
绝对指标并没有错。它们回答的是一个真实的问题:这个数字,对这家公司而言,现在有多大。这正是以下几类任务真正需要的:
- 把一个庞大的股票池筛选成一份候选名单("ROIC 高于资本成本")。
- 追踪一家公司自身随时间的轨迹。
- 为单一标的的现金流折现模型或信用模型提供输入,这时需要的是一个水平值,而不是一个排名。
- 以绝对数值定义的监管、契约或合规门槛。
绝对数字走到尽头的地方,恰恰是候选名单确定之后真正占据投资者注意力的那个问题:在我愿意持有的两只股票中,哪一只更强,强多少?一列排序好的数据回答不了这个问题。它还会在三个具体的、共性的方面失灵:
行业性整体虚高。 如果某个行业的每家公司都因为共同的定价周期而利润率扩张了 300 个基点,一张绝对指标的仪表盘就会全线变绿。这些公司彼此之间并没有变得更好——整个参考系都发生了偏移,就像一整个卫星星座一起漂移一样。
规模与结构陷阱。 极高的 ROIC 可能反映一家真正高效的企业,也可能反映多年回购后萎缩的股权基础,或者一种资产负债表上本就承载更少资产的资本轻模式。单看这个数字,无法分辨究竟是哪一种情况。
多因子冲突。 现实中的一对企业很少在所有方面都一致。一家在增长和现金转化上胜出,另一家在资本周转和资产负债表纪律上胜出。绝对筛选器无法化解这种冲突——它只会给你两个各自独立的绿色对勾,把权衡留给使用者自己。
算术内核
把公司 i 观测到的任何基本面指标看作三部分之和:
x_i = q_i + s + e_i
q_i 是公司在该维度上真实的、独有的质地。s 是被比较的两家公司共同承受的一个冲击——一个行业性的利润率周期、一种利率环境、一种全行业的会计风尚、整个同业群体一时的估值倍数扩张。e_i 是仅属于那一家公司申报数据的特异性噪声。
绝对筛选只看 x_A 本身,于是 s 就未经检视地夹带在这个数字里。两两比较看的则是差值:
x_A 减 x_B = (q_A 减 q_B) + (e_A 减 e_B)
共同项 s 消失了。不是被估计,也不是被调整——而是通过和把两次带噪声的 GPS 定位变成一个精确向量完全相同的减法,直接消失。这一行公式,就是贯穿全文的核心论据。其余部分都是应用和诚实的但书。
要让这种比较真正可用,差值需要能代入公式,而不只是一个正负号。对某个因子上的两个原始值 a 和 b(对于"越低越好"的指标,例如盈余质量比率,先把符号反转)定义:
t = (a' 减 b') / (|a'| + |b'| + epsilon),epsilon 为一个很小的正常数
N_A = 0.5 + 0.5 乘以 t N_B = 0.5 减 0.5 乘以 t
如果 a 等于 b,双方都恰好落在 0.5——真正的平局。差距小,产生的倾斜就轻微;差距大,产生的倾斜就强烈。幅度被保留下来,而不是坍缩成非胜即负的二元结果。一个加权的多因子得分,于是就是各因子之和,Score = 100 乘以(权重_k 乘以 N_k)之和,并使权重之和归一化为 1。这不是一个估值模型,也不给任何东西定价。它是建立在已披露基本面之上的归一化竞赛——是基站与流动站向量的金融对应物,而不是任何一家公司单独的卫星照片。
一个真实案例:亚马逊对沃尔玛
零售与电商足够频繁地被归入同一个心理抽屉,以至于先看哪一列,就可能让人对任何一家公司产生片面的绝对印象。下面这张八因子面板并非用于说明的填充数据——它是本站其他对决和脆弱性分析中使用的同一批真实的、基于 SEC 的数据,截至同一个申报快照时点。
| 因子 | AMZN | WMT | 绝对优势方 |
|---|---|---|---|
| 营收增长(3 年 CAGR) | 11.73% | 5.27% | AMZN |
| 经营现金利润率 | 22.51% | 5.83% | AMZN |
| ROIC | 9.89% | 16.74% | WMT |
| 斯隆比率(越低越好) | 17.40% | -5.31% | WMT |
| 资产周转率 | 0.65x | 2.43x | WMT |
| 应收账款周转率 | 8.14x | 64.39x | WMT |
| 营业利润率 | 11.16% | 4.18% | AMZN |
| 自由现金流利润率 | 21.48% | 2.09% | AMZN |
用上面的软性归一化方法、按默认权重计算,汇总结果是 51.2 比 48.8,亚马逊小胜——是近乎平局,而不是朝任何一个方向的压倒性胜利。
在看那一个汇总数字之前,先读懂表格两半各自真正在说什么。资本效率这一组——ROIC、资产周转率、应收账款周转率——清楚地、且以较大差距把沃尔玛推向优势方;沃尔玛 64.4 倍的应收账款周转率对上亚马逊的 8.1 倍,是整个面板中最大的原始差距,这是关于一家连锁零售网络如何周转其营运资金的真实信息。现金转化与增长这一组——经营现金利润率、营业利润率、自由现金流利润率、营收增长——同样清楚地把亚马逊推向优势方。两组数据都是真实的,两列绝对数字都没有说谎。若只按任何一半单独做赢家通吃式解读,得出的都会是整体格局在任何方向上都不支持的一边倒结论;而汇总结果中的近乎平局,恰恰正确地拒绝假装一方的真实优势能够抵消另一方的真实劣势、从而制造出一种虚假的共识。斯隆比率在这里加上了第二重独立的警示:亚马逊更偏向应计项驱动的盈利结构,是有理由在表面上对其现金转化优势稍微少打一点分的正当理由,而不是可以忽略它的理由。
为什么投资者以为自己用了二十个指标——其实只用了两个
在绝对与相对这个问题之下,还有一种更隐蔽的第二类失灵,它解释了为什么给筛选器多加几列并不会像感觉上那样解决问题。
想象一个精心构建的专业级评分平台,拥有上百个指标,分布在盈利能力、财务实力、成长性、估值、动量这五六个命名类别下。这看起来像是关于一家公司的五六种独立意见,但通常并不是。在同一个盈利能力板块内,营业利润率、净利润率、ROE、ROA 和 ROIC 往往会对同一家公司、在同一时期、在大多数同业中一起变动,因为它们只是对同一个底层现金生成引擎的不同算术视角——这是几十年来财务比率因子分析文献中反复记录的一种模式(Pinches, Mingo & Caruthers, 1973;Chen & Shimerda, 1981)。四个价格倍数——市盈率、市销率、EV/自由现金流、EV/EBITDA——是围绕同一个分子(当前市场价格)的四种不同变体形式的分母。看到这四者"一致",并不是四个独立的确认,而是同一个意见被数了四遍——就像询问三位受训于同一本教材、正在看同一张 X 光片的医生一样。
本站自己的八因子面板也没有豁免于这种审视,而且是经过实际检验、而非想当然假设的:对这同一批八个 SEC 来源指标所做的主成分分析(见《有多少个独立信号?一个 8 因子股票模型的主成分分析》)发现,它们会收敛为四个经验上可区分的成分——现金转化、资本效率、成长、应计质量——其中一个干净、近乎单独存在的信号(斯隆比率)之所以是个例外,正是因为它衡量了其他七个指标都没有衡量的东西:盈利究竟是由现金支撑,还是由会计选择制造出来的。一个拥有几十个比率的更重的评分板,按同样的逻辑,很可能会压缩为规模相近的一小撮潜在因子,再加上至少一层纯 SEC 基本面面板完全触及不到的额外维度——当前市场价格及其动量,它从一开始就不是从会计数据推导而来,因此在数学上独立于任何会计比率。至于某个具体平台的完整指标集究竟会收敛为四个、五个还是六个因子,是关于该平台自身相关矩阵的一个经验问题,本文无法从外部替它下定论——更诚实、也更有分量的说法是:一个界面展示出的类别数量是一种分类法,而不是因子分析的结果,二者常常并不是同一个数字。
这个差距带来的人力成本才是真正的故事。面对二十项甚至上百项同时呈现的读数,几乎没有任何投资者——包括非常能干的投资者——能在做决策的那一刻,把完整的矩阵记在工作记忆里。真正可靠发生的,是一次悄无声息的替代:宽泛的信息面板被匆匆扫一眼,其中大部分在没有人有意识地决定舍弃的情况下就被舍弃了,真正的决策落在一两个熟悉的维度上——通常是增长率,或者股价跌了多少——与此同时,投资者却记得自己"做过全面分析"。进去的是二十项读数,出来的是基于其中两项做出的决定。另外十八项只带来了一种尽职调查的感觉,而不是额外的信息。
一种两两比较、因子已压缩的方法,并不是靠增加更多数据来解决这个问题。它的解决方式,是不让相关联的列冒充独立的投票,并让真正独立的那一小撮信号之间的分歧变得无法被悄悄划过而不被察觉。在上面亚马逊对沃尔玛的面板里,冲突并没有埋在表格第四十行——它就是整张表的结构本身:资本效率说一套,现金转化和增长说另一套,而汇总结果中的近乎平局,正是这种分歧的诚实算术结果,而不是把它掩盖起来的一个平均数。这是相对于更大评分板的第二个、独立的优势,与上面共同噪声那个论点并列且互补:噪声抵消让比较变得诚实;因子压缩则让它小到一个人在做决定时真的能装在脑子里。
这究竟能给投资者带来什么
以上这些都不要求抛弃绝对数字,只是要求在真正需要回答"甲对乙"这个问题时,不要止步于绝对数字。具体来说,一种相对的、因子已压缩的比较能带来:
- 一个与决策相匹配的决策变量。 两个候选对象在已声明因子上的相对排名,而不是一个脱离了桌面上真实备选方案的全局分数。
- 对共同冲击的部分免疫力。 行业性的利润率扩张、共同的利率变动、全行业性的会计风尚——所有这些,都会在抵消 RTK 中大气延迟的那同一个差值运算中被抵消掉。
- 明确而非隐藏的取舍。 当增长和现金转化与资本周转及杠杆意见相左时,比较会展示这种分歧,而不是把它平均成一个具有误导性的、看似平滑的单一数字。
- 一小组站得住脚的维度,而不是上百个相互关联的维度。 四个独立信号,而不是同样这四个信号的四十种重复表述。
- 可审计性。 每一项输入都能追溯到一份具体的 SEC 申报文件和一条已公开的归一化规则,而不是一种不透明的专有混合方法。
DUEL 处于什么位置
DUEL(duelstocks.com)是上述全部内容的一种可操作实现,而不是这个论点本身。它用八个基于 SEC 的因子构建相对这一层,对一对中的两个名字应用完全相同的软性归一化,把权重公开出来而不是藏在黑箱之后,并允许用户在不必手动重新计算任何东西的情况下,向成长、质量、价值或收益方向重新调整权重。同一个网站上的行业定位地图把这套因子压缩的逻辑又向前推进了一步,把整个同业群体绘制在由同一个四成分结构构建出的两条轴上,而不是原始的、相关联的比率上。这一切都不是在宣称某一个工具就穷尽了本文所描述的方法——真正起作用的,是这套识别逻辑:共同噪声抵消,加上因子压缩,再加上明确的两两对比。任何建立在这三条相同原则之上的其他工具,都值得同样的论证。
反对意见
"我做现金流折现模型需要绝对的 ROIC。" 没错——一个水平值适合输入单一标的的估值模型或信用判断。相对比较适合在候选对象之间进行筛选和排序。这是同一个流程中不同步骤所需的不同工具,而不是相互竞争的关系。
"如果一切都是相对的,就没有了锚点。" 锚点就是那个明确的同业对象,或者资本明确的替代用途。RTK 定位依然建立在一个真实的大地测量控制网之上——相对测量提高的是两点之间的精度,并不否认每个点本身都有一个位置。
"我直接按 ROIC 给表格排序就行了。" 给一列数据排序,只是单因子的绝对排名。它无法抵消共同冲击,无法对多个因子加权,也无法告诉你旁边那些列究竟是独立的确认,还是同一个信号被数了四遍。
"比较两家公司是任意的——为什么偏偏是这两家?" 为任何绝对筛选定义一个股票池,同样也是任意的。真正的规范做法,是选择一对或一组经济上确实可比的同业,并公开说明权重,而不是假装一个全局的绝对量表是中立的,尽管它同样携带着大量隐含的选择。
局限性
- 相对得分不是预期收益率的预测。本文中没有任何地方声称,两两比较中较强的一方未来表现一定会更好。
- 选择不当的一对——两家没有真实经济重叠的企业——会产生一个建立在噪声之上、看起来很精确的数字,这是没有共享卫星视野的 RTK 定位在金融上的对应物。
- 会计上的恒等关系不等于经济上的实质。斯隆比率和现金利润率类因子能够降低、但无法消除盈余质量风险。
- 相对比较不能替代仓位规模、流动性评估、支付价格或定性尽职调查。
- 任何因子压缩方面的结论,包括上文引用的四成分结果,都只针对测量所用的那一套指标和那一段时期而言。要把同样的逻辑套用到另一个平台自己的比率上,需要在那个平台自己的数据上重新跑一遍同样的检验,而不能假设同一个数字可以直接照搬。
- 默认权重代表的是一种合理的专家先验,而不是经过回测的最优解;本站 DUEL 自己的后续文章明确指出,哪一套权重最能预测未来收益率这一校准问题仍然是开放的。
结论
一个绝对比率衡量的是共同的、带噪声的参考系内部的一个水平值。一个相对的两两比较衡量的则是一种对比,其中这种噪声中共同的那部分因构造本身而被抵消——这与把一个飘忽不定、精度只有 10 米的 GPS 定位变成一个稳定的、精度达 1 厘米的 RTK 向量,是完全相同的算术。一张宽阔的评分板还会带来另一层错觉,让人以为更多的列意味着更多的信息,而实际上这些列大多只是对少数几个独立信号的重复表述,而投资者自身的注意力,无论如何,最终在做决定的那一刻都会悄悄把整张评分板压缩成一两个熟悉的维度。
真正的解法不是更多数据,而是数量更少的独立信号,直接进行比较,并让它们之间的分歧保持可见,而不是被平均掉直到消失。对投资者而言,这是一种思维上的自律,而不是什么新发现:当眼前的问题是亚马逊对沃尔玛,或者任何其他两只股票组成的候选名单时,请按那些真正相互独立变动的因子去排列它们之间的差异——不要只是欣赏哪个名字在你恰好第一眼看到的那一个比率上跨过了更高的绝对门槛。
参考文献
Hofmann-Wellenhof, B., Lichtenegger, H., & Wasle, E. (2008). GNSS – Global Navigation Satellite Systems: GPS, GLONASS, Galileo, and More. Springer.
Pinches, G. E., Mingo, K. A., & Caruthers, J. K. (1973). The Stability of Financial Patterns in Industrial Organizations. The Journal of Finance, 28(2), 389–396.
Chen, K. H., & Shimerda, T. A. (1981). An Empirical Analysis of Useful Financial Ratios. Financial Management, 10(1), 51–60.
Sloan, R. G. (1996). Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings? The Accounting Review, 71(3), 289–315.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset(第 3 版). Wiley.
DUEL Methodology: duelstocks.com/methodology
DuelStocks,《有多少个独立信号?一个 8 因子股票模型的主成分分析》。
仅供信息和教育目的使用,不构成投资建议。过去的会计数据不保证未来的结果。在做出任何决定之前,请以 SEC 原始申报文件核实所有数字。
方法论深度分析,来自真实对决的真实数字,从零开始计算并验证。不构成投资建议。
我们第一篇关于脆弱性的文章,是在「每因子赢家通吃」规则下分析 DUEL 的:在八个 SEC 因子中的每一个上,得分更好的一方拿走该因子的全部权重,较弱的一方分文未得,一场对决的接近程度被压缩成一个清晰的数字——分差 ÷ 2。自那篇文章发表以来,DUEL 的线上打分算子已经改变。网站现在使用软性相对得分:每个因子按两家公司之间分差的大小来缩放,而不仅仅按其正负号。这一变化不只是压缩了得分差距——它改变了打分博弈本身的数学结构,这意味着脆弱性问题需要重新推导,而不只是用新数字重新算一遍。本文取原始分析中的同一批八场对决,用当前算法重新计算,并在相同的三个严谨程度上再次提出同样的三个问题:每场对决有多接近,随机的权重扰动是否与代数结果一致,以及某个因子标称的权重是否真的等于它的决定性权力。
第一层:得分现在如何运作,「接近」意味着什么
对每个因子,两家公司的原始值都会输入一次软性归一化:t = (a' − b') / (|a'| + |b'| + ε),然后 N_a = 1/2 + 1/2·t,N_b = 1/2 − 1/2·t(ε 是一个很小的常数,只有当两个值都恰好为零时才起作用)。斯隆比率在这一步之前会被取反,因为在那里数值越低越好。最终得分对每一方都是 Score = 100 × Σ(权重 × N),使用与之前相同的默认权重——营收增长 16%、经营现金利润率 15%、ROIC 15%、斯隆比率 12%、资产周转率 10%、应收账款周转率 8%、营业利润率 12%、自由现金流利润率 12%。我们逐家公司地用当前 SEC EDGAR 的原始数值重新推导出全部八个得分;在四舍五入的误差范围内,每一个都与线上网站发布的得分一致。
| 对决 | 得分(当前) | 用同一批数据、按旧版赢家通吃规则算出的得分 |
|---|---|---|
| NVDA 对 AMD | 67–33 | 80–20 |
| GOOGL 对 META | 39–61 | 0–100 |
| AMZN 对 WMT | 51–49 | 55–45 |
| CRM 对 NOW | 54–46 | 59–41 |
| VRTX 对 REGN | 57–43 | 61–39 |
| GFF 对 WOR | 59–41 | 73–27 |
| BHE 对 PLAB | 34–66 | 30–70 |
| KO 对 PEP | 55–45 | 75–25 |
右边这一列并不是我们原始文章在八月发布的数字——那个数字用的是八月的 SEC 申报数据。这是一个同数据反事实计算:我们把当前的原始因子数值代入已经退役的赢家通吃规则,唯一目的是在保持基础财务数据不变的情况下,单独分离出算子变更本身的效应。在这个受控比较下,结果是明确的:八场对决的胜者完全相同。变化的是幅度,不是方向。这个八场对决的面板上,平均绝对得分差从旧规则下的 43.3 分降到软性打分下的 17.4 分(中位数从 43.0 降到 15.4)——大致减半,其唯一原因就是不再有任何因子仅凭一个狭窄、有时几乎察觉不到的优势就拿走全部权重。
因为软性打分是加权求和而不是赢家通吃式投票,两家公司之间的差距可以精确分解,完全不需要任何模拟:分差(以分为单位)= 100 × Σ(权重_k × t_k),每一项都是该单个因子的精确点数贡献。两场对决展示了这个范围:
AMZN 对 WMT(分差 +2.4 分——面板中最接近的一场对决):经营现金利润率为 Amazon 贡献 +8.8 分,自由现金流利润率贡献 +9.9 分;斯隆比率为 Walmart 贡献了满满 −12.0 分,应收账款周转率贡献 −6.2 分(Walmart 64.4 倍的应收账款周转率对 Amazon 的 8.1 倍,是整个面板中最大的原始分差)。最终分差是这些巨大、部分相互抵消的因子贡献之后留下的一小段余量——这正是这场对决脆弱的原因,也正是单一分差数字所掩盖的东西。
GOOGL 对 META(分差 −22.4 分):全部八个因子,无一例外,都对 META 有利。这与 VRTX 对 REGN 这样的对决在数学上截然不同:在那场对决中,Vertex 在五个因子上领先,Regeneron 在三个因子上领先,但 Vertex 的总分依然以相当舒服的 +13.8 分获胜。一方横扫全部因子的对决,无论对非负权重进行多么极端的重新分配都无法逆转——分差是八个符号完全相同的数字的凸组合,因此无论权重方案多么偏斜,都不可能把这个组合推过零点。这个面板中八场对决里有三场在这个意义上是完全横扫:GOOGL 对 META、BHE 对 PLAB;而 CRM 对 NOW 不是(CRM 在五个因子上领先,NOW 在三个因子上领先,因此下文将探讨其翻转的可能性)。
第二层:蒙特卡洛——随机性是否与代数一致?
和原始文章一样,我们为每场对决运行了 10,000 次模拟,将八个权重中的每一个都独立、均匀地从其默认值的 ±50% 范围内抽取,然后将抽取结果重新归一化,使其总和为 100%。由于软性打分是连续的,我们不需要在每次抽取时重新推导每家公司的原始因子位置——某场特定对决的八个 t_k 值由 SEC 数据固定,与权重完全无关;只有加权和才依赖权重。相较于旧版赢家通吃博弈,这本身就是一种结构性简化:在旧博弈中,某个因子由哪家公司「拥有」早已固定,只有权重在移动,但翻转点取决于阈值,而不是一个连续函数。
| 对决 | 分差 | 翻转率(10,000 次抽取) |
|---|---|---|
| NVDA 对 AMD | +34.6 | 0.00% |
| GOOGL 对 META | −22.4 | 0.00% |
| AMZN 对 WMT | +2.4 | 36.02% |
| CRM 对 NOW | +8.0 | 1.22% |
| VRTX 对 REGN | +13.8 | 0.00% |
| GFF 对 WOR | +17.0 | 0.12% |
| BHE 对 PLAB | −31.5 | 0.00% |
| KO 对 PEP | +9.3 | 0.00% |
八场对决中有六场在 10,000 次抽取中从未翻转;第一层的代数已经告诉我们,这六场里有三场在任何重新加权下都不可能翻转,另外三场则只是分差足够宽,±50% 的权重噪声很少能触及。AMZN 对 WMT 是明显的异常值,在略超过三分之一的抽取中翻转——这个翻转率明显高于我们在旧算法下测得的同一对公司的 14.8%。这不是矛盾;这是更诚实的数字。在赢家通吃下,Amazon 的 55:45 看起来像是一个舒服的十分缓冲。在软性打分下,同样的基础数据产生了 51.2:48.8 的分差,因为赢家通吃给了 Amazon 全额信用去奖励它仅以微弱优势胜出的因子(营收增长、营业利润率),却对 Walmart 以巨大优势胜出的因子(应收账款周转率、斯隆比率)什么都不给——这种不对称的信用分配,在两者相互抵消之前,把表面上的分差朝两个方向都吹大了。软性打分消除了这种虚高,剩下的是一场真正接近的对决,蒙特卡洛的结果也证实了这一点。
具体看在 AMZN 对 WMT 翻转的 3,602 次抽取中,哪个因子往往携带最大的随机权重:ROIC 在 38.0% 的翻转中携带最大权重,营收增长占 27.3%,经营现金利润率占 14.5%。这为「这里究竟是什么因子在真正决定结果」给出了一个有用且具体的答案,不同于只问翻转发生的频率。CRM 对 NOW 很少翻转(1.22%),但一旦翻转,营收增长压倒性地是携带最大随机权重的因子(占翻转的 88.5%)——这并不意外,因为 ServiceNow 22.4% 的三年营收复合年增长率对 Salesforce 的 9.8%,是整个面板中不利于该对决基准胜者的最大因子分差。
第三层:因子标称的权重现在是否真的等于其实际权力?
原始文章中最具结构性的发现,使用了 Shapley-Shubik 指数——这是 Lloyd Shapley 与 Martin Shubik 于 1954 年构建的一个工具,用于衡量加权多数博弈中的决定性投票权力,后来同样的数学方法被用于分析欧盟部长理事会和联合国安理会中的投票权力。在赢家通吃下,DUEL 的八个因子恰好构成了这种类型的博弈:八名「选民」,各自拥有固定权重,以简单多数(超过 50%)决定哪一方获胜。我们发现,标称权重与 Shapley-Shubik 权力系统性地存在偏差——应收账款周转率公开的 8.0% 权重,实际只携带了 6.1% 的决定性权力(比率为 0.76 倍),而营收增长 16.0% 的权重却携带了 18.2% 的决定性权力(1.14 倍)。较小的权重在结构上的价值低于其数字所暗示的价值;较大的权重则价值更高。这种偏差是多数阈值博弈众所周知的数学属性,并非这个工具特有的缺陷——任何带有多数阈值的逐因子赢家通吃系统都会继承这一属性。
软性打分彻底消除了阈值。不再存在某一方跨过 50% 就拿走一切的那个点;得分不过是 Score = 100 × Σ(权重_k × N_k),一个关于权重的线性函数。这重新划定了背后博弈的类别。加权多数博弈是博弈论学者所称的本质性(essential)博弈——联盟的价值可能大于或小于其各部分之和,这正是使 Shapley-Shubik、Banzhaf 这类投票权力指数变得必要且非平凡的原因。一个纯线性、无阈值的求和,则是博弈论学者所称的非本质性(可加性)博弈:任何因子联盟的价值恰好等于每个因子单独贡献之和,因子之间完全没有交互效应。1953 年 Shapley 最初提出的价值概念,对这种情形有一个直接且广为人知的推论:在一个可加性博弈中,每个参与者的 Shapley 值恰好等于该参与者自身的个体贡献,原因很简单——把因子 k 加入任何联盟,无论联盟中已有哪些因子、无论顺序如何,每一次都恰好使该联盟的价值改变权重_k × t_k。当一个边际贡献在所有可能的联盟和所有可能的顺序上都是常数时,Shapley 值(所有顺序上边际贡献的加权平均)就没有什么可平均的了——它直接坍缩为那个常数。
我们没有仅仅引用这条定理,而是用数值方法进行了验证。对于 AMZN 对 WMT,我们通过对全部 8! = 40,320 种可能顺序的穷举枚举,计算了八个因子各自的 Shapley 值:
| 因子 | 精确点数贡献(100 × 权重 × t) | Shapley 值,40,320 种顺序 | 差异 |
|---|---|---|---|
| 营收增长 | +6.080 | +6.080 | 小于 1e-11 |
| 经营现金利润率 | +8.829 | +8.829 | 小于 1e-11 |
| ROIC | −3.858 | −3.858 | 小于 1e-11 |
| 斯隆比率 | −12.000 | −12.000 | 小于 1e-11 |
| 资产周转率 | −5.779 | −5.779 | 小于 1e-11 |
| 应收账款周转率 | −6.204 | −6.204 | 小于 1e-11 |
| 营业利润率 | +5.460 | +5.460 | 小于 1e-11 |
| 自由现金流利润率 | +9.872 | +9.872 | 小于 1e-11 |
两列的数值精确吻合到浮点精度,正如可加性属性所预测的那样。用实际的话来说:原始文章第三层将其识别为赢家通吃结构性属性的权重与权力之间的落差——像应收账款周转率这样较小的因子,相对于其标称重要性被结构性低估——在软性打分下,对任何一场对决都不再存在,这是由构造决定的。一个因子公开的权重现在始终是对它在该场对决中所携带的决定性影响力的精确、完整的描述;不再需要单独运行一套权力计算,因为权重与权力是同一个数字,这源于算法的结构,而非经验上的巧合。
这些对决在行业地图上的位置
DUEL 的行业定位地图是在原始脆弱性文章发表之后上线的功能,它把某个 GICS 行业的每一个成分股都放置在两条轴上——这两条轴的选取并非随意。它们是我们自己针对八个 SEC 因子所做主成分分析(《有多少个独立信号?一个 8 因子股票模型的主成分分析》)在产品层面的直接应用,该分析发现这八个因子会收敛为四个经验上可区分的成分:现金转化(合并名义权重 39%)、资本效率(33%)、成长(16%)、应计质量(12%)。地图从每个成分中取一个代表性因子,把全部四个投影到两条易读的轴上。纵轴是 Quality-Adjusted Profitability:Y = 营业利润率 × m(斯隆),其中营业利润率代表现金转化(该成分三个利润率因子中载荷最高的一个),m(斯隆) 是由应计质量唯一的因子——斯隆比率——构建的乘数:正的斯隆比率(更多由应计项驱动的利润)把 Y 往下拉,负的则把 Y 往上拉。横轴是 Growth Efficiency:X = 营收增长 × (1 + 0.30 × z(资产周转率)),其中营收增长完整代表成长这一成分,z(资产周转率) 是资产周转率相对于行业的 z 分数,代表资本效率。选择资产周转率而非 ROIC 作为该成分的代表,是有原因的:在底层的主成分分析中,资产周转率在资本效率上的载荷是 0.60,高于 ROIC 的 0.58,而且 ROIC 还在现金转化上有 0.41 的交叉载荷——这使它单独作为资本效率代表时噪声更大、专一性更弱,而且放在已经锚定纵轴的营业利润率旁边也显得冗余。ROIC 本身不出现在任何一条轴上;它仍然是对决得分内部八个因子之一。我们八场对决中有四场落在网站目前已经绘制地图的行业内。
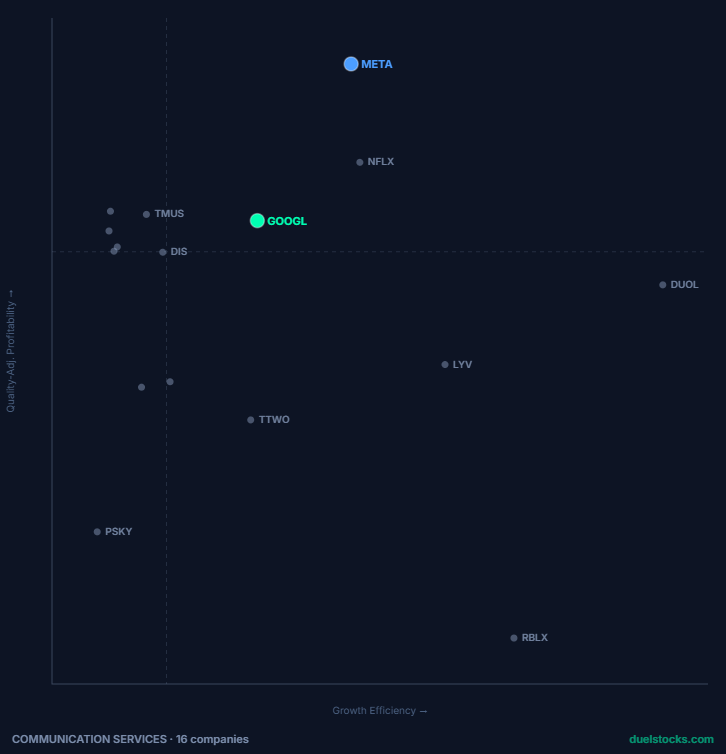
GOOGL 与 META 是这个面板中唯一一对,行业地图和对决得分乍看之下讲述了明显不同的故事。对决得分是 META 在本面板中最大的结构性胜利——一次八因子横扫,任何重新加权都无法逆转。相反,定位地图显示这两个名字彼此靠得很近,都位于 Communication Services 同业云的顶部附近,两者在两条轴上都明显高于行业中位数。两幅图都没有错;它们回答的是不同的问题。对决得分是仅限于这两家公司的正面比较;定位地图则把两者各自与该行业其余三十四家成分股相比较。META 在全部八个因子上都击败 Google,但每个因子的分差通常都很温和(上文第一层显示,八个点数贡献中有六个低于两分)——这足以干净利落地赢下一场两方对决、并在代数上实现横扫,却不足以在一幅面对更广泛同业集合构建的地图上把两个名字明显区分开。换句话说,横扫和溃败并不是同一种说法;它只意味着一个竞争者无论怎么切分同一个比较都能获胜。
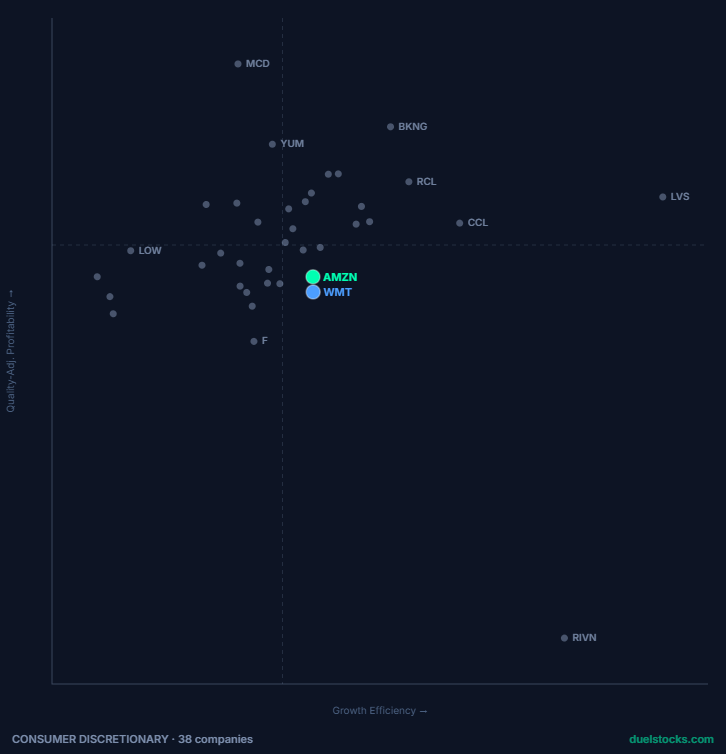
AMZN 与 WMT 在行业地图上几乎重叠在一起,横跨同一个象限边界——这是本面板中任何一对对决里视觉上最接近的一对。这与第一层和第二层在代数上的发现完全吻合:面板中最小的分差(+2.4 分)、最高的蒙特卡洛翻转率(36.02%),以及一组大多相互抵消而非相互强化的因子贡献。对于这一对,定位地图与脆弱性分析通过两种独立方法,讲述了完全相同的故事。
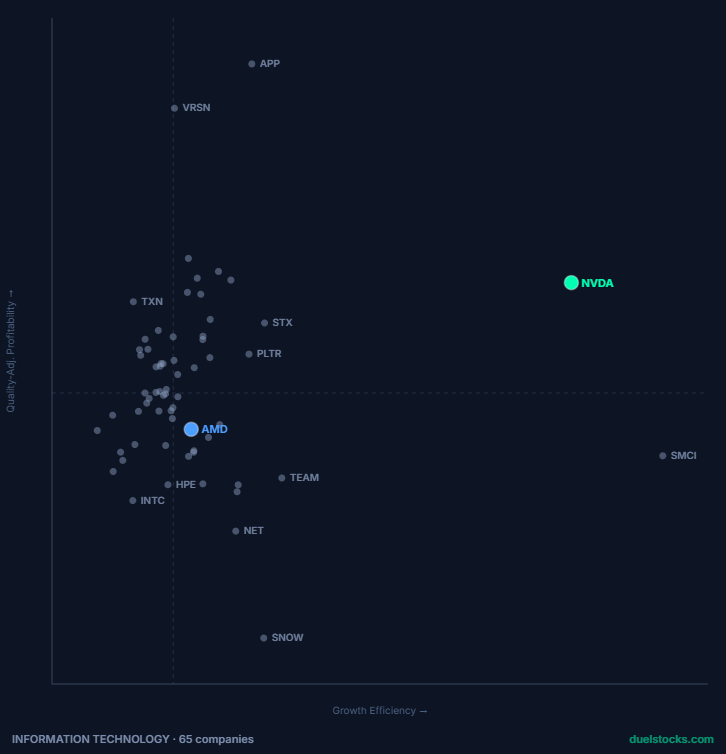
NVDA 与 AMD 之间的距离,几乎是同一行业两家公司所能达到的最大程度。NVDA 独自位于云图 Growth Efficiency 轴的右侧边缘附近,在 Quality-Adjusted Profitability 上也远高于中位数;AMD 则位于横跨两条轴中位数的密集集群之中,乍看之下和其他十几个中游名字几乎无法区分。这种视觉上的差距正是第一层在代数上讲述的同一个故事:本面板中最宽的单场对决分差(+34.6 分),由高达 100.05% 的三年营收复合年增长率驱动——这是整项研究中遥遥领先的最大原始增长数字。本面板中另一场 Information Technology 对决——CRM 与 NOW——在这幅地图上没有被单独标出,但两者都位于同一个密集的中心集群内——这与一个真实但相对温和的 +8.0 分分差,以及本面板中第二高的翻转率相符。
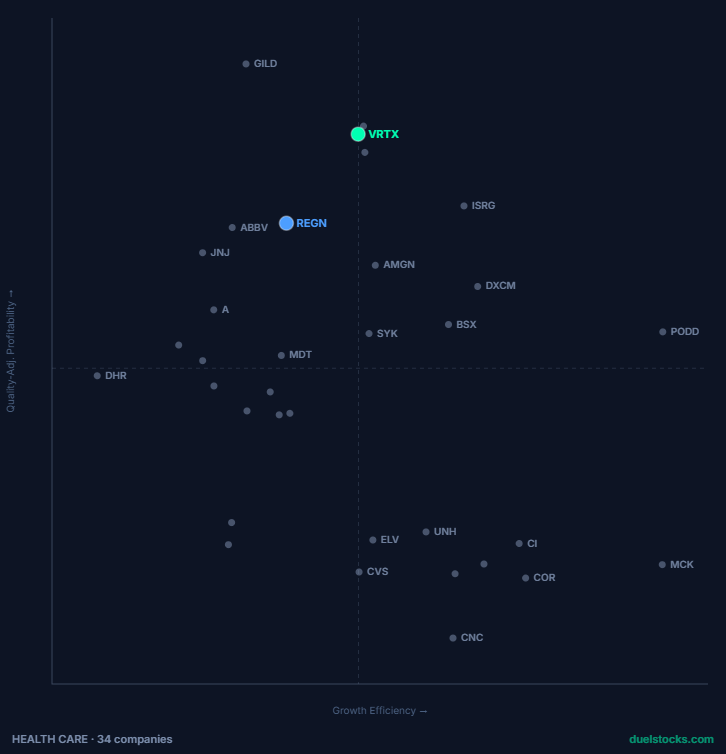
VRTX 对 REGN 是本面板中的 Health Care 对决,地图显示两者在左上象限彼此靠近——两者在 Quality-Adjusted Profitability 上都明显高于行业中位数,在 Growth Efficiency 上则都偏向较薄的一侧,Vertex 的位置略高于且偏右于 Regeneron。这种温和但可见的分离,与对决得分直接显示的情况一致:由 ROIC(+6.9 分)和应收账款周转率(+3.5 分)构筑的领先优势,足以扛住 Regeneron 在经营现金利润率和斯隆比率上的优势,产生一个温和、稳稳不脆弱的 +13.8 分分差——在 10,000 次蒙特卡洛抽取中零翻转。两家公司可以在一幅涵盖 34 个名字的行业地图上彼此靠近,却依然由其中一家干净利落地赢下两者之间的对决;地图回答的是「两者相对于行业各自表现如何」,对决得分回答的是「这两者之中哪一个更强」,而在这里,两个答案恰好指向同一个方向,尽管它们并不是同一种度量。
这次更新真正解决了什么,又没有解决什么
原始文章留下的开放问题是:基础权重方案——16/15/15/12/10/8/12/12——是否以一种对实际使用有意义的方式脆弱。在赢家通吃下,我们发现对于任何分差合理宽的对决,答案是否定的,但背后的投票机制本身系统性地把较小的因子相对于较大的因子定价过低。这次更新回答了一个相关但不同的问题:把聚合规则从多数投票换成线性求和,是否改变了这幅图景?答案是肯定的,而且是以两种彼此独立、各自都得到验证的方式。第一,在相同数据下,两个算子在本面板全部八场对决中对胜者的判断完全一致——转向软性打分并没有悄悄推翻本网站已经发布过的任何结论,它只是把虚高的分差换成了诚实的分差。第二,也是更具结构性的一点:原始文章揭示的那个具体数学病理——权重与权力的背离、较小因子被结构性低估——在软性打分下不仅仅是减弱了,而是由于构造本身而被彻底消除了,因为打分函数已经不再是那种病理可能发生的博弈类型。无论是本文还是原文都没有回答的一个问题是:16/15/15/12/10/8/12/12 在预测未来收益率的意义上,是否是「正确」的权重组合;那个校准问题依然停留在原文留下它的地方,悬而未决,而且那是一个与稳健性不同的问题。
行业地图与软性算子并非彼此独立的产品决策;两者都可以追溯到本网站发表过的研究。地图所依据的四成分结构,正是我们对八个 SEC 因子所做主成分分析——现金转化、资本效率、成长、应计质量——的发现:每个成分取一个代表性因子来定义这两条轴,使一个由四个信号构成的经验结构,在不虚构任何新数据或新因子的情况下,被投影到一幅易读的二维同业云图上。软性打分则是对原始脆弱性研究结构性发现的直接实用回应:在赢家通吃下,公开的权重与决定性权力系统性地背离。用线性求和取代阈值博弈,正如上文第三层用数值方式验证的那样,从构造上消除了这种病理。在这两个案例中,研究的顺序都是一样的——先发表测量结果,再仅在测量结果证明有理由的地方去改动线上工具。
局限性
- 八场对决的选取,是为了与原始文章的面板完全一致,而非从 DUEL 全部比较空间中随机或有代表性地抽取。
- 每家公司只使用一个 SEC 申报版本(快照日期为 2026 年 9 月 19 日);结果以该版本为条件,会随着新的 10-Q、10-K 申报到来而变化。
- 第一层中的反事实赢家通吃列,是为了分离算子效应而用同一批数据重新计算得出的;它并不是网站在八月显示过的历史得分,不应被理解为对那个数字的重新表述。
- 独立且经过重新归一化的 ±50% 权重抽取,只是若干合理扰动方案中的一种;为了与原始文章直接可比,我们沿用了它的方法论,但这并不是唯一站得住脚的选择。
- 第三层中的 Shapley 值论证,是任何线性打分函数都具有的结构性、代数性属性,这里只在一场对决上通过穷举枚举进行了验证;它不需要逐场对决重新验证,对全部八场同样成立,对在这个算法上运行的任何一场对决也都由构造成立。
- 以上任何内容都不是对收益率、回撤或分析师修正的预测。这只是关于比较如何被计算的一次稳健性与一致性检验。
参考文献
Shapley, L. S. (1953). "A Value for n-Person Games." 收录于 Contributions to the Theory of Games II, Annals of Mathematics Studies 28, Princeton University Press, 307–317.
Shapley, L. S., & Shubik, M. (1954). "A Method for Evaluating the Distribution of Power in a Committee System." American Political Science Review, 48(3), 787–792.
Banzhaf, J. F. (1965). "Weighted Voting Doesn't Work: A Mathematical Analysis." Rutgers Law Review, 19, 317–343.
Sloan, R. G. (1996). "Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings?" The Accounting Review, 71(3), 289–315.
Saaty, T. L. (1980). The Analytic Hierarchy Process. McGraw-Hill.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset(第 3 版). Wiley.
DUEL Methodology: duelstocks.com/methodology
DuelStocks,《有多少个独立信号?一个 8 因子股票模型的主成分分析》(duelstocks.substack.com)。
如果您想亲自验证以上任何内容——代入自己的权重,或测试一对我们没有覆盖到的公司——线上工具可以在 duelstocks.com 免费试用;本文中的每一个数字都可以追溯到您能在那里直接查看的报告。
不构成投资建议。所有数据均来自公开的 SEC EDGAR 申报文件。
DuelStocks 基本面深度分析。本文不构成投资建议,而且——与本系列其他文章一样——本文也不是预测。以下所有数据均来自公开的SEC EDGAR文件(10-K/10-Q),并经DUEL的Battle、DCF和Resilience(STR)报告处理。
每一个增长故事迟早都会被问到同一个问题:这种增长是否真的在转化为现金,还是只是在利润表上看起来像现金的某种东西?本文与AI无关,与任何单一行业无关,也与任何单一公司无关。这是一个通用筛选工具——一次构建,可在未来任何增长周期中反复使用——用于捕捉一种特定模式:营收以健康的速度增长,而这种增长所产生的现金却与其本应代表的账面利润出现背离。
这是本系列此前三篇文章的直接方法论延伸。篮子构建方法沿用了[有多少独立信号?一次主成分分析]。基础比率框架,包括Wilson区间和Cochran最小样本数规则,沿用了[没人谈论的信号]。而背后的应计项目质量逻辑——营收增长超过现金生成是教科书式的早期预警模式——来自Sloan(1996),这正是支撑DUEL自身Sloan比率指标的那篇论文。
在一个由72家公司组成的跨行业篮子中,哪里的3年营收增长依然强劲,而营业利润率与FCF利润率已经出现分化——DUEL自身的Sloan比率是否与这种分化相吻合?
第1部分——构建篮子
这个篮子由横跨五个行业的72家公司组成:
- 科技/半导体/软件(22家):AAPL、AMD、AVGO、CRM、GOOGL、META、MSFT、INTC、KLAC、LRCX、MCHP、MU、NFLX、NOW、NVDA、PLTR、QCOM、SNDK、SNPS、STX、TXN、XYZ
- 工业(12家):CAT、DE、F、FDX、GM、LMT、RTX、UPS、LIN、SHW、GE、HON
- 医疗健康(11家):AMGN、BDX、BMY、ISRG、REGN、VRTX、JNJ、PFE、ABT、MDT、DHR
- 消费/零售/必需消费品/电信(22家):AMZN、CCL、CL、COST、DIS、HD、HSY、KO、LOW、MDLZ、MO、PEP、PG、PM、RCL、ROST、TJX、TMUS、VZ、WMT、MCD、NKE
- 能源(5家):COP、OXY、XOM、CVX、SLB
每家公司都向SEC提交10-K/10-Q文件,并由DUEL的标准处理流程进行处理。下面两项筛选完全建立在整个篮子范围内都可获取的四个字段之上——营收增长、营业利润率、FCF利润率和Sloan比率——这正是让72家公司之间进行统一比较成为可能的基础。
第2部分——两项独立的压力筛选
"增长超过现金"并不是单一的现象——它既可能表现为已报告的营业利润明显领先于实际自由现金流,也可能表现为应计项目累积严重到足以触发Sloan自身的应计项目质量度量,而一家公司完全可能只表现出其中一种信号而没有另一种。我们对所有3年营收CAGR≥5%的公司,运行了两项独立定义的筛选:
筛选A——现金转化缺口: 营业利润率减去FCF利润率≥10个百分点。这一筛选提出的问题是:无论FCF利润率本身单独看起来是否健康,一家公司自己报告的营业盈利能力是否明显领先于这种盈利能力所产生的现金。
筛选B——Sloan比率偏高: Sloan比率>5%,这是DUEL自身"检测到中度应计项目"的阈值。这一筛选提出的问题是:净利润本身是更多地由应计项目构建的,还是由经营性现金流构建的——这是一个与筛选A的利润率缺口不同、更早期阶段的信号。
在72家公司中,34家(47%)的3年营收增长达到5%或以上。两项筛选都只在这一高增长群体内运行——一家营收持平或下滑的公司若出现巨大的利润率与现金缺口,属于一个不同的、更普通的故事(通常只是周期性或一次性项目),而不同于同样的缺口伴随真实增长一起出现的情况。
第3部分——筛选A:谁的增长速度快于其现金转化速度
| 代码 | 行业 | 营收增长(3年CAGR) | 营业利润率 | FCF利润率 | 缺口(pp) | Sloan比率 | 应收账款周转率 | FRI |
|---|---|---|---|---|---|---|---|---|
| MU | 科技/半导体/软件 | 6.71% | 26.14% | 4.46% | 21.7 | 36.86% | 1.39x | 76(高) |
| RCL | 消费/零售/必需消费品/电信 | 26.59% | 27.38% | 6.89% | 20.5 | -11.90% | 37.44x | 42(中等) |
| MSFT | 科技/半导体/软件 | 12.42% | 45.62% | 25.42% | 20.2 | 6.70% | 4.69x | 81(高) |
| MCD | 消费/零售/必需消费品/电信 | 5.06% | 46.10% | 26.73% | 19.4 | -7.61% | — | 43(中等) |
| META | 科技/半导体/软件 | 19.89% | 41.44% | 22.94% | 18.5 | -14.00% | 11.50x | 83(高) |
| GOOGL | 科技/半导体/软件 | 12.51% | 32.03% | 18.19% | 13.8 | 16.91% | 5.82x | 85(高) |
| NVDA | 科技/半导体/软件 | 100.05% | 60.38% | 47.50% | 12.9 | -6.92% | 5.30x | 64(中等) |
| PM | 消费/零售/必需消费品/电信 | 8.57% | 36.64% | 26.23% | 10.4 | -10.25% | 7.85x | 49(中等) |
在34家高增长公司中,有8家(23.5%,Wilson 95%置信区间[12.4%, 40.0%])显示出10个百分点及以上的现金转化缺口。整个72家公司篮子中单一最大的缺口属于MU,达21.7个百分点——而MU同时也拥有该篮子中最高的Sloan比率(36.86%),以及在66家有该字段数据的公司中排名第二低的应收账款周转率(1.39x,仅次于0.36x的AVGO)——三个来自同一批文件不同部分的独立信号,全都指向同一个方向。八个被标记的公司中有五家属于科技/半导体/软件行业;另外三家则是业务差异很大的消费类公司(一家邮轮公司、一家快餐连锁特许经营商、一家烟草公司)——这提醒我们,这种模式并非某个特定行业所独有,尽管它的分布并不均匀。
第4部分——这一缺口是否按行业聚集?一次基础比率检验
| 行业 | 高增长且两项利润率数据均可得 | 缺口≥10pp | 比率 | Wilson 95%置信区间 |
|---|---|---|---|---|
| 科技/半导体/软件 | 15 | 5 | 33.3% | [15.2%, 58.3%] |
| 消费/零售/必需消费品/电信 | 10 | 3 | 30.0% | [10.8%, 60.3%] |
| 工业 | 3 | 0 | 0.0% | [0.0%, 56.2%] |
| 医疗健康 | 5 | 0 | 0.0% | [0.0%, 43.4%] |
| 能源 | 1 | 0 | 0.0% | [0.0%, 79.3%] |
沿用我们此前那篇基础比率文章的同一套纪律:Cochran(1977)的经验法则要求至少观察到5起事件才能获得稳定的比率估计,而在这一切片中,只有科技/半导体/软件明确越过了这一门槛,消费/零售/必需消费品/电信紧随其后。工业、医疗健康和能源这三个行业,各自在这个篮子中拥有的高增长公司数量都太少,不足以支撑任何比率判断;它们0%的读数反映的是较小的分母(分别为3家、5家和1家公司),而不是这些行业中已被证实不存在这种模式。每个行业中都出现的宽泛且相互重叠的置信区间,正是这里如实的发现:以这样的篮子规模,我们尚不能断言现金转化缺口是科技行业特有的现象,只能说它在科技和消费行业中出现的频率足以被测量到,而在其他行业中还无法被测量。
第5部分——筛选B:高增长公司中偏高的Sloan比率
| 代码 | 行业 | 营收增长(3年CAGR) | Sloan比率 | 应收账款周转率 | FRI | DUEL的ROIC对Sloan标记 |
|---|---|---|---|---|---|---|
| MU | 科技/半导体/软件 | 6.71% | 36.86% | 1.39x | 76(高) | OK |
| SNDK | 科技/半导体/软件 | 6.52% | 27.58% | 2.70x | 33(低) | OK |
| GOOGL | 科技/半导体/软件 | 12.51% | 16.91% | 5.82x | 85(高) | OK |
| AMZN | 消费/零售/必需消费品/电信 | 11.73% | 13.01% | 9.49x | 100(高) | OK |
| NOW | 科技/半导体/软件 | 22.38% | 7.67% | 6.03x | 88(高) | OK |
| MSFT | 科技/半导体/软件 | 12.42% | 6.70% | 4.69x | 81(高) | 谨慎 |
在34家高增长公司中,有6家(17.6%)的Sloan比率超过5%。六家中有五家恰好属于科技/半导体/软件行业。六家中只有一家——MSFT——真正触发了DUEL自身的ROIC对Sloan一致性检查;其余五家,包括拥有整个篮子中遥遥领先的最高Sloan比率的MU在内,在这项特定的内部检查中都显示为OK,因为DUEL的ROIC对Sloan标记是由高ROIC与偏高的Sloan比率两者的组合触发的,而不是单独由Sloan比率触发。MU自身的ROIC在本快照中并未越过与其Sloan比率配对、从而触发该标记所需的门槛——这提醒我们,直接读取Sloan比率本身,而不仅仅依赖其下游标记,能够揭示出该标记自身未能显现的情况。
有三家公司——MU、MSFT和GOOGL——同时出现在筛选A和筛选B中:一个真实的利润率与现金缺口,以及一个偏高的Sloan比率,二者独立地来自同一批文件的不同部分,却指向同一个潜在的故事。这种重合,比任何一项筛选单独来看,都是这个篮子中最强的信号。
第6部分——两项检查,两个问题:增长对FCF 与 利润率缺口筛选的对比
DUEL内置的增长对FCF一致性检查和筛选A,都是对同一批文件的合理解读,而在这个篮子中,二者在很大程度上是不一致的:DUEL自身的标记对筛选A识别出的八家公司中的七家显示为OK,其中包括拥有整个篮子最大缺口和最高Sloan比率的MU。只有RCL同时触发了这两项检查。
这种不一致是每项检查被设计用来衡量的内容本身的特点,而不是二者之中任何一个的缺陷。从DUEL自身冲突提示的措辞来看("营收增长18.6%,FCF利润率5.7%:请关注现金转化情况"),其增长对FCF标记的设定,似乎是为了捕捉那些在高增长的同时FCF利润率绝对值偏低的公司——它问的是:"这家公司尽管增长迅速,却几乎不产生现金吗?"筛选A提出的是一个更狭窄、自我参照式的问题:"这家公司自己报告的营业利润,是否明显领先于它自身的现金生成?"一家公司完全可能拥有一个相当体面的两位数FCF利润率——MSFT的25.42%单独来看就是一个强劲的数字——却仍然相对于其自身45.62%的营业利润率,显示出真实的缺口。一个针对绝对FCF利润率进行校准的标记,没有理由对一家FCF利润率本身看起来不错的公司发出警报;而一个只将公司与其自身进行比较的筛选,则捕捉到了同一个潜在问题中不同的、互补的一个切面。这个篮子生动地说明了一项检查自身的定义在多大程度上决定了它能发现什么——这与我们此前关于脆弱评分的文章针对排名权重所展示的道理完全相同。
第7部分——这究竟回答了什么,又没有回答什么
本文并不能、也无法告诉你,任何被标记公司的增长质量低下、其股票被高估,或者其现金转化会进一步恶化。营业利润率与FCF利润率之间的巨大缺口,可能反映的是营运资金的时间性、真实增长投资阶段中较高的资本支出、递延收入的会计机制,或者仅仅是会计结构本身——未必构成问题。本文真正直接且可重复地展示的是:在五个行业的72家公司中,一种具体且可衡量的模式——高营收增长伴随着已报告营业盈利能力与实际现金生成之间的巨大缺口,或者伴随着严重到足以撼动Sloan自身比率的应计项目累积——存在于这个篮子中大约四分之一的高增长公司中,主要集中在科技/半导体/软件行业但并不仅限于此,并且对DUEL自身内置的某一项一致性检查而言,这种模式在很大程度上是不可见的,恰恰是因为那项检查被设定用来捕捉一个相关但不同的信号。
局限性
两项筛选都使用了在整个篮子范围内统一可得的DCF层面横截面数据——营收增长、营业利润率、FCF利润率和Sloan比率。包括应收账款周转率在内的其他Battle Report因子,都在这两项筛选的定义范围之外;在第3部分和第5部分中出现应收账款周转率的地方,它只是被标记公司旁边的描述性背景信息,并非任何一项筛选通过/未通过标准的组成部分。
10个百分点的缺口阈值和5%的Sloan阈值是构建出来的惯例,而非普遍常数。 更严格或更宽松的缺口阈值会使公司进入或退出筛选A;筛选B的Sloan临界值也是如此。我们选择了整数且站得住脚的数字,而不是为了得出特定结果而对阈值进行优化,但不同的合理选择会改变具体的公司名单,而不会改变更广泛的行业模式。
五个行业中有三个在这个篮子中拥有的高增长公司数量太少,不足以支撑基础比率的判断, 根据Cochran(1977)的最小样本数指导原则——工业(3家)、医疗健康(5家)和能源(1家)。它们在第4部分中0%的读数描述的是这个篮子的情况,而不是在更广泛意义上已被证实这些行业中不存在该模式。
当某家公司的韧性报告不属于本篮子评分字段的一部分时,FRI不会显示; 两项筛选均不受此影响,因为二者都不依赖FRI。
这是一个跨越数周的单一申报期快照, 而不是一个纵向或时点一致的篮子。一家公司的增长对现金特征,可能会、也确实会从一个季度的申报变化到下一个季度。
七十二家公司是一份诊断性篮子,而非美国上市市场的随机或代表性样本——请将第4部分中的行业基础比率解读为对这个篮子的描述,而不是对整体population水平的估计。
结论
在一个涵盖五个行业、72家公司的篮子中,大约四分之一的高增长公司显示出已报告的营业盈利能力明显领先于实际现金生成,大约六分之一显示出严重到足以撼动其自身Sloan比率的应计项目累积——其中三家公司独立触发了这两个信号,而这三家中的一家(MU)在应收账款周转率上也处于整个篮子的末端附近。这一模式集中在科技/半导体/软件行业,其次是消费行业,尽管这个篮子在其他三个行业中规模太小,无法判断这种集中现象是真实存在的,还是这个特定篮子所产生的人为结果。而至关重要的是,这项筛选所标记的大多数公司,都干净地通过了DUEL自身内置的增长对FCF检查——这并不是因为这两项检查中有一项出了故障,而是因为它们本就是为了捕捉不同的东西而设计的。这些都不是可以据此采取行动的信号。这是一个探测器,一次性地由公开申报文件和一个有据可查的公式构建而成,设计用来在未来无论哪个行业主导下一轮增长周期时,再次运行。
本文中的每一个数字,都可以追溯到你自己在duelstocks.com上拉取并重新核实的一场对决。
延伸阅读——同一系列,同一方法
本文延伸了本系列此前几篇文章所确立的篮子构建与基础比率方法论,您可以在本站下方找到这些文章。
参考文献
Sloan, R. G. (1996). Do stock prices fully reflect information in accruals and cash flows about future earnings? The Accounting Review, 71(3), 289–315.
Dechow, P. M., Ge, W., Larson, C. R., & Sloan, R. G. (2011). Predicting material accounting misstatements. Contemporary Accounting Research, 28(1), 17–82.
Cochran, W. G. (1977). Sampling Techniques(第3版). Wiley.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset(第3版). Wiley.
美国证券交易委员会——EDGAR全文检索及结构化XBRL申报数据,sec.gov。
DuelStocks方法论深度分析。本文不构成投资建议。所有数据均来自公开的SEC EDGAR申报文件。
DuelStocks 基本面深度分析。本文不构成投资建议,而且——与本系列其他文章一样——本文也不是预测。以下所有数据均来自公开的SEC EDGAR文件(10-K/10-Q),并经DUEL的Battle、DCF和Resilience(STR)报告处理。
AI建设中的每一块芯片都必须由某种东西来制造,而这个"某种东西"是一个真正的寡头垄断:芯片制造商自身所依赖的一小撮公司。本文停留在这个寡头垄断内部——AMAT、LRCX、KLAC、TER和ONTO——并提出一个比本系列更宏观的基础设施文章更狭窄、更精确的问题:在一个纸面上已经看起来很强的五家公司群体中,经过系统比较后谁真正胜出,而这个答案又在多大程度上取决于你选择如何为比较赋权?
在上市半导体资本设备供应商这一狭窄圈子内,谁赢得了完整的循环赛式相对比较,谁在利润率已经很高的情况下拥有最大的建模上涨空间,韧性是否与"显而易见"的周期领跑者相吻合——还是说,排名本身会因评分权重的不同而摇摆?
第1部分——构建篮子,以及一处值得说明的修正
这个篮子由五家公司组成:AMAT(应用材料)、LRCX(拉姆研究)、KLAC(科磊)、TER(泰瑞达)和ONTO(安托恩创新)。这五家公司都向SEC提交10-K/10-Q文件,DUEL的处理流程能够干净地读取它们。
本文最初计划围绕一场完整的十场对决循环赛展开——五家公司中的每一家都与其他每一家进行比较,这沿用了我们此前文章[超越单一对比]中使用的方法。事实证明,这比这个问题实际所需的数据收集量要大得多。DUEL自己的方法论公开发布了其评分公式:得分 = Σ(Wᵢ × Nᵢ) × 100,其中Wᵢ是每个因子的固定权重,Nᵢ是恰好两家公司之间该因子的简单胜/负/平标记(1、0或0.5)。由于底层的因子数值本身——营收增长、利润率、ROIC、Sloan比率、周转率——都不依赖于对手(这一有效性检查已在我们第一篇文章中用MU验证,本文中又用LRCX验证,见第3部分),一家公司相对于篮子中其他每一家公司的完整循环赛战绩,都可以从原始因子数据表中通过分析方法重建出来。我们只需要足够的对决来看一次每家公司的原始数字,而不需要十场正面交锋。两场新对决——AMAT对TER和ONTO对LRCX——提供了此前2026年7月26日的LRCX对KLAC对决尚未覆盖的三家公司的数据,本文中的其他每一对组合,都是直接根据这四场对决所公开的输入数据,使用DUEL自己发布的公式计算得出的。
以这种方式重建矩阵所带来的一个后果,值得立即指出:这需要每家公司完整的八因子Battle Report数据表(营收增长、经营现金利润率、ROIC、Sloan比率、资产周转率、应收账款周转率、营业利润率、FCF利润率),而7月26日的LRCX对KLAC对决只给了我们KLAC的五个DCF模型输入值,没有给出其资产周转率或应收账款周转率。因此,KLAC出现在本文DCF和韧性部分的各处,但被排除在第3部分重建的循环赛矩阵之外,因为在那部分我们只对五家公司中的四家拥有完整数据。与其近似估算八个加权因子中的两个,我们更愿意明确说明这一空缺。
第二点值得一开始就说明:这里LRCX的数字来自2026年8月18日的申报快照,而KLAC的数字来自2026年7月26日——而LRCX自身的数字在这两个日期之间发生了实质性变化(营收增长率2.29%→10.06%,ROIC 42.54%→53.69%,出现在DUEL自己的对决历史记录中),最有可能的原因是这期间新的季度申报文件出炉了。我们全文使用更新的LRCX快照,并明确指出日期差距,而不是混用两个不同的申报期数据。
第2部分——八因子记分卡
| 代码 | 营收增长(3年CAGR) | 经营现金利润率 | ROIC | Sloan比率 | 资产周转率 | 应收账款周转率 | 营业利润率 | FCF利润率 |
|---|---|---|---|---|---|---|---|---|
| AMAT | 3.23% | 28.05% | 25.84% | -3.44% | 0.70x | 4.45x | 29.22% | 20.09% |
| TER | 0.37% | 21.14% | 15.79% | 8.89% | 0.65x | 2.87x | 20.38% | 14.12% |
| ONTO | 0.00% | 32.66% | 14.89% | 2.93% | 0.27x | 2.98x | 13.22% | 29.82% |
| LRCX | 10.06% | 25.21% | 53.69% | 9.90% | 0.99x | 4.35x | 35.29% | 21.24% |
| KLAC* | 9.69% | 无数据 | 5.42% | 2.39% | 无数据 | 无数据 | 6.35% | 30.82% |
*KLAC的数据来自2026年7月26日的一场对决,且不完整——经营现金利润率、资产周转率和应收账款周转率都不是那场对决所捕获输出的一部分。KLAC的营业利润率(6.35%)和ROIC(5.42%),相对于这家公司典型的历史区间、以及同一快照中其自身30.82%的FCF利润率来看,也显得异常偏低;这带有期间对齐错位的特征(网站自己的Battle Report就警告过,混用季度和年度字段可能恰好产生这种不匹配),而不是真正的经营恶化。我们如实报告这一数字,并对其加以标注,而不是悄悄地加以修正。
除了一场特定的对决之外(见第3部分),没有任何一家公司在所有因子上都获胜。LRCX录得该组中遥遥领先的最强ROIC(53.69%)和最强营业利润率(35.29%),但同时也是Sloan比率最高的一家(9.90%)——这正是第5部分中DUEL自身的韧性报告直接捕捉到的应计项目质量信号。ONTO的营收基数最小,历史增长基本持平(0.00%),但拥有篮子中第二高的FCF利润率(29.82%)和最低的资产周转率(0.27x)——这是一家将小规模、低周转的资产基础异常高效地转化为现金的公司。AMAT和TER在大多数因子上处于中间位置,AMAT在全部八个因子上都领先于TER。
第3部分——循环赛:谁在正面交锋中真正获胜
利用DUEL自己发布的公式,重建拥有完整数据的这四家公司之间的每一场对决,可以得出一个完整的六场对决循环赛:
| 对决 | 得分 | 获胜者 |
|---|---|---|
| AMAT 对 TER | 100 — 0 | AMAT(横扫——全部8个因子) |
| AMAT 对 ONTO | 73 — 27 | AMAT |
| TER 对 ONTO | 53 — 47 | TER |
| AMAT 对 LRCX | 35 — 65 | LRCX |
| TER 对 LRCX | 12 — 88 | LRCX |
| ONTO 对 LRCX | 39 — 61 | LRCX(由DUEL直接确认) |
LRCX赢得了它的全部三场对决;AMAT在三场中赢了两场(只输给了LRCX);TER和ONTO平分了它们唯一一次的正面交锋,TER的胜利是整张表中差距最小的结果。将每家公司在三场对决中的得分取平均值,可以得出一个综合排名:
| 排名 | 代码 | 平均得分 |
|---|---|---|
| 1 | LRCX | 71.3 |
| 2 | AMAT | 69.3 |
| 3 | ONTO | 37.7 |
| 4 | TER | 21.7 |
LRCX以平均两分的优势险胜AMAT位居榜首——这个差距足够小,以至于第6部分要测试这个结果是否能在权重的合理调整下保持不变。
第4部分——有多少增长已经反映在价格中
DUEL的DCF引擎仅依据每家公司自身的公开文件,构建公允价值和3年价格预测:不以市场价格作为输入,不使用分析师增长预测,只使用营收CAGR、FCF、ROIC和Sloan比率,通过固定公式处理(完整方法论见我们此前关于[DCF置信区间]的文章)。
| 代码 | 公允价值(T0) | 建模+3年价格 | 建模3年上涨空间 |
|---|---|---|---|
| TER | $31.63 | $40.06 | 26.7% |
| ONTO | $84.27 | $102.62 | 21.8% |
| AMAT | $118.65 | $141.90 | 19.6% |
| LRCX | $103.19 | $117.61 | 14.0% |
| KLAC | $780.69 | $884.91 | 13.3% |
循环赛的获胜者和DCF的获胜者是两家不同的公司。LRCX——正面交锋排名中最强的名字——在该组中拥有第二低的建模上涨空间,原因与英伟达在芯片/网络那篇文章中呈现出最小建模上涨空间的结构性原因相同:LRCX自身的企业价值相对于其自身预测的现金流已经很大,因此将固定的增长路径向前推演,产生的公允价值估计变动百分比,要小于在更小基数上进行同样操作所产生的变动。TER是循环赛中最弱的一个(平均21.7分),却展现出最大的建模上涨空间——它当前的估值所反映的自身历史轨迹最少,恰恰是因为这条轨迹(0.37%的历史营收增长率)是篮子中最不起眼的。KLAC 13.3%的上涨空间,应该与第2部分中的输入数据质量提示一并阅读:如果它的营业利润率和ROIC因本快照中的数据异常而被低估,那么它的建模上涨空间更可能是被低估而非被高估,因为这两项数据都会输入模型的增长质量乘数。
第5部分——谁真正拥有资产负债表的护甲
| 代码 | FRI评分 | 等级 | 增长 vs FCF | ROIC vs Sloan | 债务 vs 现金 |
|---|---|---|---|---|---|
| ONTO | 100 | 高 | OK | OK | OK |
| TER | 93 | 高 | OK | OK | OK |
| AMAT | 78 | 高 | OK | OK | OK |
| KLAC | 76 | 高 | OK | OK | 风险 |
| LRCX | 63 | 中等 | OK | 谨慎 | OK |
这是本文中反差最强烈的部分。LRCX——循环赛的获胜者,也是该组的ROIC领跑者——却背负着五家公司中最低的韧性评分,原因是一个特定的标记:它53.69%的ROIC与9.90%的Sloan比率并列,触发了DUEL的ROIC对Sloan一致性检查,这正是我们在关于这一确切冲突类型的基础比率文章中详细探讨过的同一个"轻微应计项目累积"信号。这不是债务对现金的问题——LRCX的现金对债务覆盖率舒适地高于1.0倍——这是一个提示,说明LRCX所报告的部分盈利能力是通过应计项目而非现金实现的,这更值得关注而不是本身就构成一个危险信号。KLAC则是相反的情况:一个干净的增长对FCF与ROIC对Sloan特征,却被一个真实的债务对现金标记(债务权益比1.1倍,现金仅能覆盖总债务的0.3倍)所削弱——这是一个杠杆问题,而不是盈余质量问题。ONTO是篮子中按营收计算规模最小的公司,却以明显优势录得该组中最干净的韧性特征:无债务的资产负债表(总债务:$0.00)和完美的100分FRI。
第6部分——这个排名有多脆弱?对权重进行压力测试
第3部分的循环赛使用了DUEL发布的生产权重(营收增长16%、经营现金利润率15%、ROIC 15%、Sloan比率12%、资产周转率10%、应收账款周转率8%、营业利润率12%、FCF利润率12%)。这些权重是一个合理的、已公开的选择——但并非唯一合理的选择。沿用我们此前关于[脆弱评分]文章的方法,我们在两种同样站得住脚的替代加权方案下,重新运行了这四家公司之间的相同对决,并检验排名是否能保持不变。
等权重(八个因子各占12.5%):每场对决的获胜者与生产权重下保持一致,但AMAT和LRCX最终在第一名上打成完全平局——两者在各自三场对决中的平均分都是70.8。
质量倾斜权重(ROIC和Sloan比率分别提升至25%和20%,反映的是更看重资本效率和盈余质量、而非周转率的读者视角;资产周转率和应收账款周转率各自降至5%;增长和利润率因子保持接近原始权重):AMAT直接跃升至第一名(平均71.7分,对比LRCX的65.0分)——第一名的排名发生了反转。在生产权重下以微弱优势53比47取胜的TER对ONTO这场对决,在两种替代方案下都变成了精确的50比50平局。
| 排名 | 生产权重 | 等权重 | 质量倾斜权重 |
|---|---|---|---|
| #1 | LRCX(71.3) | AMAT / LRCX(平局,70.8) | AMAT(71.7) |
| #2 | AMAT(69.3) | — | LRCX(65.0) |
| #3 | ONTO(37.7) | ONTO(37.5) | ONTO(40.0) |
| #4 | TER(21.7) | TER(20.8) | TER(23.3) |
在所有经测试的加权方案下,后两个名次都保持稳定——无论八个因子如何加权,TER和ONTO始终远远落后于领先者,尽管它们自身的正面交锋结果在TER的小幅获胜和精确平局之间摇摆。第一名的排名并不稳定——它具体取决于某一特定比较,赋予资本效率与盈余质量因子(ROIC、Sloan)相对于周转率与增长因子多大的权重。这不是DUEL方法论的缺陷——每一个公开的权重都是透明的,公式也是公开的——这是将八个不同的基本面信号汇总为一个数字这一操作,对于一对真正势均力敌的对手所具有的固有属性。社会选择理论中一个五十年前的结论(Arrow,1951)表明,一旦在不止一个维度上比较两个以上的选项,将多个已排序的标准汇总为单一排名,本质上就会对所选择的汇总规则十分敏感;这个篮子中前两名排名的反转,正是这种结构性敏感度的一个微小而具体的例证,而不是这一特定比较所独有的缺陷。
第7部分——这究竟回答了什么,又没有回答什么
本文并不能、也无法告诉你半导体资本设备支出是否会继续增长、晶圆厂设备订单在接下来几个季度是否会保持强劲,或者这五家公司中哪一家会在运营上超越其他公司。这些都是面向未来的问题,而上面的每一个数字都只描述过去和现在。
数据本身所展示的是:在这个五家公司组成的寡头垄断内部,相对实力(循环赛排名)、估值(DCF上涨空间)和资产负债表韧性(FRI)这三个不同的视角,各自指向不同的"赢家"——LRCX在相对实力上领先(勉强,且仅在一种合理的加权方案下),TER在建模上涨空间上领先,ONTO在韧性上领先。这也直接而可重复地表明:在一个竞争极为激烈的寡头垄断中,"谁最强"这个问题的答案,并不是一个等待被测量一次就能确定的固定事实——它是一个加权选择的函数,而透明的方法论必须明确说明这一选择,而不是将其隐藏起来。
局限性
KLAC被排除在第3部分的循环赛重建之外。 提供KLAC数据的2026年7月26日对决没有捕获它的资产周转率或应收账款周转率——这是八个加权因子中的两个——因此其对AMAT、TER和ONTO的正面交锋战绩无法用完整的输入数据重建。KLAC的FRI和DCF结果(第4-5部分)不依赖这两个因子,因此不受影响。
在本快照中,KLAC的营业利润率和ROIC 相对于这家公司典型的历史区间、以及同一份报告中其自身的FCF利润率而言,显得异常偏低,这与期间对齐错位而非真正的经营恶化相符。我们如实报告这些数字,而不是用一个假定的"正常"值来替代它们。
LRCX和KLAC来自不同的申报快照(分别为2026年8月18日和7月26日),随着新的季度申报文件的出炉,LRCX自身报告的数字在这两个日期之间发生了实质性变化。我们全文使用更新的LRCX数据,而不是将较旧的LRCX快照与KLAC的数据混用。
循环赛的重建假定DUEL发布的加权公式完全按照文档所述的方式应用。 我们已针对两个已知的输出结果(AMAT对TER和ONTO对LRCX)核实了这一点,并在将该方法扩展到另外四组未经确认的组合之前,精确复现了这两个结果;但我们并未针对每一个重建出的分数,独立地与一场实时对决重新进行核验。
五家公司是对一个真实寡头垄断的诊断性快照,而非统计学样本。 第6部分中关于权重敏感性的发现,描述的是这个特定快照下的这个特定篮子;这并不是在断言DUEL的排名在网站上其他数百场对决中普遍不稳定——正如我们此前关于脆弱评分的文章所发现的,其中大多数对决的竞争都没有这么激烈。
刻意不使用市场价格。 DUEL的DCF引擎忽略当前股价和分析师预测,这正是使"一家公司自身的轨迹已经假定了多少增长"成为一个干净、可核实的问题的关键所在,而不是与市场当前对该股票的定价进行比较。
结论
在构建芯片制造商自身所依赖工具的这一五家公司寡头垄断内部,没有任何一家公司在所有指标上都胜出。LRCX拥有最强的资本效率,并且——在网站自身的生产权重下——拥有最强的正面交锋战绩,但同时也是该组中唯一带有盈余质量谨慎标记、韧性评分最低的公司。TER拥有最弱的循环赛战绩,却在DUEL自身的估值数学中拥有最大的剩余空间。这里规模最小的公司ONTO,拥有最干净的资产负债表和完美的韧性评分,同时在相对实力上处于中游位置。而循环赛自身的第一名——LRCX领先于AMAT——并不是一个固定的事实:在对同样八个数字进行不同加权、但同样站得住脚的解读下,它会反转为AMAT。这些都不是关于半导体设备周期的预测。这只是五家公司自身的申报文件,以相同方式处理后,从不止一个合理角度已经说出的内容。
本文中的每一个数字,都可以追溯到你自己在duelstocks.com上拉取并重新核实的一场对决。
延伸阅读——同一系列,同一方法
本文直接建立在本系列此前几篇文章所确立的方法论之上,您可以在本站下方找到这些文章。
参考文献
Arrow, K. J. (1951). Social Choice and Individual Values. Wiley.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset(第3版). Wiley.
美国证券交易委员会——EDGAR全文检索及结构化XBRL申报数据,sec.gov。
DuelStocks方法论深度分析。本文不构成投资建议。所有数据均来自公开的SEC EDGAR申报文件。
DuelStocks 基本面深度分析。本文不构成投资建议,而且——与本系列其他文章一样——本文也不是预测。以下所有数据均来自公开的SEC EDGAR文件(10-K/10-Q),并经DUEL的Battle、DCF和Resilience(STR)报告处理。
AI基础设施的"卖铲子"框架有一个盲点:它通常止步于机架层面。芯片、网络、机架级电力/散热占据了头条新闻,但每一个机架仍然需要接入某种东西——发电能力、输配电,以及实际建造这种物理互联的电气承包商。这是一条不同的链条,有着不同的资本结构,而且——正如本文将展示的——其韧性特征与我们在[到底是谁在卖铲子?]中绘制的地图有明显不同。
这是一篇直接的续篇,而不是重复。有两个名字从那篇文章延续到这里——ETN和VRT——因为它们恰好处于"机架级电力"与"电网级电力"之间的边界上,如果在这里遗漏它们,链条中就会出现空白。其余的一切都是全新的。问题依然是我们在整个系列中一直在问的那个问题:不是这个周期正走向何方,而是账面上已经记录的数字,能说明谁现在真正在攫取这一建设成果——以及这种攫取有多少已经反映在DUEL自身的估值数学中。
已经提交的10-K/10-Q文件,能说明在美国上市的"为AI供电"链条中,谁现在正在攫取增长、利润率和资产负债表实力——在完全不涉及负荷增长预测的情况下,这些又有多少已经反映在DUEL的DCF数学中?
第1部分——构建篮子
为AI数据中心供电不是单一的业务。它至少是三种业务:发电或采购电力的公司,制造位于电网与服务器之间的开关设备、变压器和热管理设备的公司,以及实际建造并为连接两者的变电站、输电线路和电气室布线的公司。我们在这三个层级上构建了一个十家公司的篮子,再加上此前文章中作为对照组的同一批四家超大规模买家:
- 发电/公用事业公司: VST、CEG、NEE、SO
- 电力/工业(从电网到建筑的电气设备): ETN、VRT、EMR、ROK
- 建筑/电气及输配电承包商: PWR、EME
- 买家(对照组,不作为"受益者"打分): MSFT、GOOGL、AMZN、META
这样就剩下十个独特的供给侧公司和四家买家——共14家公司,每家都像网站上其他任何一场对决一样,经过DUEL的Battle Report、DCF Report和Resilience Report处理。支撑本文的十场新对决生成于2026年8月17日。四个买家档案则沿用了此前文章中使用的2026年7月26日至8月13日这一时间窗口——DUEL按公司计算的输出结果不依赖于对手,这不影响可比性,但底层的申报快照相隔了几周,这一点值得明确说明。
第2部分——增长与利润率:资本究竟落在了哪里
| 代码 | 层级 | 营收增长(3年复合年增长率) | FCF利润率 | 营业利润率 | ROIC | Sloan比率 |
|---|---|---|---|---|---|---|
| VST | 发电 | 4.31% | 7.43% | 10.75% | 5.80% | -3.42% |
| CEG | 发电 | 1.47% | 5.04% | 12.09% | 4.16% | 3.02% |
| NEE | 发电 | -3.05% | 11.67% | 58.08% | 4.21% | 0.23% |
| SO | 发电 | 0.31% | -9.93% | 24.65% | 5.07% | -3.20% |
| ETN | 电力/工业 | 9.77% | 12.94% | 13.39% | 6.83% | 15.80% |
| VRT | 电力/工业 | 21.59% | 18.51% | 17.89% | 27.99% | -2.80% |
| EMR | 电力/工业 | -2.82% | 14.80% | 无数据 | 无数据 | -1.98% |
| ROK | 电力/工业 | 2.44% | 16.58% | 20.41% | 20.37% | -2.49% |
| PWR | 建筑/输配电 | 18.60% | 5.69% | 5.66% | 8.30% | -0.70% |
| EME | 建筑/输配电 | 15.32% | 6.77% | 10.09% | 40.70% | -4.33% |
这张表首先揭示的是,"电力"并不是单一的增长故事——它至少是三个互不相关的故事。发电/公用事业层在历史基础上几乎没有增长:VST(4.31%)、CEG(1.47%)、SO(0.31%)和NEE(-3.05%)——这是一个受监管、高度依赖合同、资本周期驱动的业务,无论互联排队队列中出现多少增量需求,其营收都不会像芯片或网络营收那样波动。电力/工业设备层则恰恰相反:VRT的营收增长率达21.59%,比起自己所在板块的同行,更接近上一篇文章中的AI基础设施公司;而ETN(9.77%)和ROK(2.44%)的增长要缓慢得多,EMR在历史基础上甚至是萎缩的(-2.82%)。建筑/输配电层介于两者之间,但偏向高位——PWR(18.60%)和EME(15.32%)——这与链条中实际浇筑混凝土、铺设电缆这一环节的物理建设热潮相吻合。
利润率讲述了第二个独立的故事。VRT 18.51%的FCF利润率和27.99%的ROIC,看起来更像基础设施供应商的利润率特征,而不是公用事业公司的——从结构上看,它更接近上一篇文章中的算力/网络层,而不是它自己所贴的"电力"标签。SO的FCF利润率为负(-9.93%):目前资本支出的增速超过了经营现金流,这一模式在整个发电层反复出现,而下文第3部分将显示,这对DCF建模有实实在在的影响。NEE高达58.08%的营业利润率,与其照单全收,不如将其标记为一个需要留意的异常值——受监管公用事业公司的会计处理(对允许回报率的确认、递延监管资产)可能会产生与工业企业或软件企业在逐项因子上都不可比的营业利润率数字,即便应用的是完全相同的公式(营业收入/营收)。我们选择将其如实呈现,而不是把它抹平。
第3部分——有多少增长已经反映在价格中
正是在这里,这个篮子的两半出现了明显的分歧——也正是在这里,模型自身的假设本身成为了发现的一部分。DUEL的DCF引擎仅依据每家公司自身的公开文件,构建公允价值和3年价格预测:不以市场价格作为输入,不使用分析师增长预测,只使用营收CAGR、FCF、ROIC和Sloan比率,通过固定公式处理(完整方法论见我们此前关于[DCF置信区间]的文章)。
| 代码 | 公允价值(T0) | 建模+3年价格 | 建模3年上涨空间 |
|---|---|---|---|
| VST | $30.68 | $43.55 | 41.7% |
| EMR | $45.99 | $59.51 | 29.4% |
| ROK | $190.30 | $229.33 | 20.5% |
| ETN | $184.92 | $216.43 | 17.0% |
| PWR | $270.35 | $316.30 | 17.0% |
| EME | $641.92 | $749.20 | 16.7% |
| VRT | $203.50 | $226.82 | 11.5% |
| CEG | $0.00* | $11.21 | 模型下限——见下文 |
| NEE | $0.00* | $2.25 | 模型下限——见下文 |
| SO | $0.00* | -$8.03 | 模型下限——见下文 |
十家公司中有七家给出了普通的、可解释的上涨空间数字,从VRT的11.5%(与上一篇文章中的数字相同——证实了模型按公司计算的结果确实不依赖于对手)到VST的41.7%不等。但有三家公司——CEG、NEE和SO,全部位于发电/公用事业层——没有给出这样的数字。这是本文最重要的发现,值得精确陈述,而不是笼统归入"上涨空间较低"这一类别。
实际发生的情况是: DUEL的DCF将FCF定义为CFO减去CAPEX。对这三家公司来说,当前的CAPEX相对于经营现金流已经足够大(在SO的情况中,甚至超过了经营现金流),以至于按照模型的固定公式向前推演这个FCF基数,会把建模企业价值推低到总债务以下。模型不会报告一个负的公允价值;它会将显示的股权价值设为0.00美元的下限,并明确标记这种情况("总债务超过建模企业价值……表明存在重大的资产负债表风险,而非精确的估值")。SO的情况最为极端:其建模的3年价格轨迹是负数(0.00美元 → -2.67美元 → -5.34美元 → -8.03美元),因为其FCF基数本身就是负的,而模型没有机制来区分"在监管机构批准的建设周期中暂时性的负FCF"与"结构性烧钱的业务"。两者会产生完全相同的输出结果。
这并不是在声称Vistra、Constellation、NextEra或Southern杠杆过高或经营不善——受监管和准受监管的发电类公用事业公司,惯常以债务为多年期资本项目融资,其偿债依据是费率基础或长期合同现金流,而纯粹基于历史FCF的DCF模型从来就不是为看清这种情况而设计的。这是一个关于模型本身的发现,如实呈现:一个校准于CFO减去CAPEX、且没有费率基础、监管资产或股息折现处理的现金流折现引擎,从结构上就无法为这类资产负债表产生一个可用的公允价值。与其强行给出一个暗示比模型实际所能支撑的更高精确度的数字,我们更愿意清楚地报告这一局限性。
第4部分——谁真正拥有资产负债表的护甲
| 代码 | FRI评分 | 等级 | 增长 vs FCF | ROIC vs Sloan | 债务 vs 现金 |
|---|---|---|---|---|---|
| EMR | 100 | 高 | OK | OK | OK (见数据完整性说明) |
| VRT | 94 | 高 | OK | OK | OK |
| PWR | 76 | 高 | 谨慎 | OK | OK |
| EME | 64 | 中等 | 谨慎 | OK | OK |
| ETN | 68 | 中等 | OK | OK | 风险 |
| CEG | 53 | 中等 | OK | OK | 谨慎 |
| ROK | 50 | 中等 | OK | OK | 谨慎 |
| VST | 49 | 中等 | OK | OK | 风险 |
| NEE | 44 | 中等 | OK | OK | 风险 |
| SO | 42 | 中等 | OK | OK | 风险 |
这张表是与上一篇文章反差最强烈的地方。在芯片/网络/散热篮子中,55%的公司以干净的OK/OK/OK通过了全部三项内部一致性检查。而在这里,十家公司中只有两家做到了这一点——VRT,以及带有下文保留意见的EMR。四家发电/公用事业公司中的每一家都带有一个债务对现金的标记,而四家中有三家带的是更严重的风险级别,而不是谨慎级别。这与第3部分直接吻合:把CEG、NEE和SO的DCF公允价值锁定在0.00美元的,正是同样由债务融资驱动的资本密集度,而这里驱动它们债务对现金标记的也正是同一因素。这两个发现并非独立的发现——它们是同一个底层资产负债表结构,在DUEL模型的两个不同部分中显现出来。
EMR头条的FRI 100分需要它自己的保留意见,其精神与上一篇文章中GEV的情况相同。其韧性报告显示,若干原始资产负债表数据——现金、总债务、营业收入、股东权益——在所提取的申报期内均不可获取("—"),只能计算出投资自足性(FCF/CAPEX)这一项子评分;其余三项子指标(现金-债务覆盖率、盈余质量、流动性持续期)根本无法评分。一个仅建立在四项子指标中一项已填充数据基础上的100分,与VRT那种建立在四项子指标全部填充完整、且全部干净得分基础上的100分,是完全不同性质的100分。最可能的解释是财年日历不匹配——爱默生的财年结束于9月而非12月,这可能导致某些XBRL标记字段,在某一特定快照时点相对于按公历年计算的同行而言,数据填充较为稀疏——但在捕获到数据完整的申报期之前,EMR的FRI应被解读为暂定值,而非确定值。
PWR和EME在"增长对FCF"上都各自带有一个谨慎标记:两者的营收增速都处于百分之十几的中高段(分别为18.60%和15.32%),而FCF利润率都处于个位数中段(分别为5.69%和6.77%)——这是承包商在开票前扩张人员和营运资金时典型的、直接的现金转化滞后标记,而不是会计质量方面的担忧。
第5部分——记分卡:上涨空间 vs 韧性
将第3部分和第4部分放在一起,具有可解释DCF结果的七家公司被排列进一个2×2的网格中。每个轴上的分界点是仅基于这七家公司计算出的中位数(上涨空间中位数17.0%,FRI中位数68);CEG、NEE和SO被完全排除在这个网格之外,而不是被强行塞进一个其建模公允价值实际上并不支持的象限;它们在下文中获得了自己独立的类别。
定价具有吸引力且结构稳健: EMR、PWR(两者的FRI均高于中位数;PWR的上涨空间几乎恰好落在17.0%的中位数线上)
建模上涨空间较大,缓冲较薄: VST、ROK(上涨空间高于中位数,韧性低于中位数)
已充分定价,但极为稳健: VRT(上涨空间低于中位数,但拥有篮子中数据完整填充情况下最高的FRI)
已充分定价,缓冲相对较薄: EME
恰好落在交叉点上: ETN——其17.0%的上涨空间和68的FRI几乎精确地落在两条中位数线上,这使它成为这个篮子的支点,而不是任何一个象限中界限分明的成员。
模型下限案例(被排除在网格之外): CEG、NEE、SO——见第3部分。这三家公司在第4部分都带有债务对现金的风险或谨慎标记,并在第3部分中建模公允价值均为0.00美元;将两者结合起来看,这是整个篮子中最清晰的信号,而且它特别属于发电/公用事业这一层,而不属于电力/工业或建筑/输配电。
与上一篇文章记分卡的对比本身就是一个发现。在《铲子》一文中,十一家公司中只有两家落入最不利的象限,而且十一家公司中没有一家彻底击破了DCF模型。而在这里,十家公司中有三家在象限讨论甚至尚未展开之前就彻底击破了模型,而且它们恰好集中在链条的同一个层级——发电。"为AI供电"的故事,在基本面层面,并不是一个单一的故事;它是一个韧性十足的设备/承包商层,坐落在一个高杠杆的发电层之上。
第6部分——对照组:买家的表现如何
| 代码 | 建模3年上涨空间 | FRI评分 | 等级 |
|---|---|---|---|
| GOOGL | 20.6% | 85 | 高 |
| AMZN | 18.6% | 100 | 高 |
| MSFT | 18.6% | 81 | 高 |
| META | 16.2% | 83 | 高 |
四家超大规模买家全部落入DUEL的高韧性等级——这与上一篇文章的结果相同,而且数字也是相同的,属于沿用而非重新运算(关于沿用的时间窗口,见第1部分的说明)。这一次不同的地方在于交易另一端的对比。在《铲子》一文中,十一家芯片/网络/散热供应商的FRI从11到100不等,中位数为75——接近买家自身81到100这一区间。而在这里,十家电力链供应商的FRI从42到100不等,中位数为68,其中三家甚至完全无法通过DUEL的DCF模型。按照这一衡量标准,为这一建设提供资金的买家,其资产负债表要比那些真正在为其建设电力的发电侧公司稳健得多。
第7部分——这究竟回答了什么,又没有回答什么
要精确说明这项分析的局限性,因为在这里过度声称会破坏整个工作的意义:本文并不能、也无法告诉你美国电网容量能否跟上AI驱动的负荷增长速度、特定的发电或输电项目是否会按计划建成,或者这些公司的资本计划是否会成功。这些都是面向未来的问题,而上面的每一个数字都只描述过去和现在。
数据本身所展示的是:这条链条中的增长和利润率,确实是三个相互叠加的独立故事——一个增长缓慢、资本高度密集的发电层;一个增长迅速、利润率高的设备层;以及一个增长迅速、利润率微薄的建筑层。数据还表明,以同样的方式衡量本文和上一篇文章中全部14家公司的韧性,其在这条链条中的分布并不均衡——它集中在设备层,而在发电层则在很大程度上缺失,那里DUEL的DCF模型对四家公司中的三家彻底失效。这是关于这些特定公司今天资产负债表结构的一个陈述,是通过一个特定模型处理得出的,而不是对明天电力市场的预测。
局限性
十家公司中有三家未能产生可用的DCF公允价值。 CEG、NEE和SO全部触及了DUEL模型的下限(显示的股权价值为0.00美元,完整细节见第3部分)。这反映的是模型固定的FCF定义(CFO减去CAPEX)与受监管及准受监管发电类公用事业公司典型的、以债务融资、以费率基础为导向的资本结构之间的不匹配——而不是对这些公司真实财务健康状况或投资价值的断言。
EMR的韧性评分建立在不完整的原始数据之上, 该情况已在第4部分直接标出——由于所提取的申报期内四项子指标中有三项无法计算,最可能的原因是财年末不匹配(爱默生为9月,而大多数同行为12月)。其100的FRI评分应被视为暂定值,直到捕获到一个包含完整资产负债表数据的申报期为止。
这是一张快照,而非实时排名,也不是单一的时间窗口。 十场供给侧对决生成于2026年8月17日。四个买家档案沿用了本系列上一篇文章中使用的2026年7月26日至8月13日这一时间窗口;DUEL按公司计算的输出结果不依赖于对手,但底层的申报快照相隔了数周。
刻意不使用市场价格——这一点是双向的。 DUEL的DCF引擎刻意忽略当前股价和分析师预测,这正是让"一家公司自身的轨迹已经假定了多少增长"成为一个干净、可核实的问题的关键所在。这也意味着,这里的"建模上涨空间"并非市场隐含的预期,不应被这样解读。
篮子的构建是一种判断取舍,而非全面普查。 十个供给侧公司加四家买家,是对美国上市AI电力链一个合理的横截面,而非详尽无遗的样本;换一个同样合理的篮子,可能会改变哪些公司落入这项分析的哪个部分。
十四家公司只是一份诊断性快照,而非统计学样本——请将上述模式解读为描述性的,而非可推广到这个特定篮子之外的证据。
结论
在十家为AI基础设施供电的公司,以及为这一建设提供资金的四家超大规模买家中,增长和利润率按层级清晰地分裂为三个独立的故事——缓慢、资本密集的发电;快速、高利润率的设备;以及快速、薄利润率的建筑。韧性的分裂则更加鲜明:设备层看起来是迄今为止本系列两篇文章所考察的整个AI基础设施链条中最坚实的部分,而四家发电/公用事业公司中有三家带有真实的杠杆信号,且这三家没有一家能在DUEL模型下产生可用的DCF公允价值。这些都不是关于电网建设、负荷增长或哪些项目会获得资金的预测。这只是这些申报文件已经说出的内容,通过对屋子里每一家公司都相同的公式处理得出——其中也包括对这一公式在何处失效的如实说明。
本文中的每一个数字,都可以追溯到你自己在duelstocks.com上拉取并重新核实的一场对决。
延伸阅读——同一系列,同一方法
本文是直接建立在本系列此前几篇文章所确立的方法论之上的续篇,您可以在本站下方找到这些文章。
参考文献
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset(第3版). Wiley.
Damodaran, A. (2018). Valuing regulated and capital-intensive businesses: why standard DCF assumptions break down for rate-based utilities. 纽约大学斯特恩商学院工作笔记。
美国证券交易委员会——EDGAR全文检索及结构化XBRL申报数据,sec.gov。
DuelStocks方法论深度分析。本文不构成投资建议。所有数据均来自公开的SEC EDGAR申报文件。
DuelStocks 基本面深度分析。本文不构成投资建议,而且——与大多数关于AI周期的评论不同——本文也不是预测。以下所有数据均来自公开的SEC EDGAR文件(10-K/10-Q),并经DUEL的Battle、DCF和Resilience(STR)报告处理。
问十个人AI基础设施建设是处于早期、中期还是后期阶段,你会得到十个自信满满的答案和零个共同的证据。这是因为这个问题通常的问法本身就是一个预测性问题——"还会有多少资本支出到来"——而预测并不是这个工具所做、或声称要做的事情。DUEL对未来的AI支出没有任何观点,没有分析师预测,也没有宏观模型。
DUEL真正拥有的是更狭窄、也更可核实的东西:对构建AI基础设施的公司已经公布的财务数据进行标准化解读,看它们在增长、利润率、资本效率、估值数学和资产负债表韧性方面透露出什么信息——所有数据都来自同一来源(SEC文件),并对每一家涉及的公司运行相同的公式。因此,本文不问"我们处在周期的哪个阶段",而是提出一个DUEL确实可以用数据而非观点来回答的版本:
账面上已经记录的数字,能说明谁真正正在攫取当前AI基础设施建设带来的成果——而这种攫取有多少已经反映在DUEL自身的估值数学中?
第1部分——构建篮子
"卖铲子"是投资AI基础设施的天然框架:与其押注哪个AI应用会胜出,不如买入那些为每一种AI工作负载提供算力、网络、电力和存储的公司——无论谁最终胜出,这些需求都不会改变。我们构建了一个涵盖四个供给层的篮子,再加上第五组——处于交易另一端的超大规模买家——作为对照组,而非"受益者"群体:
- 算力: NVDA、AMD、AVGO、MU
- 网络/互连: ANET、CIEN
- 电力与散热: VRT、ETN、MOD、GEV
- 内存与存储: MU(与算力共用)、WDC
- 买家(对照组,不作为"受益者"打分): MSFT、GOOGL、AMZN、META
有一个名字明显缺席。TSM被完全排除在外。 作为一家总部位于台湾的外国私人发行人,台积电向SEC提交的是20-F年度报告,而非10-K,也不提交10-Q。DUEL的整个模型在设计上完全建立在10-K/10-Q数据之上——因此,无论一家公司在实际价值链中处于多么核心的位置,只要它在结构上不提交这些表格,就超出了这个工具能够衡量的范围。我们宁愿明确指出这个空白,也不愿悄悄用别处的数字来填补它。
这样一来,剩下11家独特的"卖铲子公司"和4家买家——共15家公司,每家都像网站上其他任何一场对决一样,经过DUEL的Battle Report、DCF Report和Resilience Report处理。支撑本文的所有对决都是在2026年7月26日至8月13日之间生成的。这是那个时间窗口的一张快照,而非永久排名——即便个别数字已经过时,这套方法论依然长期有效。
第2部分——增长与利润率:资本究竟落在了哪里
| 代码 | 层级 | 营收增长(3年复合年增长率) | FCF利润率 | 营业利润率 | ROIC | Sloan比率 |
|---|---|---|---|---|---|---|
| NVDA | 算力 | 100.1% | 47.5% | 60.4% | 51.0% | -6.9% |
| AMD | 算力 | 13.6% | 19.4% | 10.7% | 4.5% | -4.7% |
| AVGO | 算力 | 24.4% | 42.1% | 39.9% | 14.1% | -11.9% |
| MU | 算力/存储 | 6.7% | 4.5% | 26.1% | 9.0% | 36.9% |
| ANET | 网络 | 27.2% | 48.4% | 42.8% | 23.1% | 1.3% |
| CIEN | 网络 | 9.5% | 14.0% | 4.1% | 4.4% | -4.0% |
| VRT | 电力/散热 | 21.6% | 18.5% | 17.9% | 28.0% | -2.8% |
| ETN | 电力/散热 | 9.8% | 12.9% | 13.4% | 6.8% | 15.8% |
| MOD | 电力/散热 | 11.5% | 3.3% | 10.8% | 16.2% | -4.6% |
| GEV | 电力/散热 | 8.7% | 2.4% | 3.7% | 无数据 | 5.6% |
| WDC | 存储 | -20.3% | 13.4% | 24.5% | 19.0% | 32.3% |
这里没有一个数字读起来像是"周期已经结束"。11家公司中有9家的营收增长仍是两位数,而两家网络公司——ANET(27.2%)和CIEN(9.5%)——在同一层级内处于这个区间的两端,这本身就很有信息量:互连需求并没有均等地拉动每一家网络公司。英伟达100%的数字,与其自身算力层同行相比,高出了一个数量级——这提醒我们,"AI算力需求"和"英伟达的营收增长"并不是同一个变量,尽管头条新闻常常将两者混为一谈。
利润率图景是这个篮子明显分裂为两种截然不同业务的地方。算力和网络类公司(NVDA、AVGO、ANET)的FCF利润率在42%至48%区间——尽管是硬件公司,却呈现出类似软件公司的现金转化能力,很大程度上是因为实际制造环节被外包了。电力和散热类公司(VRT、ETN、MOD、GEV)的FCF利润率在2%至19%之间——本质上是资本密集、利润率较低的业务,更接近传统工业企业,而非芯片设计公司。WDC是整个篮子中唯一营收负增长的公司(-20.3%),这反映的是NAND/HDD价格的周期性低谷,与AI特定需求无关——这提醒我们,"存储"这一类别同时暴露在不止一个需求周期之下。
第3部分——有多少增长已经反映在价格中
这一部分间接地、以DUEL自己的方式,真正触及了"周期阶段"这个问题。DUEL的DCF引擎仅依据每家公司自身的公开文件,构建公允价值和3年价格预测:不以市场价格作为输入,不使用分析师增长预测,只使用营收CAGR、FCF、ROIC和Sloan比率,通过固定公式处理(完整方法论见我们此前关于[DCF置信区间]的文章)。由此得出的3年建模上涨空间并非目标价——它衡量的是,按照模型固定规则向前推演,一家公司自身历史轨迹中有多少已经反映在模型自身的公允价值估计中,相对于数学计算所显示的剩余空间。
| 代码 | 公允价值(T0) | 建模+3年价格 | 建模3年上涨空间 |
|---|---|---|---|
| WDC | $30.68 | $39.14 | 27.6% |
| AMD | $67.72 | $83.98 | 24.0% |
| GEV | $57.82 | $69.81 | 20.7% |
| GOOGL | $106.91 | $128.91 | 20.6% |
| CIEN | $88.73 | $105.80 | 19.2% |
| AMZN | $254.94 | $302.36 | 18.6% |
| MSFT | $200.09 | $237.23 | 18.6% |
| MOD | $41.28 | $48.82 | 18.3% |
| ANET | $105.29 | $123.88 | 17.6% |
| ETN | $184.92 | $216.43 | 17.0% |
| META | $524.18 | $609.31 | 16.2% |
| NVDA | $176.47 | $202.24 | 14.6% |
| AVGO | $205.67 | $233.87 | 13.7% |
| MU | $38.29 | $43.06 | 12.5% |
| VRT | $203.50 | $226.82 | 11.5% |
英伟达——整个篮子中增长最快、ROIC最高的公司,且遥遥领先——在建模上涨空间方面却排在15家中的第12位。这不是模型的巧合;这是一个直接的算术后果:相对于其自身预测的现金流,英伟达自身的企业价值已经足够大,以至于将固定的3年增长路径向前推演所产生的百分比变动,比在更小基数上做同样的推演要小。这与我们这个系列第一篇文章在8月初的单一NVDA对AMD对决中发现的模式完全相同;将其应用到11家公司组成的基础设施篮子,而不是单一一对比较,说明这并非那个特定比较所独有的假象。
有两点值得明确指出的有效性说明。第一,无论MU是与AMD比较还是与WDC比较,其公允价值(38.29美元)、3年价格(43.06美元)以及背后的每一个输入值都完全相同——这直接、在实际使用中证实了DUEL按公司计算的DCF输出不依赖于对手是谁,这正是模型被设计要表现出的行为。第二,GEV的建模上涨空间(20.7%)在此表中接近顶部,但在孤立地得出任何结论之前,应结合下面的第4部分一起阅读。
第4部分——谁真正拥有资产负债表的护甲
| 代码 | FRI评分 | 等级 | 增长 vs FCF | ROIC vs Sloan | 债务 vs 现金 |
|---|---|---|---|---|---|
| AMD | 100 | 高 | OK | OK | OK |
| ANET | 97 | 高 | OK | OK | OK |
| VRT | 94 | 高 | OK | OK | OK |
| CIEN | 90 | 高 | OK | OK | OK |
| MU | 76 | 高 | OK | OK | OK |
| AVGO | 75 | 高 | OK | OK | 谨慎 |
| WDC | 69 | 中等 | OK | OK | OK |
| ETN | 68 | 中等 | OK | OK | 风险 |
| NVDA | 64 | 中等 | OK | OK | OK |
| MOD | 31 | 低 | OK | OK | OK |
| GEV | 11 | 低 | OK | OK | OK |
正是在这里,"受益者"的叙事变得比单一的增长图表所暗示的更复杂。四家电力与散热类公司中有两家——MOD(31)和GEV(11)——落入了DUEL的低韧性等级,这是模型专门留给那些资产负债表缓冲相对于现金流需求显得单薄的公司的类别,无论其背后的增长叙事有多强劲。GEV尤其应该得到的是数据质量方面的提示,而非定论:其几项原始资产负债表数据(现金、总债务、营业收入、股东权益)在所提取的申报期内不可获取,最可能的原因是GE Vernova自2024年从GE分拆以来,SEC申报历史仍然较短。它的低等级应被视为暂时性的,直到分拆后有更完整的申报文件积累起来——申报历史较短的公司,无论其真实财务状况如何,在模型尚无法看到的组成部分上,机械地会显得更单薄。
ETN是一个更清晰的案例:其债务对现金一致性检查触发了真正的风险标记——债务权益比超过1.0倍,而现金几乎无法覆盖任何总债务——这是一个成熟工业企业资产负债表上直接的杠杆信号,而非会计质量问题。AVGO唯一的谨慎标记,是同一个故事在更小规模上的体现。
与此同时,篮子中韧性得分最高的并非增长最快或上涨空间最小的公司,而是AMD、ANET和VRT——这三家公司的增长概况和利润率结构存在明显差异,唯一的共同点是在DUEL三项内部一致性检查中,资产负债表都干净、没有矛盾。
第5部分——记分卡:上涨空间 vs 韧性
将第3部分和第4部分放在同一页面上——一个轴是建模3年上涨空间,另一个轴是韧性等级——基础设施公司被划分为四组,这是上面任何单一表格都无法单独呈现的。每个轴上的分界点是仅基于11家供给侧公司计算出的中位数(上涨空间17.65%,FRI 75);四家超大规模买家被有意排除在这一计算之外,并在第6部分单独展示,这样它们规模大得多、多元化程度高得多的资产负债表就不会悄悄拉偏供应商的中位数。
定价具有吸引力且结构稳健(上涨空间高于中位数,韧性高于中位数):AMD、ANET、CIEN
建模上涨空间较大,缓冲较薄(上涨空间高于中位数,韧性低于中位数):WDC、GEV、MOD
已充分定价,但极为稳健(上涨空间低于中位数,韧性高于中位数):AVGO、MU、VRT
已充分定价,缓冲相对较薄(上涨空间低于中位数,韧性低于中位数):NVDA、ETN
只有两家公司落入这个最不利的最后一个象限——英伟达是其中之一,与之并列的是ETN,这家成熟的工业企业在第4部分同样被这项分析标记为真正的杠杆风险。这正是本文真正令人意外之处:每一条头条新闻都将其视为显而易见的"AI赢家"的这个名字,恰恰落在了这个篮子自身数学所关联的、剩余建模空间最少且韧性缓冲最薄的象限里——这并非因为其业务出了什么问题,而是因为它的增长和企业价值都已经走得足够远,以至于模型自身的算术,在两个轴上,相较于它所处链条中心的另外十家供应商中的九家,剩下的可推演距离都更短。
第6部分——对照组:买家的表现如何
| 代码 | 建模3年上涨空间 | FRI评分 | 等级 |
|---|---|---|---|
| GOOGL | 20.6% | 85 | 高 |
| AMZN | 18.6% | 100 | 高 |
| MSFT | 18.6% | 81 | 高 |
| META | 16.2% | 83 | 高 |
四家超大规模买家全部落入DUEL的高韧性等级,这与韧性得分在11到100之间波动的供应商们截然不同。这在意料之中——它们是整个市场上规模最大、最多元化的现金生成企业之一,将AI基础设施作为众多支出项目中的一项来购买,而不是像纯粹的供应商那样依赖它。而不那么意料之中的是:它们的建模上涨空间(16.2%~20.6%)恰好落在与供应商篮子相同的区间内——并没有明显更高或更低。在这笔交易中作为买家,并不会在结构上产生与作为供应商不同的估值数学特征——至少这份快照未能检测到这样的差异。
第7部分——这究竟回答了什么,又没有回答什么
要精确说明这项分析的局限性,因为在这里过度声称会破坏整个工作的意义:本文并不能、也无法告诉你AI基础设施支出是否还有更多空间可走、是否正在趋于平台期、或是否已经见顶。这是一个关于未来的问题,而上面的每一个数字都只描述过去和现在。
数据本身所展示的是:这个篮子中的历史增长率依然高企,依然分散——这里没有任何迹象表明一个板块的增长已经同步并趋平,而那通常才是基本面(而非头条新闻)中"后期且趋于成熟"周期的样子。数据还表明,在一个仿佛对所有参与者都同等适用的增长故事之下,韧性其实极不均衡;而且DUEL自身不使用市场价格的DCF数学,已经给这个领域被讨论最多的这个名字分配了比周围大多数供应链公司都更少的剩余建模空间——这是关于这家特定公司今天所处起点的陈述,而不是对明天的预测。
局限性
TSM被完全排除,原因是结构性的,而非数据质量问题:作为外国私人发行人,该公司提交的是20-F而非10-K,这使它超出了DUEL这条完全基于SEC EDGAR的流水线所设计能够读取的范围,无论它在算力层面的实际重要性如何。
这是一张快照,而非实时排名。 支撑本文的每一场对决都生成于2026年7月26日至8月13日之间;上面的具体数字会随着每一次新的季度申报而变动,但它们所依据的比较方法本身不会改变。
刻意不使用市场价格——这一点是双向的。 DUEL的DCF引擎刻意忽略当前股价和分析师预测,这正是让"一家公司自身的轨迹已经假定了多少增长"成为一个干净、可核实的问题的关键所在。这也意味着,这里的"建模上涨空间"并非市场隐含的预期,不应被这样解读。
篮子的构建是一种判断取舍,而非全面普查。 11个基础设施公司加4个买家是对AI价值链一个合理的横截面,而非详尽无遗的样本;换一个同样合理的篮子,可能会改变哪些公司落入记分卡的哪个象限。
GEV的韧性得分应结合数据完整性方面的提示来阅读,该提示已在第4部分直接标出——鉴于该公司自2024年分拆以来申报历史较短,若干原始资产负债表输入数据不可获取,其低等级可能部分反映的是这一空白,而非其财务状况已被完全厘清的全貌。
十五家公司只是一份诊断性快照,而非统计学样本——请将上述模式解读为描述性的,而非可推广到这个特定篮子之外的证据。
结论
在11家AI基础设施供应商及其四家最大买家中,增长依然普遍强劲,依然分布不均——这不是一个已经趋于平台期的板块的图景。而韧性则完全不跟随增长的叙事:一些被炒作最多的增长股,在这个篮子中携带着最薄的资产负债表缓冲,而一些被讨论最少的股票,携带的却是最稳健的缓冲。而最直接回答"已经有多少反映在价格中"这个问题的那一个数字——DUEL自身、不依赖对手、不使用市场价格的建模上涨空间——目前给予的剩余空间最少的,恰恰是大多数人会称之为整个周期显而易见中心的那个名字。这些都不是预测。这只是这些申报文件已经说出的内容,通过对屋子里每一家公司都相同的公式处理得出。
本文中的每一个数字,都可以追溯到你自己在duelstocks.com上拉取并重新核实的一场对决。
延伸阅读——同一系列,同一方法
本文直接建立在本系列此前六篇深度分析所确立的方法论之上,您可以在本站下方找到这些文章。
参考文献
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset(第3版). Wiley.
美国证券交易委员会——外国私人发行人报告要求(20-F表格与10-K表格对比),sec.gov。
DuelStocks方法论深度分析。本文不构成投资建议。所有数据均来自公开的SEC EDGAR申报文件。
驱动大多数财务韧性扣分的,是资产负债表上的杠杆,而不是盈余质量。
问题
DUEL的韧性报告(STR)针对每家公司检验三组内部一致性关系:营收增长是否真正转化为自由现金流(增长 vs FCF);在核查应计项目质量之后,强劲的ROIC是否依然站得住脚(ROIC vs Sloan);以及资产负债表上的债务负担是否真的与现金缓冲相匹配(债务 vs 现金)。任何一组关系不通过,都会触发评分扣减和一条被标记的说明。
甲骨文(ORCL)的ROIC对Sloan警示——84%这一亮眼的ROIC数字,紧挨着一个暗示可能存在盈余虚增的Sloan比率——足够引人注目,让我们围绕它撰写了一整篇报道。但一个戏剧性的案例引出了一个显而易见的问题:这是公司未通过该模型一致性检验的常见方式吗?还是说,这只是一个罕见的例外,仅因为恰好是我们报道过的案例,才被包装成了"常态"?
研究问题:在真实的公司横截面样本中,三种一致性矩阵冲突各自的基础发生率是多少,实际上又是哪一种驱动了大多数韧性扣分?
这与我们此前关于指标冗余的PCA文章,是完全不同性质的统计问题。那项研究探讨的是连续型指标之间如何相互关联。而这项研究探讨的是一个二元的"通过/不通过"阈值被触发的频率——这是一个基础率估计问题,需要一套完全不同的工具。
文献综述
Sloan(1996年)是ROIC对Sloan为何首先应该被视为早期预警信号的理论基础:相对于现金流而言应计项目较高的公司,往往会出现盈余质量——最终是回报——令人失望的情况。但基础率问题属于另一类相关但不同的文献:在一般、未经筛选的上市公司群体中,盈余质量的危险信号有多常见?Beneish(1999年)在构建最初的M-Score时,采用了一个刻意不平衡的样本——50家已知的盈余操纵公司与1,708家非操纵公司相匹配——正是因为真正的操纵者在现实中很罕见;他的设计必须对这些操纵者进行过采样,才能获得足够的正例来建模。Dechow、Ge、Larson和Sloan(2011年)通过研究长达23年的SEC对会计错报的执法行动,从真实的总体数据中得出了同样的结论:重大错报是一种低基础率事件,而不是靠碰运气。在开始研究之前,我们对ROIC对Sloan这一冲突的先验预期就应该是"罕见"——问题在于DUEL的数据是否支持这一点,以及另外两种冲突类型是否同样罕见。
至于估计比率本身的统计方法:Cochran(1977年)给出了在给定目标误差范围下估计比例的标准样本量公式。但一旦比率被估计出来,尤其是在接近边界值(非常低或非常高)时,常规的正态近似("Wald")置信区间表现不佳——它甚至可能产生毫无意义的负数下限。Wilson(1927年)提出了一种基于得分的区间,在极端比例下依然表现良好,Newcombe(1998年)也证实,对于像本文直接讨论的那种小样本或罕见事件比例而言,这是更可靠的选择。因此,下文所有的置信区间均采用Wilson方法计算。
数据与方法
样本组: 与我们此前那篇PCA文章使用的同一批60家公司(30场对决),只是这次提取的是每家公司的STR韧性报告,而非其对决报告(Battle Report)——底层总体相同,报告的产物不同,这使得两项研究能够在同一个一致的样本组上并列进行对比。
变量: 对每家公司,记录其报告中的三项一致性矩阵结果(正常/警示/风险),以及总体FRI得分、韧性等级(高/中/低)、基础得分和扣分。
方法: 基础率 = 非"正常"结果的数量 ÷ 60,分别针对三项检验中的每一项,计算(a)任何非"正常"标记("警示"或"风险"合并计算)和(b)专门针对"风险"的比率。95%置信区间采用Wilson得分法计算。明确应用Cochran(1977年)关于最小预期单元格数(获得稳定比率估计所需的事件数≥5)的准则,以标记在当前样本量下三个比率中哪些是可信的,哪些尚不可信。
结果
每种冲突类型的基础发生率
| 检验项目 | 非正常(警示+风险) | 比率 | 95% Wilson置信区间 | 仅风险 | 比率 |
|---|---|---|---|---|---|
| 增长 vs FCF | 2 / 60 | 3.3% | [0.9%, 11.4%] | 0 / 60 | 0.0% |
| ROIC vs Sloan | 2 / 60 | 3.3% | [0.9%, 11.4%] | 1 / 60 | 1.7% |
| 债务 vs 现金 | 26 / 60 | 43.3% | [31.6%, 55.9%] | 19 / 60 | 31.7% |
这不是一个细微的差异。债务对现金这一项被触发的频率,大约是另外两项检验的十三倍。增长对FCF和ROIC对Sloan——正是激发了这整条研究思路的那种冲突类型——恰好落在完全相同的比率上,都是3.3%,并列成为整个矩阵中最罕见的结果。
有多少公司同时携带多个警示
| 同时出现的冲突数 | 公司数量 | 占比 |
|---|---|---|
| 0(干净) | 33 | 55.0% |
| 1 | 24 | 40.0% |
| 2 | 3 | 5.0% |
| 3(全部检验均未通过) | 0 | 0.0% |
该样本组中55%的公司干净地通过了全部三项检验。样本中没有任何一家公司同时未通过全部三项——理论上最糟糕的情形从未出现过。在携带至少一个警示的27家公司(占45.0%,95%置信区间[33.1%, 57.5%])中,绝大多数(27家中的24家)恰好只携带一个警示,而且几乎总是同一个。
"债务 vs 现金"实际标记的是什么
在这个样本组中,每一条"风险"级别的债务对现金说明都遵循相同的模式:负债权益比远高于1倍,同时现金只能覆盖总负债的一小部分(例如,家得宝(HD):负债权益比3.3,现金仅覆盖债务的0.0倍;卡特彼勒(CAT):负债权益比1.9,现金仅覆盖债务的0.1倍)。这是一个杠杆信号——资产负债表上有多少债务,相对于用于偿付它的可用现金缓冲而言——而不是一个会计质量信号。一家成熟、资本密集型的企业背负相当程度的杠杆,在机制上要比其盈余表现出严重的应计项目操纵普遍得多,而这份数据中13倍的发生频率差距,与这一基本区分是一致的。
并非每一家韧性偏低的公司都存在矛盾
该样本组中有七家公司落入"低"韧性等级。其中只有三家(STX、与HD情况类似的公司、存在债务对现金"风险"警示的SHW/KO、以及同时出现两个警示的STX)是通过一致性矩阵扣分才落到这一等级的。另外四家——INTC、OXY、SNDK,以及另外一家——则是凭借较弱的基础得分和零冲突,达到了"低"韧性:每一项单独的构成指标(现金对债务覆盖率、投资自给率、盈余质量、流动性支撑期)都仅仅是各自表现不佳,没有任何一项与其他项相矛盾。这与甲骨文的情况在实质上是不同的情形:"全面持续偏弱"和"内部相互矛盾"是两种不同的失败模式,而这个样本组显示两种情况都存在,其中由矛盾驱动的失败是两者中较不常见的一种。
讨论
这一发现颠覆了推动整个项目的直觉。甲骨文式的警示——一个看起来引人注目的指标,紧挨着一个盈余质量危险信号——确实很罕见,其发生率与另一项"质量"检验(增长对FCF)完全相同,都是3.3%。同样并非巧合的是,它也是叙事上最有趣的一类警示,这正是它最初足以撑起一段引人入胜的视频报道的原因。但在大型、知名上市公司的广泛横截面样本中,实际上驱动几乎所有韧性扣分的冲突,恰恰是最不具戏剧性的那一种:普通的资产负债表杠杆。Beneish(1999年)为获得可用数据集而对操纵者进行的过采样,以及Dechow等人(2011年)在总体层面证实错报确实罕见,二者都与我们的数据指向同一个方向:戏剧性的会计质量故事是尾部事件,而不是常态——而一个为捕捉它而构建的模型,理应预期自己很少会标记出它,而这正是这里所发生的情况。
对DuelStocks的实际启示
这可能会改变韧性报告自身警示信号的讨论方式,而且这是一个真正的内容机会,而不仅仅是研究上的一条脚注:
- 重新构建营销角度。 甲骨文式的"隐藏盈余虚增"故事是一个很好的切入点,但它是例外,不是模型主要捕捉到的东西。更诚实、也可以说更有用的定位是:"我们的模型主要捕捉的是普通的杠杆风险——大约每检查10家公司就有4家会出现这种情况——而不仅仅是罕见的会计质量戏码。"相比暗示每一个警示都是甲骨文级别的故事,这是一个更有力的信任信号,而且它由这份数据支撑,而不是仅由一个案例支撑。
- 在STR报告本身加入一条校准说明——类似"债务对现金警示出现在我们分析的约43%的公司中;ROIC对Sloan警示出现在约3%的公司中"——将让读者立刻判断某个特定警示是常见的还是真正不寻常的,而不必把每一条"警示"/"风险"说明都读作同等程度的警报。这是一个值得考虑的产品建议,而不是基于一次试点研究就要做出的改动。
- 一个自然而然的下一个短视频选题:"大多数韧性扣分的真正原因(提示:不是财务造假)"——43%的债务对现金统计数据,是一个有力、诚实、非标题党的切入点,可以直接用真实数字来支撑,而不像那种泛泛而谈的"当心危险信号"视频。
局限性
三个比率中有两个尚未得到可靠的估计。增长对FCF和ROIC对Sloan在60家公司中各自只观察到2起事件——低于Cochran(1977年)关于获得稳定比率估计所需最少5起事件的经验法则。它们的Wilson区间(均为[0.9%, 11.4%])相对于其点估计值而言相当宽,这两项指标各自真实的总体比率,完全可能是我们在此观察到数值的两倍或一半。相比之下,拥有26起事件的债务对现金估计值,则建立在更为稳固的基础之上。
这是横截面研究,只是某一时刻的一张快照。这些基础率一年后是否依然成立,或者在另一组不同的60家公司中是否依然成立,尚未经过检验。
行业构成很重要,但本研究并未对此加以控制。这个样本组偏向于大型、成熟的上市公司;如果样本组更多地偏向规模较小或新上市的公司,可能会呈现出完全不同的杠杆/应计项目组合。
刻意使用了与PCA那篇文章相同的样本组——这使得两项研究可以放在一起阅读,但同时也意味着,两项研究都不是对彼此总体的完全独立复现。
以上这些都不会改变DUEL产品中实际的评分或扣分逻辑。这是一项关于每种警示在现实世界中触发频率的基础率发现,而不是一项要求修改底层阈值的提议。
总结
在DUEL韧性模型的三项一致性检验中,有一项——债务对现金——在大约每检查10家公司中的4家身上触发。另外两项,包括恰好是激发这项研究的那种警示类型(ROIC对Sloan),各自大约每30家公司中触发1次。戏剧性的故事是罕见的那一个。常见的是普通的杠杆——从其自身的角度来看,这恰恰是一项韧性检验应当能够可靠捕捉到的、更有用的东西。
一如既往:每场对决完整的韧性报告,连同这些警示背后的每一个原始数字,都可以在duelstocks上查阅。
参考文献
Beneish, M. D. (1999). The detection of earnings manipulation. Financial Analysts Journal, 55(5), 24–36.
Cochran, W. G. (1977). Sampling Techniques(第3版). Wiley.
Dechow, P. M., Ge, W., Larson, C. R., & Sloan, R. G. (2011). Predicting material accounting misstatements. Contemporary Accounting Research, 28(1), 17–82.
Newcombe, R. G. (1998). Two-sided confidence intervals for the single proportion: comparison of seven methods. Statistics in Medicine, 17(8), 857–872.
Sloan, R. G. (1996). Do stock prices fully reflect information in accruals and cash flows about future earnings? The Accounting Review, 71(3), 289–315.
Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212.
DuelStocks方法论深度解析。不构成投资建议。所有数据均来自公开的SEC EDGAR备案文件。
新研究表明,一个8因子股票模型最终归结为四种信号:现金转换、资本效率、应计质量和增长。
问题
DUEL根据八项基本面指标为每场对决评分,每项都有固定权重:营收增长率(16%)、经营现金利润率(15%)、ROIC(15%)、Sloan比率(12%,反向指标)、资产周转率(10%)、应收账款周转率(8%)、营业利润率(12%)以及自由现金流利润率(12%)。这种"赢家全拿"的设计,隐含地将每项指标视为一条独立的证据。
财务比率很少能配合这种假设。Pinches、Mingo和Caruthers(1973年)首次利用因子分析证明,一大批财务比率会收缩为少数几个潜在维度——而不是保持最初的比率数量。Chen和Shimerda(1981年)用一个清晰的例子将这一点进一步阐明:净资产/负债、负债/净资产、净资产/资产、负债/资产看起来是四个比率,但它们之间实际上只承载着一条信息。如果DUEL八项指标中有两项在不同公司之间同步变化,那么名义上24%到27%的合计权重,实际上可能只投了一票,而不是两票。
研究问题:DUEL的八项指标中,实际编码了多少个统计上独立的信号,它们又是如何分组的?
数据与方法
样本组: 本周期新进行的30场对决,均未与此前的报道重复——涵盖科技、医疗健康、工业、必需消费品、零售、能源、电信、半导体、材料以及旅游休闲行业的60家公司。这里的行业多样性是一个特点,而不是噪音:它检验的是相关性结构是否能在截然不同的商业模式之间保持一致,而不仅仅是在单一行业内部。
变量: 每家公司八项指标的原始数值,直接取自每份对决报告(Battle Report)的计算明细(而不是胜负结果)。
缺失数据: OXY和COP缺少ROIC和营业利润率数据(特定行业的报表项目缺口),NFLX和PEP缺少应收账款周转率数据。皮尔逊(Pearson)和斯皮尔曼(Spearman)相关性计算采用成对完整观测值(标准做法);主成分分析(PCA)则使用在全部八项指标上都拥有完整记录的56家公司。
相关性: 皮尔逊(线性)和斯皮尔曼(基于排序)相关系数均已计算。斯皮尔曼在这里很重要,因为若干指标——Sloan比率、自由现金流利润率,以及个别情况下的ROIC——存在异常值和偏度(福特(F)ROIC为-34%的那一年,奥驰亚(MO)82倍的应收账款周转率),单靠皮尔逊系数可能被少数极端值扭曲。
PCA: 采用标准化(z分数)输入、基于相关性的主成分分析,先用Kaiser准则(特征值大于1)作初步筛选,再用累计解释方差作第二重筛选,并对达到80%方差所需的成分进行方差最大化旋转(varimax,Kaiser,1958年),以获得更易解读的载荷结构。
样本量,坦白说: 56到60个观测值仍未达到教科书式的舒适水平,但相比本分析第一轮(46到50个)已有明显提升。Comrey和Lee(1992年)将因子分析工作的N=50评为"非常差",N=100评为"较差";Nunnally(1978年)提出的每变量10个观测值的规则将需要80个观测值。对我们有利的一点是:Guadagnoli和Velicer(1988年)发现,当载荷强且分离清晰时,所需的样本量会大幅下降——正如下面的结果所示,我们的情况大体如此。这是一项探索性的试点研究,与我们此前的Bradley-Terry板块研究同属一个思路——是有待扩展的第一轮尝试,而非确证性结论。(值得提前说明的是,新增这10家公司改变了答案的结构——见下文。这不是方法上的缺陷;这恰恰是小样本试点应该揭示出的那种不稳定性。)
结果
相关性结构
60家公司样本组中最强的两两关系(皮尔逊 / 斯皮尔曼):
| 配对 | 皮尔逊 r | 斯皮尔曼 ρ |
|---|---|---|
| 经营现金利润率 ↔ 营业利润率 | 0.76 | 0.75 |
| 经营现金利润率 ↔ 自由现金流利润率 | 0.70 | 0.75 |
| 营业利润率 ↔ 自由现金流利润率 | 0.66 | 0.60 |
| 资产周转率 ↔ 应收账款周转率 | 0.56 | 0.56 |
| 经营现金利润率 ↔ 资产周转率 | -0.49 | -0.53 |
| ROIC ↔ 营业利润率 | 0.49 | 0.53 |
| ROIC ↔ 资产周转率 | 0.46 | 0.62 |
| 营收增长率 ↔ 营业利润率 | 0.45 | 0.23 |
| 营收增长率 ↔ 自由现金流利润率 | 0.45 | 0.26 |
DUEL中基于利润率的三项指标——经营现金利润率、营业利润率和自由现金流利润率——彼此的相关系数约为r ≈ 0.66到0.76。这不是命名上的巧合:这三项指标在机制上都是不同的分子(经营现金流、营业利润、经营现金流减去资本支出)除以同一个分母(营收)。营业利润率高的公司往往也会以类似的比例将其转化为现金。另外,资产周转率和应收账款周转率——两者都是"营收除以某项资产负债表科目"的比率——在r ≈ 0.56的水平上同步变化,这正是Chen和Shimerda(1981年)四十年前在另一个数据集中记录过的那种"同分母"聚类现象。相比更小的样本,ROIC现在与利润率群组和周转率群组都表现出更清晰的关系——我们在下文会再谈到这一点。
在两个矩阵中、在两种样本量下都唯独独立于其他指标之外的一项指标是:Sloan比率。它与样本组中其他任何指标的最强相关性仅为-0.30(斯皮尔曼系数,相对应收账款周转率而言)——比上表中几乎所有配对都更弱。Sloan比率衡量的是其他七项指标都没有衡量的东西:会计利润是否是靠异常大的应计项目而非现金产生的。这与"盈利能力如何"或"效率如何"是一个真正不同的问题,而相关性矩阵在50家和60家公司的样本中都反映出这一点。
有多少个成分?(以及答案为何发生变化)
| 主成分 | 特征值 | 解释方差 | 累计 |
|---|---|---|---|
| PC1 | 3.17 | 39.0% | 39.0% |
| PC2 | 2.15 | 26.4% | 65.4% |
| PC3 | 0.91 | 11.1% | 76.6% |
| PC4 | 0.73 | 8.9% | 85.5% |
| PC5–PC8 | 各自<0.5 | — | 100% |
按照Kaiser准则(特征值大于1),仍然只有两个成分具有意义——与第一轮结果一致。但80%累计方差的门槛现在落在四个成分上(三个成分时为76.6%,四个成分时为85.5%),而不是三个。新增10家公司不仅提高了精度——它改变了第三个成分能否跨过门槛的结果。
与悄悄把这一点抹平相比,坦率说明它更有价值。这恰恰是Guadagnoli和Velicer(1988年)以及Comrey和Lee(1992年)针对这种样本规模所警示的那种不稳定性的教科书式例证:小样本下的成分解会随着数据积累而移动,而正好卡在某个门槛上的成分(PC3在46家公司时为80.0%,在56家时为76.6%)是最先发生变动的。我们在下文报告四成分解,是因为它是在更大、更新的样本上真正满足所声明的80%标准的那个解——不是因为它讲述了一个更整齐的故事。
这些成分实际衡量的是什么
对达到80%以上方差所需的四个成分进行方差最大化旋转,基于56家有完整记录的公司:
| 指标 | RC1"现金转换" | RC2"资本效率" | RC3"应计质量" | RC4"增长" |
|---|---|---|---|---|
| 营业利润率 | 0.59 | 0.08 | 0.04 | -0.07 |
| 经营现金利润率 | 0.50 | -0.17 | 0.04 | 0.05 |
| 自由现金流利润率 | 0.43 | -0.12 | -0.22 | 0.17 |
| ROIC | 0.41 | 0.58 | 0.12 | -0.24 |
| 资产周转率 | -0.14 | 0.60 | 0.08 | 0.06 |
| 应收账款周转率 | -0.14 | 0.49 | -0.23 | 0.11 |
| Sloan比率 | -0.02 | -0.03 | 0.93 | 0.05 |
| 营收增长率 | 0.07 | 0.09 | 0.04 | 0.94 |
更大的样本将营收增长率与利润率群组分离,而不是将其并入其中——在50家公司的样本中,营收增长率在利润率因子上的主要载荷为0.42;在60家公司的样本中,它在自身独立的因子上载荷为0.94,而在其他任何地方几乎都为零。事后来看,这在经济上是合理的:一家公司可能在利润率很薄的情况下快速增长(本次更新中许多较新的软件和旅游类公司——嘉年华(CCL)、皇家加勒比(RCL)、Block公司(XYZ)——恰恰就是这种组合),因此增长与利润率质量不必同步变化;而随着样本组中公司数量的增加,数据让这一区分变得清晰,而不是把它模糊成一个因子。
ROIC的图景也更加清晰:它现在同时在现金转换因子(0.41)和资本效率因子(0.58,仍占主导)上有交叉载荷——这提醒我们,ROIC从构造上就是类利润率元素(回报率)和类周转率元素(资本密集度)的混合体,因此一定程度的交叉载荷是预期之中的,而不是数据的伪影。
将其映射到DUEL实际的评分权重上,这八项指标现在归并为四个有效板块,而不是三个:
| 实证因子 | 指标 | 合计名义权重 |
|---|---|---|
| RC1——现金转换 | 经营现金利润率、营业利润率、自由现金流利润率 | 39% |
| RC2——资本效率 | ROIC、资产周转率、应收账款周转率 | 33% |
| RC4——增长 | 营收增长率 | 16% |
| RC3——应计质量 | Sloan比率 | 12% |
39/33/16/12——比小样本中55/33/12的三因子划分明显更均衡,而且这一结果是随着数据增多、在没有对模型做任何调整的情况下自然得出的。
讨论
如果你只把"冗余"当作一种缺陷来看待,这一发现指向的方向很容易被忽略。以下两点同时成立:
第一,模型名义权重中大约72%(39%的现金转换板块加上33%的资本效率板块)依赖的是两个实证信号,而不是六个。当营业利润率、经营现金利润率和自由现金流利润率都倾向于同一家公司时——相关性结构表明这种情况发生的频率会高于纯粹偶然——那家公司获得的并不是三张独立的票,而是一张被计了三遍的强票。这未必会产生一个"错误"的赢家;利润率质量确实比衡量它的任何单一比率更具信息量。但这确实意味着,实际的权重分布表现得更像一个4因子模型(39/33/16/12),而不是评分卡上显示的8因子模型。
第二点,也是值得细细体会的部分:一个普通读者可能会以为是"最冗余附加项"的指标——Sloan比率,大多数人甚至叫不出它的名字——在我们目前测试过的两种样本量下,都是整个模型中统计意义上最不冗余的指标。它与DUEL测量的其他任何指标几乎不共享方差。在我们此前的对决报道中,Sloan比率曾是唯一一项在一家看似强劲的公司中标记出盈余质量风险的指标。这项分析表明,这并非单一案例的偶然:从结构上讲,Sloan比率承担着其他七项指标都无法胜任的一项工作,这正是它与其他指标不相关的原因所在。
一个实用提示:给那些看到"39/33/16/12"就想着"直接改权重"的读者
对这样一个发现,有两种直觉反应值得直接讨论,因为它们都以同样微妙的方式犯了错。
反应一:"如果真实结构是四个因子,那就干脆把模型缩减为四项指标。"这混淆了统计上的重叠与浪费。当三项利润率指标在某家公司上得出一致结论时,这并不意味着三项指标什么新信息都没提供——而是意味着三个独立计算出的数字(分别来自经营现金流、营业利润、经营现金流减资本支出)收敛到了同一个结论。这种收敛更接近于来自不同检测的第二和第三意见,而不是同一个检测被问了三遍。一位要求测量血压、静息心率和做心电图的医生,并不是在浪费两项检测,仅仅因为这三项指标在健康患者身上通常会同步变化——这种一致性本身就具有信息价值,而在极少数三者出现分歧的公司身上,那种分歧恰恰是单一指标模型会完全错过的那类信号。缩减为四项指标,去除的不仅是冗余,还会去掉这种交叉验证。
反应二:"如果Sloan比率最不冗余,那就给它约30%的权重,让各因子大致落在33/33/33。"这是同一个错误听起来更精巧的一个版本。PCA告诉你的是一项指标与其他指标重叠的程度——它并不能说明该指标单独看有多可靠或多有预测力。Sloan比率仅根据一种会计关系计算得出(净利润相对于现金流相对于总资产),它对每份对决报告自身免责声明中提到的季度/年度周期错配问题更为敏感,而且——正如这同一个样本组所显示的(SNDK因一次不寻常的资产出售年份而出现+27.6%的Sloan比率,是整个数据集中最极端的数值)——它可能因一次性会计事件而剧烈波动。仅因为它恰好在统计上与其他一切都不相关,就把它的权重提高到三倍,就意味着把最终得分的三分之一押在模型中噪音最大、最不分散的单一指标上。"独立"和"在高权重下值得信赖"并不是同一种属性,把两者混为一谈,是比本文最初讨论的冗余更大的错误。
这一发现在具体层面真正支持的是:
- duelstocks.com上公布的八项指标及其权重不会有任何改变。每一项指标仍然是一个真实、独立、源自SEC数据的计算结果,完整呈现在每份报告的计算明细中——本文中的任何内容都不表明有任何数字是编造、重复计算或错误的。这是一个关于众多公司统计行为的发现,不是任何单场对决中的缺陷。
- 对"39/33/16/12"的诚实解读是一幅地图,而不是一个判决。它告诉你:如果想有意义地改变一场对决的结果,移动三项现金转换指标中的一项,或三项资本效率指标中的一项,产生的效果会比你预期的更小(因为其"姊妹"指标会拉向同一个结论),而Sloan比率和营收增长率则各自承载着完整、未被稀释的名义权重。
- 真正的下一步检验是稳健性检验,而不是重新加权。这为未来的研究提出了一个开放且可检验的问题:如果真的将三项现金转换指标的合计权重减半,是否会改变以往任何一场对决的胜负?如果答案是"很少改变",那是令人放心的——这意味着这种重叠是相互印证,而不是通过三重计算来操纵分数。如果它改变了若干结果,那也值得了解。无论哪种情况,这都是需要具备本项目目前尚不具备的回测基础设施的后续研究所要回答的问题——而不是仅凭一次探索性的PCA分析就手动调整公式的理由。
局限性
这是一项试点研究,应当被这样看待:
- 样本量。 56到60家公司比我们的第一轮(46到50家)更接近舒适水平,但仍低于Comrey和Lee(1992年)"较差"门槛的100家。成分结构已经在50家到60家公司之间发生过一次变化(三因子变为四因子)——这是它可能随着下一批数据再次变化的直接证据。应将39/33/16/12的划分视为当前的最佳估计,而不是一个已经定论的数字。
- 横截面而非纵向研究。 这只是某一时刻的一张快照。同样的四因子结构在一年之后、在完整的一个市场周期中是否依然成立,仍是一个悬而未决的问题——也可能是这条研究方向自然而然的下一步。
- 混合的报告期。 该样本组中有若干公司在个别指标上混用了季度和年度数据(如每份对决报告中所标注)。我们在此没有应用TTM(滚动十二个月)协调修正;如果这种修正会显著改变个别公司的数值,它也可能在边际上改变相关性结构。这是一个独立的方法论问题,我们可能会在未来的文章中直接讨论。
- 四家指标缺失的公司。 OXY和COP因缺少ROIC/营业利润率数据而被排除在PCA之外,NFLX和PEP被纳入相关性计算但未纳入PCA(缺少应收账款周转率数据)。没有一家公司是因为其结果而被剔除的——只是因为数据缺口。
以上这些都不会改变DUEL产品中实际的评分方式。这是一项方法论发现,不是产品决策——这与我们在本系列每篇文章中努力保持的区分是一致的。
总结
八项指标、一套固定的权重方案,以及——在这个现已扩大到60家公司的试点研究中——其背后四个可以通过实证区分的信号:现金转换、资本效率、应计质量和增长,每一个都表现出与其他信号相互独立的行为。名义上16/15/15/12/10/8/12/12%的划分,在实践中,一旦考虑到这些指标实际衡量的内容而非它们的名称,其实更接近于39/33/16/12%的划分——而且随着样本的增大,这个数字朝着更均衡(而不是更不均衡)的方向移动,且没有任何人碰过公式本身。这是继续收集数据的理由,而不是仅凭一次分析就开始手动调整权重的理由。
一如既往:欢迎在duelstocks.com上亲自核算这些数字——每份对决报告都展示了完整的计算明细,而正是这一点,才让这项分析从一开始就成为可能。
参考文献
Chen, K. H., & Shimerda, T. A. (1981). An empirical analysis of useful financial ratios. Financial Management, 10(1), 51–60.
Comrey, A. L., & Lee, H. B. (1992). A First Course in Factor Analysis(第2版). Erlbaum.
Gombola, M. J., & Ketz, J. E. (1983). A note on cash flow and classification patterns of financial ratios. The Accounting Review, 58(1), 105–114.
Guadagnoli, E., & Velicer, W. F. (1988). Relation of sample size to the stability of component patterns. Psychological Bulletin, 103(2), 265–275.
Jolliffe, I. T. (2002). Principal Component Analysis(第2版). Springer.
Kaiser, H. F. (1958). The varimax criterion for analytic rotation in factor analysis. Psychometrika, 23(3), 187–200.
Nunnally, J. C. (1978). Psychometric Theory(第2版). McGraw-Hill.
Pinches, G. E., Mingo, K. A., & Caruthers, J. K. (1973). The stability of financial patterns in industrial organizations. Journal of Finance, 28(2), 389–396.
Sloan, R. G. (1996). Do stock prices fully reflect information in accruals and cash flows about future earnings? The Accounting Review, 71(3), 289–315.
不构成投资建议。所有数据均来自公开的SEC EDGAR备案文件。
历史说明。 本文介绍的是 DUEL 已经停用的赢家全拿规则:在每项指标上得分更高的一方会拿走该指标的全部权重。DUEL 现在使用软性相对得分,按分差的大小(而不仅仅是正负号)来调整每个因子的权重——参见上方的《新的相对股票得分有多脆弱?》。
方法论深度解析,来自真实对决、从零开始计算并验证的真实数据。不构成投资建议。
本系列第一篇文章提出了一个值得重新审视的问题:我们相对"对决"评分背后的权重——营收增长16%、经营现金利润率15%、ROIC 15%、Sloan比率12%、资产周转率10%、应收账款周转率8%、营业利润率12%、自由现金流利润率12%——是一个合理的专家起点,而不是经过实际回报回测的结果。该工具允许任何用户用自定义权重覆盖这些默认值,这就提出了一个值得在三种不同严谨程度上真正检验的问题:如果一个理性的人选择了不同但同样合理的权重,赢家会有多大变化?
第一层:评分如何运作,以及一个清晰的脆弱度数字
对于八项指标中的每一项,都会比较两家公司,得分更高的一方(对于反向指标Sloan比率则是更低的一方)获得该指标的全部权重——每项指标由赢家全拿,而不是根据差距大小分级评分。最终得分是每家公司所赢得指标对应权重之和。我们通过用原始指标数值重新推导迄今发表的全部8场对决的确切得分来验证这一点——每一场都完全吻合。
这种结构免费提供了一个清晰、不依赖模型的脆弱度衡量方式:将权重Δ从赢家赢得的任意指标转移到输家赢得的任意指标,会使得分差距改变2Δ,因此扭转一场对决所需的最小权重重新分配,就是差距÷2。
| 对决 | 得分 | 差距 | 扭转所需的权重点数 |
|---|---|---|---|
| NVDA vs AMD | 92:8 | 84 | 42.0 |
| GOOGL vs META | 10:90 | 80 | 40.0 |
| AMZN vs WMT | 55:45 | 10 | 5.0 |
| CRM vs NOW | 32:68 | 36 | 18.0 |
| VRTX vs REGN | 61:39 | 22 | 11.0 |
| GFF vs WOR | 73:27 | 46 | 23.0 |
| BHE vs PLAB | 30:70 | 40 | 20.0 |
| KO vs PEP | 75:25 | 50 | 25.0 |
AMZN vs WMT是明显的异常值——比数据集中其他任何一场都脆弱一个数量级。
第二层:蒙特卡洛——随机性是否与代数结果一致?
差距÷2这个数字是精确的,但是静态的——它无法说明,如果权重是从一个现实的范围中随机抽取,而不是被刻意设计出来的,扭转结果发生的可能性有多大。我们为每场对决运行了10,000次模拟,每次独立地在每个默认权重值的±50%范围内抽取一个新权重,然后重新归一化使总和为100%——这是在多准则评分系统中检验敏感性的一种标准扰动方法。
| 对决 | 差距 | 蒙特卡洛扭转率(10,000次抽取) |
|---|---|---|
| NVDA vs AMD | 84 | 0.0% |
| GOOGL vs META | 80 | 0.0% |
| AMZN vs WMT | 10 | 14.8% |
| CRM vs NOW | 36 | 0.0% |
| VRTX vs REGN | 22 | 1.3% |
| GFF vs WOR | 46 | 0.0% |
| BHE vs PLAB | 40 | 0.0% |
| KO vs PEP | 50 | 0.0% |
模拟结果与代数推导完全一致:差距≥36的每场对决,在10,000次随机抽取中一次也没有被扭转。两场差距较小的对决(差距≤22)是唯二会被扭转的对决,且其比率随着差距越接近零而相应变化。这种一致性本身就值得注意——一个纯粹的组合数学捷径(差距÷2),在没有运行一次随机抽取的情况下,就准确预测出了经验模拟的结果。
模拟还揭示了单靠代数无法揭示的另一件事:通常是哪个指标导致了结果的扭转。具体来看AMZN对WMT中赢家发生变化的那14.8%模拟,我们可以问,在那些具体的抽取中,哪个因子恰好占据了最大的权重:
- ROIC在64.6%的扭转案例中是最大的权重
- Sloan比率占12.4%
- 营收增长占9.6%
- 其余所有因素合计不到14%
对于这一对公司,ROIC以很大的优势主导了扭转机制——这为"到底是什么真正决定了这个结果"给出了一个有用且具体的答案,而不仅仅是"扭转的可能性有多大"。
第三层:一项指标的权重是否真的等同于其影响力?(Shapley–Shubik指数与Banzhaf指数)
这里有一个前两层完全没有触及的更微妙的问题:一项指标所标明的权重,是否等同于它对谁获胜的真实影响力?1954年,劳埃德·沙普利(Lloyd Shapley)和马丁·舒比克(Martin Shubik)针对加权投票机构恰恰提出了这个问题(这与后来用于分析欧盟理事会和联合国安理会投票权的数学方法完全相同)——他们证明,名义投票份额与实际决定性权力常常并不是同一个数字。一个投票集团可能持有20%的选票,却几乎没有能力改变任何结果;也可能只持有10%,却持续处于决定性地位,这取决于其余选票如何分布。
我们这种"每项指标由赢家全拿"的结构,从数学上讲,恰恰就是这种加权投票博弈:八名"投票者"(各项指标),每人拥有固定的权重,通过简单多数(>50%)来决定哪一方获胜。因此,我们在默认权重下为每项指标计算了Shapley–Shubik指数(并作为交叉验证,计算了相关的Banzhaf指数)——在这八项指标可能被分配给两方的全部2⁸ = 256种可能方式中,评估每项指标有多大频率成为使结果倾斜的那一票。
| 指标 | 标明权重 | Shapley–Shubik权力 | 权力 ÷ 权重 |
|---|---|---|---|
| 营收增长 | 16.0% | 18.2% | 1.14x |
| 经营现金利润率 | 15.0% | 16.1% | 1.07x |
| ROIC | 15.0% | 16.1% | 1.07x |
| Sloan比率 | 12.0% | 11.8% | 0.98x |
| 营业利润率 | 12.0% | 11.8% | 0.98x |
| 自由现金流利润率 | 12.0% | 11.8% | 0.98x |
| 资产周转率 | 10.0% | 8.2% | 0.82x |
| 应收账款周转率 | 8.0% | 6.1% | 0.76x |
这一规律是真实存在的,只是有限而非显著:较大的指标所拥有的决定性权力,系统性地高于其标明权重所暗示的程度,而较小的指标则系统性地更低。应收账款周转率是最明显的案例——它公布的权重(8%)对其在结果中真实影响力的高估程度超过任何其他指标,而当我们在DUEL官方文档记录的另外四种备选权重配置方案(增长型、质量型、价值型、股息与稳定型)下重新运行该计算时,同样的规律(权重最小、被高估最多)依然成立。这不是这个工具特有的缺陷——这是任何"赢家全拿"式加权评分系统的一种结构性特征,早在70年前就在一个完全不同的领域(投票理论)中被首次形式化,并且在这里自然而然地体现出来,没有任何人特意设计过。
针对真实公开的投资者配置方案进行检验
DUEL记录了四种针对不同投资风格命名的权重配置方案。将这四种方案全部应用于我们的8场对决:
| 对决 | 默认 | 增长型 | 质量型 | 价值型 | 股息型 |
|---|---|---|---|---|---|
| NVDA vs AMD | 92:8 | 95:5 | 95:5 | 85:15 | 92:8 |
| GOOGL vs META | 10:90 | 8:92 | 8:92 | 18:82 | 10:90 |
| AMZN vs WMT | 55:45 | 67:33 | 44:56(反转) | 40:60(反转) | 60:40 |
| CRM vs NOW | 32:68 | 37:63 | 17:83 | 32:68 | 40:60 |
| VRTX vs REGN | 61:39 | 64:36 | 56:44 | 65:35 | 56:44 |
| GFF vs WOR | 73:27 | 72:28 | 74:26 | 80:20 | 66:34 |
| BHE vs PLAB | 30:70 | 21:79 | 31:69 | 48:52 | 28:72 |
| KO vs PEP | 75:25 | 72:28 | 84:16 | 72:28 | 71:29 |
只有AMZN vs WMT发生了反转——正是本文其他每一种方法都独立标记为脆弱的那场对决。BHE vs PLAB值得单独一提:在价值型配置下,它从40分的大比分优势收窄到几乎五五开(48:52),但技术上并未真正反转,因为BHE恰好赢得了价值型配置集中赋权的那两项指标——资产周转率和应收账款周转率。
这实际上解决了什么,又没有解决什么
最初的局限在于,基础权重是一种启发式选择,而不是经过回测的选择。本文中的三种方法都没有回答16/15/15/12/10/8/12/12这组权重是否比任何其他替代方案更能预测未来回报——那个校准问题仍然是开放的。我们现在能够用三种相互独立、彼此一致的方法说明的是:基础权重设置在对实际应用有意义的层面上并不脆弱。一个较大的对决得分差距(大约≥30)在我们施加的每一次随机扰动下、以及在每一个真实的、有名称的替代配置方案下都保持稳定。而较小的得分差距,正是三种方法共同收敛到同一个警示的地方——而且,得益于Shapley–Shubik这一层分析,我们现在还知道,无论看哪一场对决,底层评分结构都会系统性地低估像应收账款周转率这样的较小指标的应有权重。这是一个关于机制本身、而非某个具体比较的、真正全新的结构性发现——这种结果只能通过用专门为这个问题而设计的工具去检验模型的根基才能获得,而不是逐个配置方案地去测试权重。
参考文献
Shapley, L. S., & Shubik, M. (1954). "A Method for Evaluating the Distribution of Power in a Committee System." American Political Science Review, 48(3), 787–792.
Banzhaf, J. F. (1965). "Weighted Voting Doesn't Work: A Mathematical Analysis." Rutgers Law Review, 19, 317–343.
Sloan, R. G. (1996). "Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings?" The Accounting Review, 71(3), 289–315.
Saaty, T. L. (1980). The Analytic Hierarchy Process. McGraw-Hill.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset(第3版). Wiley.
如果你想亲自运行这里的任何分析——替换成你自己的权重,或者测试一对我们尚未覆盖的公司——这个在线工具可以在duelstocks.com免费试用;本文中的每一个数字都可以追溯到你能在那里直接获取的报告。
不构成投资建议。所有数据均来自公开的SEC EDGAR备案文件。
方法论深度解析,来自真实对决的真实数据。不构成投资建议。
两篇文章之前,在我们列出的诚实局限中,我们标注了这一点:我们的DCF模型输出的是单一数字——176.47美元,而不是"165–190美元"——完全没有说明这个精确数值应该被信任到什么程度。达摩达兰(Damodaran)几十年来一直指出这一点:仅终值一项,通常就占企业价值的60%到80%,而它建立在一个无法验证的永续增长假设之上。一个精确到分的数字,建立在一个远没有那么精确的基础之上。
本文正是要弥合这一具体差距——在不使用任何模型尚未公开信息的前提下,将单一的公允价值数字转化为一个可以站得住脚的区间。
为什么不用蒙特卡洛
一次完整的模拟需要为每个输入项假设概率分布——而这些形态是我们无法用手头数据诚实地证明合理的。因此,我们转而使用了一种更古老、更简单的方法:三点(PERT)估计法,该方法在1959年为美国海军北极星导弹计划开发,至今仍是项目成本估算中的标准方法。
其逻辑是:根据模型自身已经公开的质量分层,构建一个熊市(Bear)情景和一个牛市(Bull)情景,然后合并计算:
期望值 ≈ (Bear + 4×基准 + Bull) / 6 标准差 ≈ (Bull − Bear) / 6
这种构造方式将(Bear,Bull)区间视为大致±3个标准差,从而在不引入任何一个新输入项的情况下,得到一个可解释的1-sigma区间。对于Bear/Bull情景,我们对模型自身已记录的分层——基于ROIC的增长乘数、FCF利润率乘数,以及决定WACC的基于ROIC的beta分层——各自对称地上下调整一档,且仅使用模型已经披露的阈值。
结果:16家公司,一种方法
| 股票代码 | 公允价值 T0 | 点估计三年上涨潜力 | PERT调整后上涨潜力 | 1σ区间 |
|---|---|---|---|---|
| NVDA | $176.50 | +14.6% | 12.0% ± 2.6% | [9.4%, 14.6%] |
| AMD | $67.77 | +24.0% | 26.1% ± 3.9% | [22.2%, 30.0%] |
| GOOGL | $129.53 | +18.2% | 18.8% ± 5.2% | [13.6%, 24.0%] |
| META | $524.34 | +16.2% | 15.9% ± 4.8% | [11.1%, 20.7%] |
| AMZN | $255.02 | +18.6% | 18.6% ± 4.8% | [13.8%, 23.4%] |
| WMT | $77.87 | +18.7% | 19.1% ± 4.5% | [14.6%, 23.6%] |
| CRM | $416.84 | — | 13.1% ± 4.5% | [8.6%, 17.6%] |
| NOW | $113.89 | — | 18.4% ± 5.4% | [13.0%, 23.8%] |
| VRTX | $257.98 | — | 18.5% ± 4.1% | [14.4%, 22.6%] |
| REGN | $728.55 | — | 22.0% ± 4.4% | [17.6%, 26.4%] |
| GFF | $0.00 | — | — | 见下方说明 |
| WOR | $17.68 | — | 44.1% ± 0.9% | [43.2%, 45.0%] |
| BHE | $26.76 | — | 25.4% ± 1.9% | [23.5%, 27.3%] |
| PLAB | $19.78 | — | 16.0% ± 1.7% | [14.3%, 17.7%] |
| KO | $18.70 | — | 20.4% ± 1.5% | [18.9%, 21.9%] |
| PEP | $117.24 | — | 21.3% ± 0.3% | [21.0%, 21.6%] |
区间的宽度本身就具有信息价值:高增长、高倍数的标的(NVDA、GOOGL、NOW)比缓慢而稳定的现金生成型公司(KO、PEP、PLAB)拥有更宽的区间——这正是一种敏感性分析方法应当呈现的结果,因为一个越面向未来的假设,围绕它产生分歧的空间就越大。
这篇文章真正想回答的问题
本系列的第一篇文章提出了一个引人关注的结论:英伟达在相对基本面"对决"中以92比8击败AMD,但AMD建模得出的DCF上涨潜力(+24.0%)却高于英伟达(+14.6%)——尽管它在经营指标上惨败。一个显而易见的后续问题是:这个差距是真实的,还是仅仅是源于一个从未附带误差范围的点估计所产生的噪音?
应用PERT区间后,英伟达的区间是[9.4%, 14.6%],AMD的区间是[22.2%, 30.0%]。两者没有重叠。原始结论在参数不确定性下经受住了直接检验——我们认为,更多估值类内容应当愿意对自己此前的结论进行这类检验,而不是以超出其应有可信度的信心重复一个点估计。
这一研究系列的一个不动声色的额外收益
在duelstocks.com上开展这一系列文章的一个目的,就是它同时也充当了对我们自身模型的审计——而这篇文章已经为线上工具带来了两项微小但具体的改进。构建敏感性区间要求我们对照真实备案文件手动重新推导DCF公式,这一过程揭示了一个边界情况:对于高杠杆公司,股权价值下限的设定方式(现在以更透明的方式处理,而不再通过占位替代值);以及一个此前未被记录的增长安全上限,现在已直接写入报告自身的方法论部分。我们将该上限的实际边界与分层系统自身的数学上限进行了核对,并未改动数字本身——结果显示它们本就校准良好,几乎恰好落在分层系统自身能够产生的水平上。这两项改动都不会改变本文中的任何数字;两者在此披露是出于完整性考虑,而非因为它们是本文的重点。
产品本身中的"区间"可能是什么样子
目前,要获得这一区间,意味着要针对已发布的DCF报告手动完成分层调整的算术运算——而这正是本文一步步演示的内容,且未使用任何超出您今天可以获取的任何DCF报告中已有内容的东西。一个自然的下一步——并非承诺,只是一个值得点明的方向——可能是DCF报告本身最终直接展示这一区间:在图表中每一年的点预测旁边附上上下限,再加上一张包含上文所示相同Bear/Base/Bull数字的小型补充表格。无论这一功能是否最终推出,这里介绍的方法都完全可以基于您手头已有的报告手动重现。
这实际上解决了原始批评的多少
这里值得精确说明,因为在这一点上夸大其词会违背这次分析的初衷。最初的局限在于,该模型没有提供任何方法来衡量应该在多大程度上信任单一的DCF数字。本文在方法论层面弥合了这一差距:现在存在一种无需新数据、可重复的方法,可以围绕任何DCF输出构建一个站得住脚的区间,并且我们已经证明它能经受住真实的压力测试(NVDA/AMD对比)。但它尚未在产品层面弥合这一差距——报告本身仍然只显示一个数字,构建区间仍然需要读者自己完成这里描述的运算。它也没有解决我们并未声称已经回答的第三个、更棘手的问题:这些区间一旦构建完成,是否真的能以接近所述约68%的比率涵盖实际实现的未来价格——这需要针对长期实际结果进行验证,而本文并未尝试这一点。这是在一个具体且此前未被处理的局限上,取得的部分但诚实的进展。
参考文献
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset(第3版). Wiley.
Malcolm, D. G., Roseboom, J. H., Clark, C. E., & Fazar, W. (1959). "Application of a Technique for Research and Development Program Evaluation (PERT)." Operations Research, 7(5), 646–669.
Howard, R. A. (1988). "Decision Analysis: Practice and Promise." Management Science, 34(6), 679–695.
Sloan, R. G. (1996). "Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings?" The Accounting Review, 71(3), 289–315.
Project Management Institute — PMBOK Guide, Three-Point Estimating Technique.
不构成投资建议。所有数据均来自公开的SEC EDGAR备案文件。披露:本人长期(约5年)持有NVDA仓位;未持有文中提及的其他任何股票仓位。
DuelStocks 试点研究——绝对估值与相对估值,第二部分
1. 第一部分留下的开放问题
本系列第一部分区分了两个常被当作同一个问题来处理的问题:
- 相对估值:与B公司相比,A公司是便宜还是昂贵?
- 绝对估值(DCF):仅凭A公司自身预测的现金流,它本身值多少钱?
在真实对决(NVDA对AMD、GOOGL对META、AMZN对WMT)上同时运用这两种方法,再加上第三个视角——我们独立于价格或增长率、专门评估资产负债表和现金流质量的基本面韧性指数(FRI)——结果显示,按一种方法得出的"赢家"并不能可靠地在另一种方法下依然是赢家。三个不同但都合理的问题;三个不同但都合理的答案。
我们在那篇文章(2.4节)中也坦诚记录了一个局限:一场对决永远只比较两家公司。经典的相对估值是将一家公司与一组同类公司比较,而不是与为标题随意挑选的某个对手比较。面对不同的对手,配对"赢家"的结论可能完全不同。
本文是直接弥合这一差距的尝试——同样重要的是,去衡量这一差距实际被弥合了多少,而不是仅仅断言它被弥合了。
2. 在查看数据之前,我们预期会发现什么
在计算数字之前,我们写下了三个可检验的预期,以便下文的结果可以对照这些预期来检验,而不是事后再去拼凑解释:
- H1——分歧的持续性。 如果第一部分中相对/绝对/韧性三者的分裂是数据的真实属性(而不是选择某一特定配对产生的偶然结果),那么在板块规模上它应该会再次出现:应有若干公司在一个视角下接近榜首,而在另一个视角下接近垫底。
- H2——韧性是正交的。 FRI衡量的是与增长和利润率因子(相对得分)或现金流隐含价值(DCF)在结构上不同的东西(资产负债表质量)。我们预期它的排名与另外两者的相关性较弱,而非较强。
- H3——即使是"有原则"的模型,小样本也充满噪音。 一个2轮的试点每家公司只给出2个数据点。我们预期,无论汇总方法在数学上多么精巧,最终得出的排名顺序都会比看起来的更不稳定,因此我们设计了一种方法来精确量化这种不稳定性,而不是仅用"试点"一词轻描淡写。
三条预期都得到了证实,其中一些方式甚至超出了我们的完全预料(见第6节)。
3. 方法
3.1 赛制设计
在12家公司之间进行一次完整的循环赛(每家对阵所有其他公司)需要66场对决——对一次内容试点而言太多了。我们使用了"圆桌法"(circle method)——体育和心理测量学中安排部分循环赛的标准算法——构建了一个2轮赛程,使得由此产生的"谁对阵谁"图形成一个连接所有12家公司的单一连通环(SWKS从最初13家公司的组合中被剔除——它在指数中的权重最小,剔除它造成的失真也最小)。
第1轮:NVDA–ON、AVGO–MCHP、MU–MPWR、AMD–MRVL、INTC–QCOM、TXN–ADI 第2轮:NVDA–MCHP、ON–MPWR、AVGO–MRVL、MU–QCOM、AMD–ADI、INTC–TXN
这里的连通性不是形式问题,而是关键所在:Bradley–Terry强度估计值会沿着"谁战胜谁"的关系图传播,因此如果该图分裂成两个互不连通的簇,模型就没有任何依据去比较分属不同簇的两家公司。即使大多数配对从未直接交手,一个单一的连通环也是将全部12家公司相互排名所需的最小结构。
3.2 将胜负汇总为排名
从这12场结果中,我们计算了两种相对强度指标:
- Copeland得分——胜场减负场。透明但粗糙:只有2场比赛时,大多数公司会落入三个档次之一(+2、0或−2),产生大量并列。
- Bradley–Terry(BT)评级——配对比较数据的标准模型(1952年提出;是Elo系统的数学前身)。在BT模型下,i战胜j的概率为 s_i / (s_i + s_j),其中s_i是i的估计强度。我们通过迭代最大似然法(MM/Zermelo算法)拟合强度,这使得强度可以传递性地传播:即便两家间接关联的公司之间从未有过直接比较,战胜一支本身战胜过强队的队伍,其价值也大于战胜一支战绩空白的队伍。
在此数据集中,有两个战绩在对BT模型至关重要的数学意义上是"完美"的:一家赢下自己打过的每一场比赛的公司,在未经修正的情况下估计强度为无穷大;一家输掉每一场比赛的公司估计强度为零。两者都会使模型崩溃。我们采用了标准的正则化方法——为每家公司增加少量对阵"联盟平均水平"虚拟对手的虚构比赛——使每个估计值保持有限。这不是表面修饰;它是让如此少的数据也能进行排名的机制,也意味着相邻排名之间确切的数值差距不应被过度解读(详见第6节)。
随后,我们又加入了另外两个排名,它们均来自各公司自身的备案文件,与其对阵的具体对手无关:
- DCF隐含估值倍数——企业价值 ÷ 营收,这是DUEL DCF引擎针对每家公司单独得出的结果(已验证在同一家公司的两份对决报告中完全一致,证实其不依赖于对手)。数值越高,意味着在给定该公司自身的增长、利润率和ROIC输入条件下,模型的现金流引擎为每一美元营收分配的企业价值越多。这不是"相对市场价格的上涨空间"——没有使用任何实时市场价格——而是对模型奖励哪种现金流特征的横截面解读。
- 基本面韧性指数(FRI)——我们的资产负债表质量综合指标,同样是公司特定的。
4. 结果
4.1 循环赛结果
| 对决 | 比分 | 获胜方 |
|---|---|---|
| NVDA 对 ON | 80–20 | NVDA |
| AVGO 对 MCHP | 100–0 | AVGO |
| MU 对 MPWR | 27–73 | MPWR |
| AMD 对 MRVL | 73–27 | AMD |
| INTC 对 QCOM | 12–88 | QCOM |
| TXN 对 ADI | 57–43 | TXN |
| NVDA 对 MCHP | 100–0 | NVDA |
| ON 对 MPWR | 12–88 | MPWR |
| AVGO 对 MRVL | 100–0 | AVGO |
| MU 对 QCOM | 31–69 | QCOM |
| AMD 对 ADI | 34–66 | ADI |
| INTC 对 TXN | 8–92 | TXN |
4.2 四种排名并列展示
| 公司 | 战绩 | Copeland | BT排名 | DCF 企业价值/营收 | DCF排名 | FRI得分 | FRI排名 |
|---|---|---|---|---|---|---|---|
| TXN | 2-0 | +2 | 1 | 1.90x | 9 | 60(中等) | 11 |
| QCOM | 2-0 | +2 | 2 | 3.54x | 5 | 89(高) | 3(并列) |
| MPWR | 2-0 | +2 | 3 | 5.27x | 3 | 98(高) | 2 |
| NVDA | 2-0 | +2 | 4 | 19.84x | 1 | 64(中等) | 10 |
| AVGO | 2-0 | +2 | 5 | 16.06x | 2 | 75(高) | 8 |
| ADI | 1-1 | 0 | 6 | 3.87x | 4 | 87(高) | 6 |
| AMD | 1-1 | 0 | 7 | 3.12x | 7 | 100(高) | 1 |
| INTC | 0-2 | -2 | 8 | 不适用(企业价值为负) | 12 | 32(低) | 12 |
| MU | 0-2 | -2 | 9 | 0.64x | 11 | 76(高) | 7 |
| ON | 0-2 | -2 | 10 | 1.93x | 8 | 88(高) | 5 |
| MCHP | 0-2 | -2 | 11 | 1.71x | 10 | 73(高) | 9 |
| MRVL | 0-2 | -2 | 12 | 3.45x | 6 | 89(高) | 3(并列) |
5. 三个视角分歧之处
TXN两场对决全胜,位居BT排名第1,但在DCF倍数上仅列12家公司中的第9位,韧性排名第11(因杠杆偏高被标记——负债权益比接近0.9,现金对债务覆盖率薄弱)。本次锦标赛中相对估值战绩最好的公司,恰恰属于该组中绝对价值和资产负债表状况较弱的公司之一。
MRVL几乎是它的镜像:BT排名垫底,但韧性排名并列第3(FRI为89),DCF倍数排名居中(第6)。仅凭相对视角几乎无法告诉你任何关于MRVL资产负债表的准确信息。
AMD无论在相对战绩(1-1)还是DCF倍数(第7)上都居中,但拥有该板块中最高的单项韧性得分(FRI为100——没有被标记的矛盾项,每个子指标均满分)。这些信息,仅凭AMD战胜了谁,是完全无法看出的。
NVDA和AVGO是DCF层与相对层结论一致的两个名字(两者均为第1和第2位)——但韧性出现分歧。NVDA在FRI上跌至第10位,原因是其流动性支撑期指标远低于"强缓冲"门槛:这是增长/估值优势与资产负债表缓冲之间真实的权衡取舍,不是噪音。
INTC是对照案例:在每个视角下都排名垫底或接近垫底,也是唯一一家DCF引擎直接给出负企业价值的公司(负自由现金流会使模型直接崩溃,而不仅仅是压低数字)。当潜在情况在各方面都真正疲弱时,三种方法会一致——这本身就具有信息价值:它表明其他地方观察到的分歧,反映的是基本面确实存在混杂信号,而不是模型自身随机产生的不一致。
6. 第1名的位置你该有多信任?
在把"TXN排名第1"当作关于TXN本身的发现之前,值得先精确弄清楚这个数字实际上是由什么驱动的。
TXN的两场胜利分别战胜了INTC(0-2,在整个网络中没有任何胜场)和ADI(1-1——其唯一的资历是一场对阵AMD的胜利)。在Bradley–Terry模型中,战胜一支自身也曾战胜过某队的球队,其价值高于战胜一支战绩空白的球队,因为强度会沿着关系图传递性地传播。NVDA、AVGO、QCOM和MPWR——另外四支2-0的队伍——各自战胜的都是两支在整个网络中毫无胜绩的0-2对手。TXN是唯一一支第二场胜利是战胜了自身也拥有实际胜绩的对手(ADI)的2-0队伍。正是这一个间接联系,将TXN的BT第1名与四方并列榜首区分开来。
这不是方法的缺陷——这恰恰是Bradley–Terry方法被设计出来要做的事。但这也恰恰是那种应该让你对基于每家公司仅2场比赛的排名保持警惕、不要过度解读的结果。为了量化这种谨慎而不仅仅是断言它,我们进行了一次蒙特卡洛检验:模拟12家具有随机"真实"强度的公司,运行相同的圆桌法赛程,并在不同的赛程长度下(每个数据点模拟4,000场锦标赛),询问Bradley–Terry第1名与简单的Copeland第1名仅因抽样波动而产生分歧的频率:
| 每家公司的轮次 | BT与Copeland在第1名上意见不一致 |
|---|---|
| 2(本次试点) | 64.4% |
| 4 | 34.4% |
| 6 | 25.2% |
| 11(完整循环赛) | 4.9% |
在2轮赛制下,你用哪种方法来判断"谁是第1",与更简单的计数方法是否一致,几乎接近于抛硬币——这表明在这个样本规模下,Bradley–Terry的精细程度尚未换来一个稳定的答案,只是换来了一个以不同方式不稳定的答案。这种不稳定性是样本规模的属性,并非TXN本身特有,这正是我们将其呈现为一个有待更多数据重新审视的试点发现,而非已确认的板块领先者结论的原因。
7. 实际需要多少轮才够?
第6节表明,第1名的位置在2轮时是不牢靠的。自然而然的下一个问题——也是本文试图定量而非定性回答的问题——是:需要多少轮才算足够,每增加一步能获得什么?
我们模拟了相同12家公司圆桌法设计的循环赛锦标赛,赛程长度从1轮到完整的11轮循环赛(每家公司与其他每家公司恰好对阵一次),在每一行3,000场模拟锦标赛中为公司随机分配"真实"强度。然后我们衡量了得出的Bradley–Terry排名与(模拟中已知的)真实强度顺序的匹配程度:
| 每家公司的轮次 | 总对决数(12家公司) | 与真实顺序的排名相关性(Spearman) | 前三名识别率 | 战绩"完美"的公司占比 |
|---|---|---|---|---|
| 1 | 6 | 0.32 | 37.0% | 100% |
| 2(本次试点) | 12 | 0.47 | 48.5% | 56.7% |
| 3 | 18 | 0.55 | 51.1% | 34.5% |
| 4 | 24 | 0.60 | 55.9% | 22.8% |
| 5 | 30 | 0.65 | 59.4% | 16.1% |
| 6 | 36 | 0.68 | 60.6% | 11.2% |
| 8 | 48 | 0.74 | 64.2% | 6.4% |
| 11(完整循环赛) | 66 | 0.78 | 66.9% | 3.1% |
有两点值得注意。首先,这里使用的试点设计(2轮)与"真实"顺序的排名相关性约为0.47——足以用来标记大致的层级,但不足以可靠地断言某个具体的第1名。其次,超过一半的参赛公司(56.7%)以数学上"完美"的2-0或0-2战绩结束2轮赛程——这听起来很有说服力,但根据第6节,这恰恰是使个体排名顺序不稳定的条件,因为完美战绩本身不包含一家公司到底强多少的信息,只说明它赢下了自己恰好参加的每一场比赛。
将该表解读为未来同类锦标赛的规划指南:
- 1–2轮: 成本低、速度快,适合在围绕一次试点或单次发布周期构建的内容中标记大致的层级(明显的领先者与明显的落后者)。上层或下层内部的具体排位不应被当作定论。
- 3–4轮: 以中等的额外成本(18–24场对决)显著改善(相关性约0.55–0.60);如果排名本身——而不仅仅是与DCF的分歧故事——才是文章的重点,这是一个合理的最低标准。
- 5–6轮: 在完整的全组严谨性与开展数十场对决的制作成本之间,是一个可行的折中点(相关性约0.65–0.68)。
- 8轮以上,直至完整的66场循环赛: 每增加一轮的边际收益递减,但这是唯一能让你真正自信地为某个具体排名(而不仅仅是某个层级)辩护的规模区间。
8. 这解决了第一部分的批评吗?
从结构上说,答案是"是的,部分解决了":将12场配对对决汇总成一个连通网络,并根据整组隐含的强度而非某个任意对手来给每家公司打分,相较于单一对决而言是一次真正的方法论升级——这正是经典相对估值中"与同类公司群体比较"这一原则,转化为配对比较统计方法后实际所要求的东西。
从经验数据来看,答案更为有限,第7节的表格是对这种局限的诚实呈现。这里使用的具体2轮设计削弱了——但没有消除——最初的批评。一家公司在本次试点排名中的位置,比单一对决的胜者更具信息量,但根据第6节和第7节,它仍然更接近粗略的分层,而非精确、稳定的排名。第一部分的批评(2.4节)现在最好被理解为:"在类型上已经解决,程度上尚未解决"——与同类公司群体比较的方法确实存在并且有效;而将其运用到能让个体排位可信的样本规模,则是上文所展示的一项独立且可量化的成本。
9. 结论
第一部分中相对/绝对/韧性之间的分歧,并非选择某一特定配对所产生的偶然结果。它在板块规模上再次出现:TXN(相对第1,DCF第9,韧性第11)和MRVL(相对第12,DCF第6,韧性第3)在衡量真正不同事物的视角之间,显示出6到8个名次的差距。
正如预期(H2)那样,韧性是三个视角中最独立的一个。AMD在韧性上的第1名与其平平无奇的相对战绩和DCF倍数并存;NVDA和AVGO在相对和DCF上共享的第1/第2位,与它们各自第10和第8的韧性排名并存。在增长和利润率因子或DCF现金流倍数上得分高,几乎不能告诉你任何关于资产负债表缓冲的信息。
唯一没有出现分歧的案例(INTC)也是唯一一个毫无疑义陷入困境的案例——在每个视角下都排名垫底或接近垫底,也是唯一一家DCF引擎输出结果不仅偏低、而且完全退化(企业价值为负)的公司。这证明其他地方观察到的分歧,反映的是真实存在的、混杂的基本面情况,而不是评分方法本身的噪音。
一个2轮的试点在方向上是有用的,但在个体层面是不稳定的,而这一点现在是被测量出来的,而不是被断言的。模拟显示,在这一设计规模下,与"真实"顺序的排名相关性约为0.47;更简单的计数方法(Copeland)仅因抽样波动就可能选出不同第1名的概率为64.4%;而56.7%的参赛公司以信息含量匱乏的"完美"2-0或0-2战绩收官。本次试点中的第1名(TXN)依赖于比较关系图中一个孤立的间接联系(其对阵ADI的胜利,而ADI唯一的资历是一场对阵AMD的胜利)——这正是这种不稳定性的典型例证,并非TXN本身的特殊缺陷。
第一部分提出的"配对对比同类公司群体"批评,在结构上已被回应,但在实践中只被部分消除。将大量对决汇总为群体相对排名的方法确实存在并且有效;根据第7节的表格,要让个体排位(而不仅仅是层级排位)变得可信,大约需要5到8轮(30到48场对决),而不是2轮——这是一个具体、可复用的数字,可用于规划下一次同类锦标赛的规模,而不是含糊地呼吁"需要更多数据"。
本文为方法论介绍,不构成投资建议。所有数据均来自公开的SEC EDGAR备案文件(10-K/10-Q)。
每一次股票估值最终都在回答两个不同问题中的一个,而大多数关于"哪种方法才正确"的争论,往往源于人们没有意识到自己争论的其实是不同的问题。
本文先梳理理论,再用真实数据进行检验——英伟达(NVDA)对阵AMD(AMD)、谷歌(GOOGL)对阵Meta(META)、亚马逊(AMZN)对阵沃尔玛(WMT)——使用的是我自己开发的工具,该工具直接从SEC 10-K/10-Q文件中提取基本面数据。没有分析师预测,没有市场情绪,也没有价格走势——只有官方备案文件。
第一部分——追问"这家公司值多少钱"的两种方式
内在(绝对)估值从内部构建公司的价值——预测未来现金流,用反映风险的折现率折现,仅此而已。这一思路可追溯至约翰·伯尔·威廉姆斯(John Burr Williams)1938年的著作《投资价值理论》:一项资产的价值等于它未来将支付给你的现金流的现值。DCF、股利折现模型和剩余收益模型都属于这一类。
相对估值从不单独评估一家公司——它是相对于同类公司进行评估,假设市场对可比业务的定价大致正确,而你所研究的目标公司与该群体之间的差距就是信号。市盈率、EV/EBITDA等倍数指标以及同类排名系统都属于这一类。
两者都不"更正确"。它们建立在对"你能知道什么"这一问题的不同假设之上。绝对估值假设你能比市场预测得更准。相对估值假设市场平均而言大致正确,你的任务是找出其中的异常值。
DCF的优势所在,以及它失效的地方
DCF是唯一一种从企业真实现金创造能力本身推导价值的方法,与其他人为可比公司支付的价格无关。当整个板块陷入疯狂时(如2000年、2021年),这一点尤为强大。问题在于——阿斯瓦斯·达摩达兰(Aswath Damodaran)对此有充分论述——DCF的结果对三个输入项极度敏感:增长率、折现率和终值。仅终值一项通常就占企业总价值的60%到80%,而它建立在对永续增长率的单一点估计之上。你得到的是一个精确到小数点的数字,但它建立在一个谁也无法验证的假设之上。
倍数估值的优势所在,以及它失效的地方
倍数估值速度快,可以应用于数百家公司,还能纳入电子表格难以轻易捕捉的信息——管理层质量、监管风险、板块情绪。其结构性弱点在于循环性:相对估值只有在同类公司群体平均定价正确时才有效。如果整个板块被高估,相对估值会欣然确认你研究的目标公司"相对同类公司便宜"——即便整个群体相对现实而言都被高估了。
表1——正面对比
| 标准 | 绝对估值(DCF / DDM / RIM) | 相对估值(倍数 / 同类评分) |
|---|---|---|
| 理论基础 | 未来现金流的现值(Williams,1938) | 一价定律,弱式市场有效性 |
| 数据来源 | 公司自身未来业绩的预测 | 可比公司的当前/历史数据 |
| 对市场的依赖 | 与当前价格无关 | 完全依赖——价值是同类公司价格的函数 |
| 关键假设数量 | 高(增长率、WACC、永续增长率) | 低(同类公司选择、权重) |
| 对误差的敏感度 | 非常高——终值主导企业价值 | 中等——分散在整个同类公司群体中 |
| 系统性偏差风险 | 分析师对增长预测的乐观偏差 | 循环性——定价错误的板块会自我确认 |
| 公司特定风险 | 明确(通过WACC、现金流质量体现) | 通常隐含或缺失 |
| 速度 / 可扩展性 | 低——每家公司都需大量人工 | 高——可轻松应用于数十家公司 |
| 对用户的透明度 | 若假设未公开则较低 | 高——"比同类便宜"直观易懂 |
| 对板块泡沫的韧性 | 理论上具有韧性 | 脆弱——会继承整个板块的错误定价 |
| 典型使用者 | 评估师、长期价值投资者 | 卖方分析师、散户筛选工具 |
第二部分——在相同公司上同时检验两种方法
我没有选择单一方法,而是构建了一个工具,在相同的SEC数据上并行运行两种方法,并加入第三层用于衡量资产负债表的韧性。三份独立报告,回答三个独立问题:
- 对决报告(相对)——8项基本面指标(营收增长率、经营现金利润率、ROIC、Sloan比率、资产周转率、应收账款周转率、营业利润率、自由现金流利润率),加权后为双方各计算一个0到100的分数。
- DCF报告(绝对)——完整的三年期DCF模型,采用质量调整增长率:对激进权责发生制会计的Sloan比率惩罚项,根据资本效率调整预测增长率的ROIC乘数,以及衡量现金转换质量的自由现金流利润率乘数。WACC由ROIC分层推导而来,而非基于历史股价波动率。
- 韧性报告——由现金对债务覆盖率、投资自给率(FCF/资本支出)、盈利质量(经营性现金流/营业利润)和流动性支撑期构成的基本面韧性指数(0到100),并配有标记内部矛盾的一致性检验矩阵。
坦率地说明这一方法的局限性:DCF输出没有敏感性表或蒙特卡洛区间(相较于完整点估计模型的一个已知取舍),没有明确的国家风险溢价(对美国大盘股无碍,但对国际股票而言是一个缺口),相对估值层每次只比较一对公司,而非整个同类公司群体的中位数。这些都不会使这些数字变得毫无用处——只是意味着应将其当作方向性证据,而非绝对真理来解读。
第三部分——案例研究:英伟达对阵AMD
相对得分:92比8,"压倒性优势",英伟达占优。
| 指标 | NVDA | AMD | 权重 |
|---|---|---|---|
| 营收增长率(三年CAGR) | 100.05% | 13.64% | 16% |
| 经营现金利润率 | 47.57% | 22.26% | 15% |
| ROIC | 51.01% | 4.46% | 15% |
| 营业利润率 | 60.38% | 10.66% | 12% |
| 自由现金流利润率 | 47.50% | 19.44% | 12% |
| 资产周转率 | 0.83x | 0.43x | 10% |
| 应收账款周转率 | 5.30x | 5.74x | 8% |
51%对4.5%的ROIC差距不是四舍五入的误差。仅从经营基本面来看,这场对决并不接近。
绝对数字讲述了一个不同的故事:
| 参数 | NVDA | AMD |
|---|---|---|
| 企业价值(T0) | $4,285.24B | $108.03B |
| 每股公允价值(T0) | $176.47 | $67.72 |
| WACC(基于ROIC分层) | 8.95% | 11.56% |
| 公允价值,+3年 | $202.24(+14.6%) | $83.98(+24.0%) |
尽管在对决中以8比92落败,AMD建模得出的三年期上涨潜力反而更高。英伟达的主导地位已经反映在约4.3万亿美元的企业价值中;即便按照模型设定的35%增长率上限计算,从一个已经极其庞大的基数出发的百分比涨幅,也小于AMD从一个低得多的基数出发、以更温和速度复合增长所带来的涨幅。相对估值告诉你现在谁在领先。DCF告诉你,你为这场胜利已经付出了多少代价。
韧性层带来了第三个出乎意料的转折:
| 指标 | NVDA | AMD |
|---|---|---|
| 韧性指数(FRI) | 64——中等 | 100——高 |
| 现金对债务覆盖率 | 12.24x | 4.12x |
| 投资自给率(FCF/资本支出) | 739.39x | 6.91x |
| 盈利质量(经营现金流/营业利润) | 0.79x——存在预警 | 2.09x |
| 流动性支撑期 | 0.5年——存在预警 | 无限 |
一家刚以92比8赢得对决、企业价值(DCF推导)高达4.28万亿美元的公司,在韧性得分上却低于它碾压的对手。需要说明一点:以1027亿美元的经营现金流来看,没有人真的认为英伟达存在流动性问题——这里的支撑期指标几乎肯定是该指标在一种它本不是为其设计的资产负债表结构上产生的公式误差。但盈利质量预警(营业利润超过经营现金流)是一个真实、尽管较小、但值得了解的信号。
同一天,又对另外两组配对进行了交叉验证:
| 配对 | 相对对决得分 | 韧性指数(FRI) | DCF上涨潜力(+3年) |
|---|---|---|---|
| NVDA vs AMD | 92 : 8(NVDA) | 64 vs 100——AMD更高 | NVDA +14.6% vs AMD +24.0% |
| GOOGL vs META | 10 : 90(META) | 85 vs 83——基本持平 | GOOGL +18.2% vs META +16.2% |
| AMZN vs WMT | 55 : 45(AMZN) | 100 vs 71——AMZN更高 | AMZN +18.6% vs WMT +18.7%——持平 |
同样的模式,独立验证了三次:一边倒的相对得分,无法可靠地预测韧性排名,也无法预测绝对回报排名。
结论
相对估值回答的是"现在哪家企业在经营层面更强"——它很好地完成了这项任务。绝对估值回答的是"这种优势中有多少已经反映在价格里"。韧性层则回答"如果情况恶化会发生什么"。这是三个不同的问题,而把其中任何一个当作完整答案,正是无论专业投资者还是散户在估值争论中最常出错的地方。
本文为方法论介绍,不构成投资建议。所有数据均来自公开的SEC EDGAR备案文件(10-K/10-Q)。