Qual ação vence?
Insira dois tickers e o DUEL compara com 8 fatores fundamentais baseados em dados da SEC EDGAR, mostrando o vencedor relativo em segundos.
Testar o DUELO que o DUEL faz
Compare duas ações
Compare quaisquer duas empresas públicas dos EUA em segundos.
8 fatores fundamentais
Crescimento de receita, ROIC, margem de caixa e mais, com dados da SEC.
Comparação relativa
Não é uma nota absoluta, mas sim qual ação é mais forte agora.
Gratuito + PRO
5 duelos gratuitos por dia; com PRO, duelos ilimitados e pesos personalizados.
Como usar
Insira dois tickers
Clique em DUEL
Veja o resultado e a análise
Artigos de Metodologia
Conversão em caixa, diagnóstico de alavancagem e trajetórias de alocação de capital – evidências a partir dos documentos apresentados à SEC por pares norte-americanos não financeiros de grande capitalização. Pesquisa metodológica descritiva. Não constitui recomendação de investimento.
Resumo
Uma única pontuação fatorial diz ao investidor quem é mais forte. Ela não diz se essa força é construída da mesma maneira nos dois lados da comparação, nem se o quadro deste ano está se aproximando ou se afastando do quadro do ano passado. Este trabalho propõe uma pergunta mais restrita e de natureza mais diagnóstica: em dez pares de pares não financeiros distribuídos por oito setores GICS, o nível fatorial estático de uma empresa concorda com (a) um indicador de diagnóstico estrutural sobre a sua contabilidade (lucros no papel, patrimônio líquido não positivo, absorção pelo CapEx, ausência de colchão de segurança), (b) a direção ano a ano de seus fatores de margem e de crescimento e (c) o destino do seu caixa efetivo nos três últimos exercícios fiscais? Combinamos oito fatores derivados da SEC, quatro indicadores de diagnóstico binários, deltas anuais do período anterior calculados diretamente a partir de 10-K consecutivos, um mapa de posicionamento setorial construído sobre a mesma família de fatores e um registro de alocação de capital em três anos (dividendos, recompras de ações, M&A, emissões de ações, dívida líquida, caixa) para vinte empresas. Três resultados se destacam. Primeiro, um indicador de lucros no papel não prevê um duelo perdido nem uma piora da história de caixa: os dois casos mais claros deste painel (Coca-Cola, Chevron) venceram ambos a sua comparação par a par e melhoraram ambos, ano a ano, a conversão do caixa operacional; o indicador informa, portanto, sobre a estrutura contábil, não sobre a trajetória nem sobre quem vence. Segundo, o patrimônio líquido contábil não positivo não é uma história, mas duas: McDonald's e Starbucks compartilham o mesmo indicador e um duelo idêntico de 50–50, mas seus deltas do período anterior se movem em direções opostas, e apenas um dos dois pares é de fato distinguível quando a própria razão Debt/Equity não está disponível. Terceiro, o registro de alocação de capital em três anos resolve rotineiramente uma questão que um único instantâneo fatorial deixa em aberto: se uma margem de fluxo de caixa livre divulgada reflete devolução discricionária de capital, reinvestimento ou um colchão estruturalmente fino diante de uma trajetória de queima de caixa. Tratamos isso como diagnóstico descritivo de pares sobre documentos públicos, não como um exercício de previsão de retornos nem de market timing, e declaramos explicitamente esse limite ao longo de todo o texto.
1. Introdução
A comparação relativa par a par de duas empresas sobre os mesmos fatores derivados da SEC, tema de um artigo complementar deste site, resolve um problema específico: ela cancela o ruído setorial e macroeconômico que contamina qualquer razão isolada, de modo que o leitor compara sinal com sinal, e não nível com nível. Um segundo artigo complementar mostrou que os oito fatores por trás dessa comparação não são oito informações independentes; sob análise de componentes principais sobre o conjunto original de oito fatores, eles se reduzem a quatro componentes empiricamente distintos: conversão em caixa, eficiência do capital, crescimento e qualidade dos accruals. O conjunto de fatores em uso substituiu desde então Receivables Turnover (giro de contas a receber) por Debt/Equity, que o produto passou a tratar como um quinto grupo, informado separadamente, ao lado dos mesmos quatro. Utilizamos essa taxonomia atual de cinco grupos (Growth, ou seja, crescimento; Margin Conversion, a conversão da margem em caixa; Capital Efficiency, a eficiência do capital; Accrual Quality, a qualidade dos accruals; e Financial Strength, a solidez financeira) ao longo de todo este trabalho sempre que os fatores são agrupados, inclusive na leitura das lacunas do Relative Price Chart (gráfico de preço relativo) na Seção 6.5. Ambos os artigos respondem a uma pergunta sobre quanto peso cada fator deve ter e sobre como as duas empresas se comparam, neste momento, nesse conjunto de fatores.
Nenhum dos dois responde a uma terceira pergunta, igualmente prática: o quadro é coerente? Uma empresa pode exibir uma margem operacional atraente enquanto sua conversão em caixa fica muito atrás, um padrão que merece ser sinalizado por si só, independentemente do lado do duelo em que ela esteja. Uma empresa pode exibir uma razão Debt/Equity exatamente igual a zero não porque não tenha alavancagem, mas porque o seu próprio patrimônio líquido contábil ficou negativo e a razão não pode ser calculada. A margem de fluxo de caixa livre divulgada por uma empresa neste ano pode ser o produto de uma melhora genuína em relação ao documento do ano passado, ou de uma piora genuína disfarçada por um programa de recompras menor. Nada disso é visível em uma única pontuação transversal. Tudo se torna visível quando quatro elementos são colocados lado a lado para o mesmo par: os níveis fatoriais estáticos, um pequeno conjunto de indicadores de diagnóstico estrutural, a direção ano a ano dos mesmos fatores segundo o 10-K anterior e o destino do caixa efetivo da empresa nos três últimos exercícios fiscais.
A contribuição deste trabalho é formalizar esse diagnóstico em quatro partes (indicadores, deltas do período anterior, geometria do mapa de posicionamento e alocação de capital em três anos) em um único arcabouço descritivo e aplicá-lo a um corte transversal deliberadamente diverso de dez pares de empresas não financeiras, em vez de a um único estudo de caso. Não afirmamos que os diagnósticos resultantes prevejam retornos, nem que constituam uma taxonomia completa de todos os padrões que os documentos de uma empresa podem produzir. Afirmamos que as quatro peças, lidas em conjunto, oferecem a quem lê uma comparação par a par mais do que a soma de suas partes: permitem perguntar não apenas “quem é mais forte”, mas também “a história desta empresa é internamente coerente, e está ficando mais ou menos coerente ao longo do tempo”.
2. Literatura relacionada
A literatura sobre qualidade dos accruals começa com Sloan (1996), que mostrou que o componente de accruals dos lucros é sistematicamente menos persistente do que o componente de caixa e que o mercado reage de forma insuficiente a essa distinção. Dechow, Ge e Schrand (2010) examinam a literatura mais ampla sobre qualidade dos lucros e as muitas medidas aproximadas (accruals, suavização, tempestividade, persistência) que surgiram desse ponto de partida; o nosso indicador de lucros no papel (margem de caixa operacional, Operating Cash Margin ou OCM, abaixo de uma fração fixa da margem operacional, OM) e o nosso fator Sloan Ratio situam-se plenamente nessa tradição, aplicados ao nível de uma única comparação entre pares, e não em uma regressão transversal. Ohlson (1995) e o arcabouço do lucro residual, tal como sintetizado por Penman em Financial Statement Analysis, motivam tratar o patrimônio líquido contábil e o seu sinal como informativos por si mesmos, e não como um denominador que se aceita sem questionar; o nosso indicador de patrimônio líquido não positivo é uma aplicação direta e deliberadamente grosseira dessa ideia: quando o denominador de uma razão de alavancagem se tornou negativo, a razão deixa de ser um sinal de alavancagem e passa a ser um sinal de outro tipo (sobre prejuízos acumulados ou sobre uma intensidade sustentada de recompras) que o leitor deve ver nomeado, e não silenciosamente apagado. Lev e Nissim (2006) revisitam a anomalia dos accruals com dados mais recentes e componentes de accruals mais granulares, reforçando que o conteúdo econômico dos accruals não é uniforme entre os seus subcomponentes, uma cautela que levamos para o nosso próprio indicador de accruals de razão única, que tratamos como uma triagem grosseira, e não como um diagnóstico completo.
No lado da remuneração aos acionistas, Grullon e Michaely (2002, 2004) documentam a substituição de longo prazo dos dividendos por recompras na política de distribuição dos Estados Unidos e suas implicações para a forma como um mercado deveria interpretar um corte ou um aumento de qualquer uma delas; isso motiva a leitura do nosso registro de alocação de capital em três anos como uma identidade contábil completa (fluxo de caixa livre frente a dividendos, recompras, M&A, emissões e dívida líquida), em vez do exame isolado de recompras ou dividendos. A literatura mais ampla sobre restrições financeiras (resumida de diversas formas, por exemplo, em Almeida, Campello e Weisbach sobre o valor da liquidez) fundamenta o nosso tratamento do saldo de caixa de uma empresa que queima caixa, dividido pelo seu ritmo de queima, como um sinal de fôlego de caixa (runway), e não como um sinal de valuation.
Por fim, seguimos expressamente a orientação da literatura sobre XBRL e sobre a divulgação de informações à SEC no que diz respeito às lacunas de cobertura por tag: nem todas as empresas etiquetam todos os conceitos de forma idêntica, sendo “mergers and acquisitions” e “operating income” em particular etiquetados com granularidade sensivelmente diferente entre os emissores, e uma tag ausente é um fato sobre a disponibilidade de dados no envio XBRL de um emissor específico, não uma prova de que a atividade subjacente não ocorreu. Tratamos um traço nas nossas próprias tabelas em conformidade e retomamos expressamente este ponto nas Limitações.
3. Perguntas de pesquisa e hipóteses
RQ1. Em quais configurações a OCM fica abaixo da OM o bastante para acionar um indicador de lucros no papel (OCM abaixo de 0.7 vez a OM), e essa configuração coincide com (a) uma trajetória ano a ano de deterioração da conversão em caixa ou (b) um programa agressivo de recompras sustentado sobre uma base fraca de fluxo de caixa livre?
RQ2. Com que frequência Debt/Equity não está disponível porque o próprio patrimônio líquido contábil não é positivo, e essa indisponibilidade se alinha com um histórico de alocação de capital dominado por recompras acumuladas de ações (a história específica que um indicador de patrimônio líquido não positivo pretende evidenciar), e não com simples ausência de dados?
RQ3. O mapa de posicionamento setorial (Sustainable Growth, ou crescimento sustentável, no eixo x; Quality-Adjusted Cash Margin, ou margem de caixa ajustada pela qualidade, no eixo y; cor do ponto conforme Debt/Equity) produz uma imagem visual coerente com a decomposição por fatores e com os deltas do período anterior para o lado “mais forte” e o lado “mais fraco” de cada duelo?
RQ4. A alocação de capital em três anos baseada apenas em 10-K acrescenta informação que não é visível em um único instantâneo transversal de oito fatores, por exemplo, separando uma margem de fluxo de caixa livre elevada impulsionada por remuneração baseada em recompras de uma impulsionada por reinvestimento, ou distinguindo uma empresa que queima caixa com longo fôlego de outra que se aproxima da exaustão?
RQ5 (apenas descritiva). Na janela visível em um gráfico de preço relativo, a direção da razão de preços entre dois pares concorda com a direção implícita nas lacunas fundamentais entre os seus grupos de fatores, ou preço e fundamentos divergem? Esta pergunta é incluída por completude e não é lida como um sinal de negociação.
H1. Um indicador de lucros no papel está mais frequentemente associado a um delta do período anterior neutro ou negativo na margem de FCF ou na Sloan Ratio do que a uma tendência claramente em melhora da conversão em caixa.
H2. O patrimônio líquido não positivo está sistematicamente associado a grandes recompras acumuladas no registro de alocação de capital e não deve ser lido como “baixa alavancagem” apenas porque uma razão não pôde ser calculada.
H3. Os pontos no quadrante de alto crescimento e alta qualidade de caixa do mapa de posicionamento correspondem com mais frequência a fluxo de caixa livre não negativo e a devolução ativa de capital do que apenas ao crescimento da receita.
H4. Um delta favorável do período anterior em uma métrica invertida (Sloan Ratio, Debt/Equity, em que uma redução é a melhora) é um sinal de “fortalecimento” mais informativo do que o nível estático isolado dessa mesma métrica.
H5. A trajetória de alocação de capital em três anos explica parte do que uma margem de FCF estática deixa sem explicação, a saber, para onde o caixa efetivamente foi: pagamento de dívida, recompras, M&A ou acumulação.
4. Contexto institucional e mensuração
Todos os dados provêm dos company facts da SEC EDGAR (documentos 10-K; 10-Q onde expressamente indicado, para os valores fatoriais “mais recentes” do gráfico de preço relativo) por meio do mecanismo de comparação em duelstocks.com. Oito fatores entram em cada pontuação par a par com pesos padrão: crescimento da receita 18%, margem operacional (OM) 9%, Operating Cash Margin (OCM) 9%, margem de FCF 9%, ROIC 17%, Asset Turnover 7%, Sloan Ratio 17%, Debt/Equity 14%. O crescimento da receita é medido como taxa de crescimento anual composta (CAGR) em três anos; Sloan Ratio e Debt/Equity são ambos invertidos antes da pontuação, de modo que, em cada um, o valor mais baixo é o mais forte. Para cada fator, os valores brutos das duas empresas alimentam uma normalização suave, t = (a' − b') / (|a'| + |b'| + ε), N_a = 0.5 + 0.5·t, N_b = 0.5 − 0.5·t, de modo que uma diferença estreita produz um quase empate e uma diferença ampla produz uma quase goleada, em vez de uma alocação de peso do tipo tudo ou nada. A pontuação final é 100 vezes a soma ponderada dos valores N.
Quatro indicadores estruturais são definidos sobre o mesmo conjunto de fatores e avaliados independentemente da pontuação par a par:
- Lucros no papel (Paper profits) – OCM < OM × 0.7. Uma empresa cuja margem operacional contábil está bem acima do caixa que suas operações efetivamente convertem.
- Patrimônio líquido não positivo (Non-positive equity) – patrimônio líquido contábil ≤ 0, de modo que Debt/Equity não pode ser calculado; o sinal de alavancagem não é uma razão normal e deve ser lido a partir do histórico de alocação de capital.
- Absorção pelo CapEx (CapEx vacuum) – margem de FCF < OCM × 0.3. Uma geração de caixa operacional que as despesas de capital consomem quase inteiramente antes que ela se torne fluxo de caixa livre.
- Ausência de colchão de segurança (No safety cushion) – margem de FCF < 0 e Debt/Equity > 1.5. Fluxo de caixa livre negativo combinado com alavancagem já elevada, e não fluxo de caixa livre negativo sobre um balanço de resto saudável.
Os deltas do período anterior (Δ prior) são a variação de um fator entre dois documentos consecutivos do mesmo tipo apresentados à SEC; nesta amostra, ano a ano, de 10-K para 10-K. Os deltas de margem e de crescimento são expressos em pontos percentuais; os de Asset Turnover e Debt/Equity, em múltiplos (×); a convenção de cores para Sloan Ratio e Debt/Equity é invertida, já que uma redução em qualquer um deles é a direção de melhora. Calculamos esses deltas diretamente a partir dos dois documentos anuais mais recentes de cada empresa, e não a partir de uma única extração transversal, e mantemos a mesma disciplina de tipo de período idêntico que a ferramenta de comparação ao vivo aplica: um 10-K é comparado apenas com o 10-K anterior, nunca com um 10-Q intermediário, de modo que um delta nunca seja contaminado por uma base de ano parcial.
O mapa de posicionamento setorial representa cada componente de um setor GICS em dois eixos construídos a partir da mesma família de fatores da pontuação par a par: Sustainable Growth no eixo horizontal e Quality-Adjusted Cash Margin no eixo vertical, com a cor do ponto definida por Debt/Equity (verde para alavancagem baixa, cinza para moderada, vermelho acima de um limite de 1.5×, e uma cor distinta para os nomes cujo Debt/Equity não pôde ser calculado de forma alguma por patrimônio líquido não positivo, o que torna o indicador de patrimônio líquido não positivo visível no próprio mapa, e não apenas na tabela de fatores).
A alocação de capital em três anos é um registro de identidade fechada construído a partir dos mesmos três 10-K mais recentes: fluxo de caixa livre, dividendos pagos, recompras, aquisições, emissões de ações, variação da dívida líquida e a consequente variação do caixa, terminando no saldo de caixa divulgado. Um traço em qualquer linha significa que não houve atividade etiquetada para aquela rubrica naquele exercício, e não um zero imputado, e preservamos essa distinção em todo o trabalho, em vez de reunir traços e zeros verdadeiros na mesma categoria.
5. Amostra e pares
O painel cobre dez pares de empresas comparáveis, vinte empresas, extraídas de oito setores GICS não financeiros; o universo exclui deliberadamente os Financeiros (em que a estrutura de capital e o significado de “alavancagem” diferem por construção regulatória) e o Imobiliário (em que as exigências de distribuição típicas dos REITs complicam uma leitura direta de recompras versus dividendos em relação ao fluxo de caixa livre). Os pares foram escolhidos para garantir a cobertura dos quatro indicadores estruturais e um corte transversal de setores amplo o bastante para evitar que as convenções contábeis de uma única indústria dominem os resultados.
| Par | Setor | Por que está no painel |
|---|---|---|
| MCD vs SBUX | Consumo discricionário | Ambos os lados carregam o indicador de patrimônio líquido não positivo; caso âncora de RQ2/H2 |
| KO vs PEP | Bens de consumo básico | KO carrega o indicador de lucros no papel e vence o duelo; caso âncora de RQ1/H1 |
| AAPL vs MSFT | Tecnologia da informação | Geradoras maduras de fluxo de caixa livre, recompras versus reinvestimento |
| GOOGL vs META | Serviços de comunicação | Novos programas de dividendos, recompras elevadas, uma lacuna de tag de M&A para as Limitações |
| TSLA vs RIVN | Consumo discricionário | Uma produtora lucrativa e em escala frente a um par em estágio inicial que queima caixa |
| CAT vs DE | Industriais | Cíclicas intensivas em capital, pagadoras de dividendos, contraste de alavancagem |
| XOM vs CVX | Energia | CVX carrega o indicador de lucros no papel dentro de um ciclo de caixa de commodities |
| AMZN vs WMT | Consumo discricionário / Bens de consumo básico | Contraste de intensidade de capital; o mesmo par do artigo complementar sobre métricas relativas |
| JNJ vs PFE | Saúde | PFE carrega o indicador de lucros no papel; atividade de M&A grande e irregular |
| NEE vs SO | Utilidades públicas | Ambas carregam o indicador de absorção pelo CapEx; apenas SO acrescenta a ausência de colchão de segurança |
6. Resultados
6.1 Diagnóstico dos indicadores: o que os lucros no papel e o patrimônio líquido não positivo realmente dizem
Três empresas deste painel carregam um indicador de lucros no papel: KO (margem operacional 28.7%, OCM 15.5%, razão 0.54), CVX (margem operacional 39.8%, OCM 18.0%, razão 0.45) e PFE (margem operacional 35.6%, OCM 18.7%, razão 0.53). Na pontuação par a par, duas das três, KO e CVX, venceram o seu duelo de forma clara (56–44 contra PEP; 53–47 contra XOM); apenas PFE perdeu (38–62 contra JNJ). Essa divisão é, por si só, informativa: um indicador de lucros no papel não é um substituto para perder a comparação. Ele nomeia uma lacuna estrutural específica entre a receita contábil e a receita em caixa, e uma empresa pode carregar essa lacuna e ainda ser o lado mais forte de uma comparação par a par nos outros sete fatores.
A trajetória ano a ano refina ainda mais o quadro, e é aqui que H1 recebe apenas apoio parcial. Para KO, a margem operacional se moveu +7.5 pontos percentuais ano a ano, enquanto a OCM se moveu apenas +1.0 ponto: a lacuna entre contabilidade e caixa aumentou, mesmo com KO vencendo o seu duelo e mesmo com a sua margem de FCF também melhorando +1.0 ponto no mesmo período. Lido à luz de H1, este é o caso limite que a hipótese antecipava: uma lacuna que aumenta, mas não uma margem de FCF que se deteriora; o indicador está registrando uma divergência genuína na forma como as duas margens se movem, e não um colapso generalizado da qualidade do caixa. Para CVX, a OCM melhorou +2.1 pontos ano a ano, enquanto a razão estática entre OCM e OM (0.45) permanece bem abaixo do limite de 0.7: o indicador persiste no instantâneo mais recente justamente porque a margem operacional de CVX é alta o bastante, no lado contábil do ciclo de commodities, para que mesmo uma conversão em caixa genuinamente melhor não a tenha alcançado. Ambos os casos defendem ler o indicador junto com o seu próprio delta, e não como um sim/não estático.
Duas empresas carregam o indicador de patrimônio líquido não positivo: MCD e SBUX, que também são o único empate verdadeiro deste painel, 50–50. Patrimônio líquido ≤ 0 significa que Debt/Equity não é calculado para nenhum dos lados, e esse é o objetivo do indicador, não uma lacuna de dados incidental. Os registros de alocação de capital em três anos de ambas as empresas confirmam diretamente o mecanismo: MCD devolveu 2.06–3.05 bilhões de dólares por ano aos acionistas em recompras, além de 4.53–5.12 bilhões de dólares em dividendos, frente a um fluxo de caixa livre de 6.67–7.25 bilhões de dólares, uma intensidade de distribuição plenamente coerente com uma base de patrimônio empurrada para o território negativo por devolução sustentada de capital, e não por prejuízos operacionais. SBUX mostra o mesmo padrão qualitativo em escala menor até o FY2024 (recompras de 0.98–1.27 bilhão de dólares) antes de zerar as recompras no último exercício, enquanto o seu FCF caiu aproximadamente pela metade, de 3.68 bilhões de dólares para 2.44 bilhões de dólares ao longo da janela de três anos, uma trajetória materialmente diferente que chega ao mesmo indicador estrutural. H2 recebe bom apoio para cada um dos nomes individualmente; o que a comparação par a par acrescenta é que um indicador idêntico, e uma pontuação empatada idêntica, podem repousar sobre duas histórias de alocação de capital diferentes, que é exatamente o tipo de mascaramento que uma pontuação estática sozinha não revelaria.
6.2 Deltas do período anterior versus níveis estáticos
A tabela a seguir apresenta o delta anual do período anterior, de 10-K para 10-K, para crescimento da receita, margem operacional, OCM e margem de FCF em todo o painel. Os valores estão em pontos percentuais; um traço indica que a cifra subjacente é regida pela regra de tipo de período idêntico descrita na Seção 4 e está ancorada nos próprios níveis fatoriais declarados pelo site, em vez de rederivada aqui.
| Ticker | Período (atual → anterior) | Δ Crescimento da receita | Δ Margem operacional | Δ Op. Cash Margin | Δ FCF Margin | Leitura |
|---|---|---|---|---|---|---|
| AAPL | 2025→2024 | −0.4 | +0.5 | −3.5 | −4.1 | As margens de caixa se enfraquecem, embora os níveis de crescimento e de margem se sustentem |
| MSFT | 2026→2025 | +3.7 | +1.2 | +6.8 | −5.2 | Crescimento e conversão em caixa ambos em alta; FCF reduzido pela expansão de CapEx e IA |
| AMZN | 2025→2024 | +1.0 | +0.4 | +1.3 | −4.1 | Margens em melhora; FCF comprimido pelo investimento |
| WMT | 2026→2025 | −0.7 | −0.1 | +0.5 | +0.2 | Essencialmente estável ano a ano |
| CAT | 2025→2024 | −4.0 | −3.7 | −1.2 | −2.3 | Recuo cíclico simultâneo em crescimento e margens |
| DE | 2025→2024 | −4.6 | −3.7 | −1.5 | −1.3 | Mesma direção cíclica de CAT, em magnitude menor |
| GOOGL | 2025→2024 | +1.8 | −0.1 | +5.1 | −2.6 | Conversão em caixa em alta frente a uma margem operacional estável |
| META | 2025→2024 | +8.2 | −0.7 | +2.1 | −9.9 | Crescimento forte, OCM ainda em melhora, FCF nitidamente menor por causa do reinvestimento |
| KO | 2025→2024 | −3.1 | +7.5 | +1.0 | +1.0 | A margem operacional dispara; a conversão em caixa mal acompanha: a lacuna dos lucros no papel aumenta |
| PEP | 2025→2024 | −2.1 | −1.8 | −0.7 | n/a | Um enfraquecimento suave e generalizado |
| MCD | 2025→2024 | +1.3 | +0.9 | +2.8 | +1.0 | Em melhora em todas as margens mostradas, apesar do indicador de patrimônio líquido não positivo |
| SBUX | 2025→2024 | −2.7 | −7.1 | −4.1 | −2.6 | Deterioração acentuada em todas as margens mostradas |
| XOM | 2025→2024 | −15.1 | — | −0.1 | −1.7 | Queda da receita pelo ciclo de commodities; margem de caixa quase estável |
| CVX | 2025→2024 | −15.4 | — | +2.1 | +1.2 | Receita em queda com o ciclo; conversão em caixa melhora mesmo assim |
| JNJ | 2025→2024 | +3.7 | — | −1.3 | −1.4 | Leve enfraquecimento da margem de caixa |
| PFE | 2025→2024 | −7.2 | — | −1.3 | −1.0 | A conversão em caixa continua atrás da margem operacional; o indicador persiste em nível e em tendência |
| NEE | 2025→2024 | −3.8 | ~0 | −8.0 | n/a | Margem de caixa em queda sobre uma margem operacional de resto estável |
| SO | 2025→2024 | −4.6 | −1.8 | −3.5 | −13.0 | O FCF se deteriora de forma acentuada dentro de um perfil de alavancagem já elevado |
| TSLA | 2025→2024 | −16.8 | −2.7 | +0.3 | +2.9 | O crescimento desacelera bruscamente, embora as margens se sustentem ou melhorem levemente |
| RIVN | 2025→2024 | −300.6 | +27.8 | +20.1 | +11.3 | Todos os fatores em melhora a partir de uma base extremamente baixa; ver Seção 6.4 |
Dois pontos disciplinam a leitura desta tabela. Primeiro, para DE, JNJ, XOM e CVX, os deltas da margem operacional são deixados em branco em vez de estimados: a etiquetagem XBRL disponível do resultado operacional de vários emissores dos setores de energia e farmacêutico não se resolve de forma limpa em uma única linha comparável ao longo de anos consecutivos para todos os emissores deste painel, e informamos um traço em vez de um número que não podemos sustentar, em coerência com a disciplina de fontes da Seção 4. Segundo, o enorme delta de crescimento da receita de RIVN é um artefato de um denominador muito pequeno no ano anterior, e não um sinal de desaceleração economicamente significativo por si só; é por isso que a Seção 6.4 lê RIVN pelo seu fôlego de caixa na alocação de capital, e não apenas por esta tabela.
Três casos merecem ser nomeados diretamente frente a H4. MCD melhora em todas as margens mostradas, apesar de carregar o indicador de aparência mais severa (patrimônio líquido não positivo) entre as duas empresas do seu par: o delta, e não o indicador estático, é o sinal mais informativo sobre se a situação está melhorando ou piorando, exatamente como prevê H4. SBUX se deteriora em todas as margens mostradas carregando o mesmo indicador, e os deltas sozinhos separariam corretamente as duas empresas, embora a pontuação estática as empate em 50–50 e o texto do indicador seja idêntico palavra por palavra. SO combina um delta de margem de FCF fortemente negativo (−13.0 pontos) com um Debt/Equity já elevado (1.72×, acima do limite de 1.5× de ausência de colchão de segurança): o delta mostra que o colchão não é apenas fino, mas está ativamente afinando ainda mais.
6.3 Mapa de posicionamento versus decomposição por fatores
O mapa setorial codifica visualmente, de forma direta, duas das dimensões estruturais do painel: a posição horizontal para o crescimento sustentável, a posição vertical para a margem de caixa ajustada pela qualidade e a cor do ponto para a faixa de Debt/Equity. Vale relatar três concordâncias entre o mapa e a tabela de fatores, porque juntas dizem respeito a RQ3.
Primeiro, a codificação por cores do mapa sinaliza de forma independente o patrimônio líquido não positivo. No mapa de Consumo discricionário, MCD e SBUX aparecem ambas como pontos de cor amarela, a cor reservada aos nomes em que Debt/Equity não pode ser calculado, em vez de qualquer tom do espectro do verde ao vermelho usado para todas as outras empresas do mesmo mapa. Um leitor que olhasse apenas o mapa, sem acesso ao texto do indicador, já veria que esses dois nomes ficam fora da escala normal de cores de alavancagem. No mapa de Utilidades públicas, SO aparece em vermelho (Debt/Equity 1.72×, acima do limite de 1.5×), enquanto NEE, com 1.47×, aparece na faixa cinza adjacente, e não em vermelho, refletindo corretamente que NEE fica logo abaixo do mesmo limite que sinaliza SO por ausência de colchão de segurança.
Segundo, a separação vertical no mapa acompanha de perto a lacuna de margem de caixa operacional dentro de cada par. No mapa de Serviços de comunicação, META fica substancialmente acima de GOOGL, de acordo com a OCM de 57.6% de META contra 40.9% de GOOGL. No mapa de Bens de consumo básico, KO e PEP ficam próximas entre si, perto da linha mediana horizontal do setor, de acordo com a sua lacuna de OCM mais estreita (15.5% contra 12.9%) em relação à distância entre META e GOOGL. No mapa de Energia, XOM e CVX aparecem como pontos verdes quase sobrepostos perto do centro da nuvem setorial: ambas têm Debt/Equity baixo (0.18× e 0.21×) e ficam próximas em termos de margem de caixa (15.6% contra 18.0%), um quase empate visual que corresponde ao lado mais estreito da dispersão de pontuações deste painel (CVX vence por 53–47, a segunda menor diferença do painel depois de MCD-SBUX).
Terceiro, o mapa isola RIVN como um ponto atípico visível, em vez de incorporá-la à nuvem principal de Consumo discricionário. RIVN aparece bem abaixo e à direita no mapa setorial: posição horizontal (de crescimento) alta, impulsionada pelo efeito de base baixa descrito na Seção 6.2, e muito abaixo da linha mediana horizontal em qualidade de caixa, de acordo com uma OCM de −14.5%. Nenhum outro componente visível nesse mapa fica sequer perto da mesma combinação de crescimento extremo e qualidade de caixa profundamente negativa, o que antecipa visualmente a leitura de alocação de capital da Seção 6.4 antes mesmo de o leitor abrir essa tabela.
Frente a H3, a evidência dos mapas de posicionamento é mista, e não uniformemente confirmatória. O quadrante de alto crescimento e alta qualidade de caixa é ocupado nesses mapas sobretudo por componentes menores, fora dos dez pares focais (nomes como SNDK e PLTR no mapa de Tecnologia da informação, DASH e CCL no de Consumo discricionário), e não pelos pares deste painel, que com mais frequência ficam mais perto do centro de suas respectivas nuvens setoriais. Isso é, em si, um resultado: neste painel, ser o lado mais forte de um duelo entre duas empresas não exige ocupar o quadrante extremo de um mapa setorial de trinta a oitenta componentes: MSFT, META e CVX vencem seus respectivos duelos situando-se na parte central superior ou no centro de suas nuvens setoriais, e não na borda extrema.
6.4 Alocação de capital em três anos
Três histórias deste painel sustentam diretamente H5: o registro de alocação de capital resolve uma questão que uma margem de FCF de um único período deixa em aberto.
A tabela fatorial estática de RIVN, sozinha, comunica uma empresa que queima caixa (margem de FCF −46.2%) com ROIC negativo e Sloan Ratio negativa. O registro de alocação de capital acrescenta a informação que de fato determina se o problema é agudo ou crônico: um saldo de caixa de 3.58 bilhões de dólares frente a uma queima de FCF no último ano que implica cerca de 1.4 ano de fôlego ao ritmo atual, financiada em parte por emissão de ações (0.75 bilhão de dólares no último ano, em forte alta em relação a 0.06 bilhão de dólares dois anos antes), e não por dívida. É uma leitura materialmente diferente da de “fluxo de caixa livre negativo” isoladamente: trata-se de uma produtora em estágio inicial e em escalonamento financiando, por diluição, uma queima crescente, mas ainda financiada, e não de uma empresa diante de uma exaustão iminente do caixa disponível.
Os fatores estáticos de SO mostram um indicador de absorção pelo CapEx e, no último ano, margem de FCF negativa. O registro de três anos mostra que isso não é um evento isolado: o FCF foi de −1.54 bilhão de dólares para +0.83 bilhão de dólares e de volta para −2.94 bilhões de dólares ao longo dos três anos mostrados, enquanto os dividendos se mantiveram essencialmente estáveis em torno de 3 bilhões de dólares em todos os anos da janela, independentemente de o fluxo de caixa livre ter sido positivo ou negativo naquele ano, e a dívida líquida aumentou em ambos os dois últimos anos. Combinado com uma razão Debt/Equity já acima do limite de 1.5× do painel para ausência de colchão de segurança, o registro mostra uma empresa que mantém o seu compromisso de distribuição por meio da emissão de dívida sobre uma base de fluxo de caixa livre que foi negativa em dois dos três últimos exercícios fiscais, precisamente a configuração que o indicador de ausência de colchão de segurança foi concebido para evidenciar, e precisamente o tipo de padrão que um instantâneo da margem de FCF de um único período não distinguiria de uma queda temporária causada pelo calendário dos investimentos.
O registro de três anos de AMZN conta um terceiro tipo de história. O fluxo de caixa livre se manteve em uma faixa estreita de 32–33 bilhões de dólares nos dois primeiros anos mostrados antes de cair bruscamente para 7.7 bilhões de dólares no último ano, sem dividendo nem recompra em nenhum dos três anos e com uma virada do pagamento de dívida para uma emissão líquida de dívida de 11.14 bilhões de dólares no último ano. Lido frente à tabela fatorial estática isoladamente, em que a margem de FCF de AMZN (21.5%) e a sua margem de caixa operacional (22.5%) superam ambas com folga as de WMT, o registro acrescenta o contexto de que a própria geração de caixa de AMZN se comprimiu de forma significativa ano a ano, mesmo permanecendo à frente de WMT em todos os fatores de conversão em caixa, e de que AMZN está financiando essa compressão por meio de dívida, e não por meio de uma redução de retornos aos acionistas que ela, de qualquer forma, não fazia. O registro de WMT, por contraste, mostra recompras que crescem de 2.78 bilhões de dólares para 8.09 bilhões de dólares nos mesmos três anos frente a um fluxo de caixa livre em crescimento constante: uma aceleração convencional, financiada com caixa, da remuneração aos acionistas que a tabela fatorial estática, em que WMT fica atrás de AMZN em todos os fatores de margem, não evidenciaria por si só.
6.5 Razão de preços versus lacunas fundamentais (apenas descritivo)
Para o único par em que um gráfico de preço relativo foi capturado junto com o conjunto diagnóstico completo (MCD versus SBUX), a razão de preços MCD/SBUX caiu de aproximadamente 2.95 em junho para aproximadamente 2.45 no início de outubro, com a sua média móvel de 50 dias em 2.53: uma tendência de preços de mercado em que SBUX superou MCD na janela mostrada. O painel de lacunas fundamentais do mesmo gráfico, construído com a mesma normalização suave t descrita na Seção 4 e agrupado pela taxonomia de cinco grupos descrita na Seção 1, mostrou Margin Conversion (OCM) inclinado para MCD (t = +0.51), enquanto Capital Efficiency (ROIC, t = −0.43) e Accrual Quality (Sloan Ratio, t = −0.35) se inclinavam ambos para SBUX, Growth estava próximo da paridade (t = +0.02) e Financial Strength (Debt/Equity) estava bloqueado para ambos os lados pelo indicador compartilhado de patrimônio líquido não positivo. A mediana dos quatro grupos disponíveis, t = −0.16, inclina-se levemente para SBUX, na mesma direção da tendência de preços mostrada no mesmo gráfico.
Lemos este caso único como uma descrição, não como uma demonstração: um par, uma janela, um caso em que a direção dos fundamentos e a do preço concordam em vez de divergir. A tabela de deltas da Seção 6.2 mostra que a trajetória do período anterior do mesmo par aponta com mais intensidade na direção desfavorável a SBUX (Δ margem operacional −7.1 pontos, Δ margem de FCF −2.6 pontos) do que na favorável a MCD, o que é pelo menos coerente com (embora longe de provar) um movimento de preços de mercado que acompanhou uma deterioração fundamental já visível no delta do período anterior antes do início desta janela. Não estendemos esta observação descritiva aos outros nove pares, para os quais nenhum gráfico de razão de preços foi capturado, nem a lemos como evidência de que preço e fundamentos se movem juntos de forma mais geral.
7. Discussão
Lidas em conjunto, as Seções 6.1 a 6.5 apontam para o mesmo princípio interpretativo a partir de quatro direções diferentes: um indicador nomeia um padrão estrutural, um delta nomeia uma direção, uma posição no mapa nomeia uma posição relativa dentro de um conjunto de pares mais amplo e um registro de alocação de capital nomeia para onde o caixa efetivamente foi; e nenhum desses quatro substitui qualquer um dos outros. O indicador de lucros no papel de KO persiste e até se amplia em relação ao período anterior, e KO ainda vence o seu duelo com folga, porque o indicador diz respeito à relação entre duas margens específicas, não ao agregado dos oito fatores. MCD e SBUX compartilham um indicador idêntico e uma pontuação empatada idêntica enquanto se movem em direções opostas em cada delta mostrado e financiam trajetórias de distribuição de três anos inteiramente diferentes. A tabela fatorial de RIVN para um único período, sozinha, parece uniformemente alarmante; o seu registro de alocação de capital parece o de uma empresa em escalonamento com fôlego financiado, e não o de uma crise iminente. Em cada caso, o diagnóstico mais rico não contradiz o mais simples: acrescenta uma dimensão que o mais simples não foi construído para carregar.
Para um investidor ou analista que utiliza uma ferramenta de comparação par a par na prática, a implicação operacional é uma ordem de leitura, e não um número único: começar pela pontuação e pelos indicadores para ver como é a estrutura contábil de cada empresa isoladamente; passar aos deltas do período anterior para saber se essa estrutura está melhorando ou se deteriorando; usar o mapa de posicionamento para situar ambas as empresas dentro do seu setor mais amplo, e não apenas uma contra a outra; e encerrar com o registro de alocação de capital em três anos para ver se o caixa implícito nas margens de fato chegou e para onde foi. Nenhuma dessas etapas exige abandonar a pontuação única par a par que um artigo complementar deste site já defendeu em seus próprios termos; cada etapa simplesmente responde a uma pergunta que uma única pontuação, por construção, não consegue responder.
8. Limitações
- A cobertura de tags XBRL não é uniforme entre os emissores. Várias empresas de energia e farmacêuticas deste painel não etiquetam o resultado operacional em uma única linha diretamente comparável de um ano para o outro, razão pela qual a Seção 6.2 informa um traço em vez de um delta estimado de margem operacional para JNJ, PFE, XOM e CVX; o traço reflete variação na estrutura de divulgação, não ausência da atividade subjacente. O delta de margem operacional de DE (Seção 6.2) é informado como número, e não como traço, pois a sua etiquetagem no 10-K se resolveu de forma limpa nos dois anos comparados.
- Um traço nas tabelas de alocação de capital denota ausência de atividade etiquetada para aquela rubrica naquele exercício, e não um zero imputado; os dois são mantidos distintos ao longo deste trabalho, e advertimos contra lê-los de forma intercambiável em outros contextos.
- O painel tem dez pares e vinte empresas, escolhidos para garantir a cobertura dos quatro indicadores estruturais e um corte transversal de oito setores: é um desenho de série de casos estruturado e balanceado por indicadores, não uma amostra aleatória ou estatisticamente representativa de todo o universo não financeiro, e as frequências descritivas deste trabalho devem ser lidas em conformidade, e não como estimativas populacionais.
- O delta do período anterior de crescimento da receita de RIVN (Seção 6.2) é um artefato de uma base do período anterior excepcionalmente pequena e não deve ser lido como um sinal de crescimento autônomo; por essa razão, encaminhamos deliberadamente a interpretação de RIVN pelo registro de alocação de capital da Seção 6.4, e não pela tabela de deltas.
- A janela de alocação de capital em três anos é fixada por desenho nos três 10-K mais recentes e não se estende mais para trás; uma janela mais longa mostraria, para alguns nomes (em particular a expansão de renováveis, intensiva em capital, de NEE), um ciclo de distribuição mais completo do que esta janela consegue mostrar por si só.
- Os Financeiros e o Imobiliário são excluídos por desenho (Seção 5); nada neste trabalho deve ser lido como extensível a qualquer um dos dois setores sem um tratamento separado de suas diferentes convenções de alavancagem e distribuição.
- A Seção 6.5 é expressamente descritiva e limitada a um único par e a uma única janela de observação; não é uma afirmação de market timing e não é estendida aos outros nove pares deste painel.
- Nenhum dos diagnósticos deste trabalho (indicadores, deltas, posição no mapa ou alocação de capital) é calibrado com os retornos acionários subsequentes nem demonstrou prevê-los. Este trabalho descreve a coerência interna dos números divulgados por uma empresa frente ao seu par e ao seu próprio documento anterior; não testa se essa coerência, ou a sua falta, está precificada.
9. Conclusão
Uma pontuação par a par responde a quem é mais forte. Ela não responde, por si só, se essa força é estruturalmente limpa, se está melhorando, como se posiciona frente a um conjunto de pares mais amplo ou para onde foi de fato o caixa que a sustenta. Este trabalho combinou quatro diagnósticos (indicadores estruturais, deltas anuais do período anterior calculados diretamente a partir de 10-K consecutivos, um mapa de posicionamento setorial construído a partir da mesma família de fatores e um registro de alocação de capital em três anos) em dez pares de empresas não financeiras de setores diferentes, e constatou que cada diagnóstico de fato acrescenta informação que os demais não carregam. Um indicador de lucros no papel pode persistir e até se ampliar no lado vencedor de um duelo (KO), em vez de sinalizar um perdedor. Um indicador idêntico de patrimônio líquido não positivo e uma pontuação empatada idêntica podem repousar sobre duas trajetórias ano a ano opostas (MCD em melhora, SBUX em deterioração) e dois caminhos diferentes de alocação de capital. Uma tabela fatorial de um único período pode parecer uniformemente alarmante para uma empresa cujo registro de alocação de capital em três anos mostra um fôlego financiado e financiável, e não uma crise iminente (RIVN). Nada disso substitui a pontuação relativa única que o leitor, em última instância, quer ao comparar duas empresas: é o contexto que diz ao leitor quanto peso essa pontuação, e a tendência por trás dela, devem ter.
Referências
Sloan, R. G. (1996). Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings? The Accounting Review, 71(3), 289–315.
Dechow, P., Ge, W., & Schrand, C. (2010). Understanding Earnings Quality: A Review of the Proxies, Their Determinants and Their Consequences. Journal of Accounting and Economics, 50(2–3), 344–401.
Ohlson, J. A. (1995). Earnings, Book Values, and Dividends in Equity Valuation. Contemporary Accounting Research, 11(2), 661–687.
Penman, S. H. (2013). Financial Statement Analysis and Security Valuation (5th ed.). McGraw-Hill.
Lev, B., & Nissim, D. (2006). The Persistence of the Accrual Anomaly. Contemporary Accounting Research, 23(1), 193–226.
Richardson, S. A., Sloan, R. G., Soliman, M. T., & Tuna, I. (2005). Accrual Reliability, Earnings Persistence and Stock Prices. Journal of Accounting and Economics, 39(3), 437–485.
Grullon, G., & Michaely, R. (2002). Dividends, Share Repurchases, and the Substitution Hypothesis. The Journal of Finance, 57(4), 1649–1684.
Grullon, G., & Michaely, R. (2004). The Information Content of Share Repurchase Programs. The Journal of Finance, 59(2), 651–680.
Almeida, H., Campello, M., & Weisbach, M. S. (2004). The Cash Flow Sensitivity of Cash. The Journal of Finance, 59(4), 1777–1804.
Metodologia DUEL: duelstocks.com/methodology
DuelStocks, “From Winner-Take-All to Soft Relative Scores” e “How Many Independent Signals? A Principal Component Analysis of an 8-Factor Stock Model” (notas metodológicas complementares deste site).
Apêndice A: Alocação de capital em três anos, painel completo (bilhões de USD)
| Ticker | Exercícios | FCF (FY−2 / FY−1 / último) | Dividendos | Recompras | M&A | Emissões | Δ Dívida líquida (FY−1 / último) | Saldo de caixa (FY−2 / FY−1 / último) |
|---|---|---|---|---|---|---|---|---|
| MCD | 2023/24/25 | 7.25 / 6.67 / 7.19 | −4.53 / −4.87 / −5.12 | −3.05 / −2.82 / −2.06 | — / — / — | — / — / — | −0.48 / +1.48 | 4.58 / 1.08 / 0.77 |
| SBUX | 2023/24/25 | 3.68 / 3.32 / 2.44 | −2.43 / −2.58 / −2.77 | −0.98 / −1.27 / 0 | 0 / 0 / −0.18 | 0.17 / 0.11 / 0.08 | +0.17 / +2.01 | 3.55 / 3.29 / 3.22 |
| KO | 2023/24/25 | 9.75 / 4.74 / 5.30 | −7.95 / −8.36 / −8.78 | −2.29 / −1.79 / −0.75 | — / — / — | 0.54 / 0.75 / 0.31 | +4.05 / +0.10 | 9.37 / 10.83 / 10.27 |
| PEP | 2023/24/25 | 7.92 / 7.19 / 7.67 | −6.68 / −7.23 / −7.64 | −1.00 / −1.00 / −1.00 | −0.31 / −0.26 / −3.39 | — / — / — | −0.29 / +5.12 | 9.71 / 8.51 / 9.16 |
| AAPL | 2023/24/25 | 99.58 / 108.81 / 98.77 | −15.03 / −15.23 / −15.42 | −77.55 / −94.95 / −90.71 | — / — / — | — / — / — | −7.35 / −4.55 | 29.96 / 29.94 / 35.93 |
| MSFT | 2024/25/26 | 74.07 / 71.61 / 66.99 | −6.17 / −6.76 / −26.45 | −17.25 / −18.42 / −22.27 | — / — / — | 2.00 / 2.06 / 2.01 | −1.04 / +3.37 | 18.32 / 30.24 / 20.93 |
| GOOGL | 2023/24/25 | 69.50 / 72.76 / 73.27 | 0 / −7.36 / −10.05 | −61.50 / −62.22 / −45.71 | — / — / — | — / — / — | −2.86 / +38.08 | 24.05 / 23.47 / 30.71 |
| META | 2023/24/25 | 43.85 / 54.07 / 46.11 | 0 / −1.27 / −1.33 | −19.77 / −30.12 / −26.25 | — / — / — | — / — / — | +10.44 / +29.92 | 41.86 / 43.89 / 35.87 |
| TSLA | 2023/24/25 | 4.36 / 3.58 / 6.22 | — / — / — | — / — / — | −0.06 / 0 / 0 | — / — / — | +2.85 / +1.05 | 16.40 / 16.14 / 16.51 |
| RIVN | 2023/24/25 | −5.89 / −2.86 / −2.49 | — / — / — | — / — / — | — / — / — | 0.06 / 0.06 / 0.75 | +0.01 / 0.00 | 7.86 / 5.29 / 3.58 |
| CAT | 2023/24/25 | 11.29 / 10.05 / 8.92 | −2.56 / −2.65 / −2.75 | −4.97 / −7.70 / −5.19 | −0.07 / −0.03 / −0.05 | 0.01 / 0.02 / 0.02 | +2.63 / +4.47 | 6.98 / 6.89 / 9.98 |
| DE | 2023/24/25 | 7.09 / 7.59 / 6.10 | −1.43 / −1.60 / −1.72 | −7.22 / −4.01 / −1.14 | −0.08 / — / −0.10 | — / — / — | n/a / n/a | 7.46 / 7.32 / 8.28 |
| XOM | 2023/24/25 | 33.45 / 30.72 / 23.61 | −14.94 / −16.70 / −17.23 | −17.75 / −19.63 / −20.27 | — / — / — | — / — / — | +0.15 / −1.21 | 31.54 / 23.03 / 10.68 |
| CVX | 2023/24/25 | 19.78 / 15.04 / 16.59 | −11.34 / −11.80 / −12.75 | −14.94 / −15.23 / −12.08 | −0.06 / 0 / −1.06 | — / — / — | +3.71 / +16.22 | 8.18 / 8.26 / 7.29 |
| AMZN | 2023/24/25 | 32.22 / 32.88 / 7.70 | — / — / — | 0 / 0 / — | — / — / — | — / — / — | −9.18 / +11.14 | 73.39 / 78.78 / 86.81 |
| WMT | 2024/25/26 | 15.12 / 12.66 / 14.92 | −6.14 / −6.69 / −7.51 | −2.78 / −4.49 / −8.09 | −0.01 / −1.90 / −0.05 | 0.72 / 0.36 / 0.11 | −1.39 / +5.70 | 9.87 / 9.04 / 10.73 |
| JNJ | 2023/24/25 | 18.25 / 19.84 / 19.70 | −11.77 / −11.82 / −12.38 | −5.05 / −2.43 / −5.95 | 0 / −15.15 / −17.54 | — / — / — | +7.58 / +11.55 | 21.86 / 24.11 / 19.71 |
| PFE | 2023/24/25 | 4.79 / 9.84 / 9.07 | −9.25 / −9.51 / −9.77 | 0 / 0 / — | −43.43 / 0 / −6.93 | — / — / — | −2.64 / +3.49 | 2.85 / 1.04 / 1.14 |
| NEE | 2023/24/25 | 11.30 / 13.26 / 12.48 | −3.78 / −4.24 / −4.68 | — / — / — | — / — / — | 4.51 / 0.05 / 2.04 | +12.14 / +12.61 | 2.69 / 1.49 / 2.81 |
| SO | 2023/24/25 | −1.54 / 0.83 / −2.94 | −3.04 / −2.95 / −3.02 | — / — / — | 0 / 0 / −0.64 | 0.04 / 0.14 / 1.62 | +0.58 / +6.26 | 0.75 / 1.07 / 1.64 |
Apêndice B: Definições dos indicadores (tradução dos textos originais da ferramenta)
- Lucros no papel (Paper profits): Op. Cash Margin < Operating Margin × 0.7
- Patrimônio líquido não positivo (Non-positive equity): patrimônio líquido contábil ≤ 0 — Debt/Equity não calculado (frequentemente recompras grandes ou prejuízo acumulado); o sinal de alavancagem não é uma razão normal
- Absorção pelo CapEx (CapEx vacuum): FCF Margin < Op. Cash Margin × 0.3
- Ausência de colchão de segurança (No safety cushion): FCF Margin < 0 e Debt/Equity > 1.5
Diagnóstico descritivo de pares sobre documentos públicos apresentados à SEC. Não constitui recomendação de investimento. Todos os números provêm dos company facts da SEC EDGAR por meio de duelstocks.com; verifique os números atuais na ferramenta ao vivo e nos documentos primários antes de confiar em qualquer número individual.
Um ensaio sobre medição, não uma recomendação de ações. Não constitui aconselhamento de investimento.
Dois relatórios anuais lado a lado. Empresa A: ROIC de 22%, margem operacional de 30%. Empresa B: ROIC de 15%, margem operacional de 25%. No papel, A parece a vencedora óbvia — um screener classificaria-a mais alto, uma ordenação numa folha de cálculo colocá-la-ia no topo, e a maioria dos investidores pararia por aí.
Mas um ROIC de 22% num negócio de software com pouco capital e um ROIC de 15% numa industrial com uma base de ativos, um ciclo de fundo de maneio e uma estrutura competitiva diferentes não são o mesmo objeto económico, mesmo sendo os mesmos dois dígitos. O número que realmente importa para uma decisão — devo ficar com A em vez de B — não está em nenhuma das duas páginas isoladamente. Vive na diferença entre ambas, uma vez removido o ruído que as duas empresas partilham. Os engenheiros resolveram exatamente este problema há muito tempo, numa área que nada tem a ver com finanças.
O que um recetor de 30.000 dólares ensinou aos topógrafos sobre ruído
Um único recetor GPS, de qualidade smartphone ou profissional, indica a posição cronometrando sinais vindos de satélites a dezenas de milhares de quilómetros. Mesmo com céu limpo, essa posição é tipicamente precisa entre 3 e 10 metros. A atmosfera curva o sinal de forma imprevisível, os relógios dos satélites derivam nanossegundos que se traduzem em metros, e a posição orbital nunca é conhecida com precisão perfeita. Nada disso é ruído exclusivo do seu recetor — é um viés partilhado que qualquer recetor na mesma zona experimenta no mesmo momento.
Os topógrafos não combatem esse viés diretamente. Anulam-no. Um segundo recetor — uma estação base fixa numa localização conhecida — mede o mesmo erro atmosférico e orbital partilhado no mesmo instante. Ao subtrair a leitura da estação base à do rover, a parte partilhada do erro desaparece da diferença quase por completo. O que resta é dominado pela curta linha de base entre os dois recetores, não pelo longo e ruidoso caminho até ao satélite. Esta técnica, chamada posicionamento cinemático em tempo real (RTK), leva rotineiramente a precisão de vários metros para cerca de um centímetro (Hofmann-Wellenhof, Lichtenegger & Wasle, 2008). Nada mudou do lado dos satélites. O que mudou foi a medição — de uma posição absoluta para uma relativa.
| Modo | O que é medido | Precisão típica | Analogia financeira |
|---|---|---|---|
| GNSS absoluto (recetor único) | Posição num referencial global | 3 a 10 metros | Um rácio isolado: ROIC, margem, crescimento, lido sozinho |
| Relativo (RTK: base mais rover) | Vetor entre duas estações conhecidas | Cerca de 1 centímetro | Um contraste fator a fator entre duas empresas |
A analogia é uma estrutura, não uma prova. Os mercados não são uma constelação de satélites, os relatórios depositados não são sinais contínuos, e um par mal escolhido — duas empresas sem nada em comum — é como uma fixação relativa sem visão de céu partilhada entre os recetores. O ponto é mais estreito e mais útil do que a metáfora: sempre que duas medições partilham uma fonte comum de erro, compará-las entre si anula mais desse erro do que qualquer uma das medições conseguiria anular sozinha. Isto não é uma opinião financeira. É o mesmo facto aritmético que transforma um GPS de 10 metros num RTK de 1 centímetro.
Para que serve realmente um número absoluto
As métricas absolutas não estão erradas. Respondem a uma pergunta real: quão grande é este número, para esta empresa, agora mesmo. É exatamente isso que se precisa para um punhado de tarefas:
- Filtrar um universo amplo até uma lista curta ("ROIC acima do custo de capital").
- Acompanhar a trajetória de uma empresa ao longo do tempo.
- Alimentar um modelo de fluxo de caixa descontado ou de crédito de um único nome, onde se precisa de um nível, não de uma classificação.
- Limiares regulatórios, de covenant ou de conformidade definidos em termos absolutos.
Onde um número absoluto se esgota é precisamente na questão que realmente consome a atenção de um investidor uma vez que a lista curta existe: dadas duas ações que estou disposto a deter, qual é mais forte, e por quanto? Uma coluna ordenada não responde a isso. Também falha de três formas específicas e partilhadas:
Inflação sectorial generalizada. Se cada empresa de um sector vê a sua margem expandir 300 pontos base devido a um ciclo de preços partilhado, um painel absoluto acende a verde em toda a linha. As empresas não se tornaram melhores umas em relação às outras — todo o referencial se deslocou, exatamente como uma constelação de satélites que deriva em conjunto.
Armadilhas de escala e estrutura. Um ROIC muito elevado pode refletir um negócio genuinamente eficiente, ou pode refletir uma base de capital próprio reduzida após anos de recompras, ou um modelo com pouco capital que simplesmente carrega menos ativos no balanço. O número por si só não diz qual dos casos se aplica.
Conflito multifatorial. Pares reais raramente concordam em tudo. Uma empresa vence em crescimento e conversão de caixa, a outra vence em rotação de capital e disciplina de balanço. Um screener absoluto não resolve esse conflito — apenas mostra dois vistos verdes separados e deixa a reconciliação ao utilizador.
O núcleo aritmético
Trate qualquer métrica fundamental observada para a empresa i como a soma de três componentes:
x_i = q_i + s + e_i
q_i é a qualidade real, própria da empresa, nessa dimensão. s é um choque comum partilhado por ambas as empresas comparadas — um ciclo de margens sectorial, um ambiente de taxas, uma moda contabilística do sector, uma expansão temporária de múltiplos em todo o grupo de pares. e_i é ruído idiossincrático específico do relatório dessa única empresa.
Um screening absoluto olha apenas para x_A, pelo que s viaja sem ser inspecionado dentro do número. Uma comparação por pares olha, em vez disso, para a diferença:
x_A menos x_B = (q_A menos q_B) + (e_A menos e_B)
O termo partilhado s desapareceu. Não estimado, não ajustado — desaparecido, pela mesma subtração que transforma duas fixações GPS ruidosas num vetor preciso. Esta única linha é o argumento estrutural de todo este texto. Tudo o resto é aplicação e ressalvas honestas.
Para uma comparação utilizável, a diferença precisa de ser utilizável numa fórmula, não apenas como um sinal. Defina, para dois valores brutos a e b num fator (invertendo primeiro o sinal para qualquer métrica em que menor seja melhor, como um rácio de qualidade dos resultados):
t = (a' menos b') / (|a'| + |b'| + epsilon), sendo epsilon uma pequena constante positiva
N_A = 0,5 + 0,5 vezes t N_B = 0,5 menos 0,5 vezes t
Se a for igual a b, ambos os lados caem exatamente em 0,5 — um verdadeiro empate. Uma diferença estreita produz uma inclinação suave para um lado. Uma diferença ampla produz uma inclinação forte. A magnitude é preservada, não colapsada num binário de ganhar ou perder. Uma pontuação ponderada multifatorial é então uma soma sobre os fatores, Score = 100 vezes a soma de peso_k vezes N_k, normalizada de modo que os pesos somem um. Isto não é um modelo de avaliação e não atribui preço a nada. É um torneio normalizado sobre fundamentais divulgados — o equivalente financeiro do vetor base-e-rover, não uma fotografia de satélite de nenhuma das duas empresas isoladamente.
Um par ao vivo: Amazon contra Walmart
O retalho e o comércio eletrónico são frequentemente colocados na mesma gaveta mental a ponto de uma leitura absoluta de qualquer uma das empresas parecer parcial consoante a coluna que se olhe primeiro. O painel de oito fatores abaixo não é preenchimento ilustrativo — são os mesmos dados reais, derivados da SEC, usados noutras análises de duelo e fragilidade deste mesmo site, atuais à mesma captura de relatórios.
| Fator | AMZN | WMT | Vantagem absoluta |
|---|---|---|---|
| Crescimento de receita (CAGR 3 anos) | 11,73% | 5,27% | AMZN |
| Margem de caixa operacional | 22,51% | 5,83% | AMZN |
| ROIC | 9,89% | 16,74% | WMT |
| Sloan ratio (quanto mais baixo, melhor) | 17,40% | -5,31% | WMT |
| Giro de ativos | 0,65x | 2,43x | WMT |
| Giro de recebíveis | 8,14x | 64,39x | WMT |
| Margem operacional | 11,16% | 4,18% | AMZN |
| Margem de FCF | 21,48% | 2,09% | AMZN |
Passado pela normalização suave descrita acima com pesos por defeito, o agregado fica em 51,2 a 48,8 a favor da Amazon — um quase empate, não uma goleada em nenhuma direção.
Leia o que as duas metades da tabela dizem realmente antes de olhar para esse único número. O bloco de eficiência de capital — ROIC, giro de ativos, giro de recebíveis — coroa claramente a Walmart, e por margens amplas; um giro de recebíveis de 64,4 vezes contra as 8,1 vezes da Amazon é a maior diferença bruta em todo o painel, informação real sobre como uma rede de lojas faz girar o seu fundo de maneio. O bloco de conversão de caixa e crescimento — margem de caixa operacional, margem operacional, margem de FCF, crescimento de receita — coroa igualmente com clareza a Amazon. Ambas as metades são verdadeiras. Nenhuma das colunas absolutas está a mentir. O que uma leitura winner-take-all de qualquer uma das metades sozinha faria seria fabricar uma derrota esmagadora que o panorama completo não sustenta em nenhuma direção — e o que o quase empate no agregado faz, corretamente, é recusar fingir que a força real de uma empresa anula a fraqueza real da outra num falso consenso. O Sloan ratio acrescenta aqui um segundo aviso, independente: o perfil de resultados da Amazon, mais carregado de accruals, é uma razão legítima para ponderar um pouco menos, à primeira vista, a vantagem de conversão de caixa — não uma razão para a ignorar.
Por que os investidores pensam ter usado vinte métricas — e usaram duas
Há um segundo modo de falha, mais silencioso, por baixo da questão absoluto-versus-relativo, e explica por que adicionar mais colunas a um screener não resolve o problema da forma como parece que deveria.
Pegue numa plataforma de pontuação profissional bem construída, com, digamos, mais de 100 indicadores distribuídos por cinco ou seis categorias nomeadas: rentabilidade, solidez financeira, crescimento, avaliação, momentum. Isso parece cinco ou seis opiniões independentes sobre uma empresa. Normalmente não é. Dentro de um único bloco de rentabilidade, a margem operacional, a margem líquida, o ROE, o ROA e o ROIC tendem a mover-se em conjunto para uma mesma empresa ao longo do tempo e através da maioria dos pares, porque são leituras aritméticas diferentes do mesmo motor subjacente de geração de caixa — um padrão documentado na literatura de análise fatorial de rácios financeiros há décadas (Pinches, Mingo & Caruthers, 1973; Chen & Shimerda, 1981). Quatro múltiplos de preço — P/E, P/S, EV/FCF, EV/EBITDA — são quatro denominadores diferentes para variações sobre o mesmo numerador: o preço de mercado atual. Ver os quatro "concordar" não são quatro confirmações independentes. É uma opinião, contada quatro vezes, o equivalente financeiro de perguntar a três médicos que estudaram todos pelo mesmo manual e estão todos a olhar para a mesma radiografia.
O próprio painel de oito fatores deste site não está isento desse escrutínio, e foi testado em vez de assumido: uma análise de componentes principais dessas mesmas oito métricas derivadas da SEC (ver Quantos Sinais Independentes? Uma Análise de Componentes Principais de um Modelo de Ações de 8 Fatores) verificou que se reduzem a quatro componentes empiricamente distintas — conversão de caixa, eficiência de capital, crescimento e qualidade dos accruals —, com um sinal limpo, quase solitário (o Sloan ratio) a atuar como a exceção precisamente porque mede algo que os outros sete não medem: se os resultados estão apoiados em caixa ou são fabricados por escolhas contabilísticas. Um painel mais pesado, com dezenas de rácios, comprime-se plausivelmente, pela mesma lógica, num punhado semelhante de fatores latentes, mais pelo menos uma camada adicional que um painel de fundamentais SEC puros não toca de todo — o preço de mercado atual e o seu momentum, matematicamente independente de qualquer rácio contabilístico porque, à partida, não deriva de dados contabilísticos. Se o conjunto completo de métricas de uma plataforma específica se reduz a quatro, cinco ou seis fatores é uma questão empírica sobre a própria matriz de correlações dessa plataforma, algo que este ensaio não está em posição de certificar a partir de fora — a afirmação honesta é mais estreita e ainda assim cumpre o seu papel: o número de categorias que uma interface mostra é uma taxonomia, não um resultado de análise fatorial, e as duas coisas são rotineiramente números diferentes.
O custo humano dessa lacuna é a verdadeira história. Perante vinte ou cem leituras simultâneas, quase nenhum investidor — mesmo um muito capaz — retém a matriz completa na memória de trabalho no momento de decidir. O que acontece em vez disso, de forma fiável, é uma substituição silenciosa: um ecrã amplo é percorrido rapidamente com o olhar, a maior parte é descartada sem que ninguém decida conscientemente descartá-la, e a decisão real é tomada sobre um ou dois eixos familiares — normalmente o crescimento, ou quanto o preço caiu — enquanto o investidor se lembra de ter "feito a análise completa". Entram vinte leituras. Sai uma decisão tomada com duas. As outras dezoito proporcionaram uma sensação de diligência, não informação adicional.
Uma comparação por pares, com fatores reduzidos, não resolve isto adicionando mais dados. Resolve-o recusando que colunas correlacionadas se façam passar por votos independentes, e tornando impossível ignorar o desacordo entre o punhado de sinais genuinamente independentes. No painel Amazon-contra-Walmart acima, o conflito não está enterrado na linha quarenta de uma folha de cálculo — é toda a estrutura da tabela: a eficiência de capital diz uma coisa, a conversão de caixa e o crescimento dizem outra, e o quase empate no agregado é a aritmética honesta desse desacordo, não uma média que o esconde. Essa é a segunda vantagem, distinta, face a um painel maior, separada do argumento do ruído comum acima e adicional a ele: a anulação do ruído torna a comparação honesta; a redução de fatores torna-a suficientemente pequena para que uma pessoa a consiga realmente ter em mente ao decidir.
O que isto realmente dá a um investidor
Nada do acima exige deitar fora os números absolutos. Exige não parar neles quando a questão do momento é A-versus-B. Em concreto, uma comparação relativa e com fatores reduzidos oferece:
- Uma variável de decisão que corresponde à decisão. Uma classificação sobre fatores declarados entre os dois candidatos, não uma pontuação global desligada da alternativa real em cima da mesa.
- Imunidade parcial a choques partilhados. Expansão de margens em todo o sector, um movimento de taxas comum, uma moda contabilística do sector — tudo isso se anula na mesma diferença que anula o atraso atmosférico no RTK.
- Trade-offs explícitos em vez de escondidos. Quando crescimento e conversão de caixa discordam de giro de capital e alavancagem, a comparação mostra o desacordo em vez de o transformar numa única média enganosamente suave.
- Um conjunto pequeno e defensável de eixos em vez de cem correlacionados. Quatro sinais independentes, não quarenta reformulações dos mesmos quatro.
- Auditabilidade. Cada dado remonta a um relatório específico da SEC e a uma regra de normalização publicada, não a uma mistura proprietária opaca.
Onde a DUEL se encaixa
A DUEL (duelstocks.com) é uma implementação operacional de tudo o que foi descrito acima, não o argumento em si. Constrói a camada relativa a partir de oito fatores derivados da SEC, aplica a mesma normalização suave a ambos os nomes de um par, expõe os pesos em vez de os esconder atrás de uma caixa negra, e permite que um utilizador reponere para crescimento, qualidade, valor ou rendimento sem recalcular nada à mão. Os mapas de posicionamento sectorial no mesmo site levam a mesma lógica de fatores reduzidos um passo mais além, colocando todo um grupo de pares em dois eixos construídos a partir dessa mesma estrutura de quatro componentes, em vez de rácios brutos e correlacionados. Nada disto é a afirmação de que uma única ferramenta esgota o método aqui descrito — é a lógica de identificação, anulação de ruído comum mais redução de fatores mais um contraste explícito por pares, que faz o trabalho. Outra ferramenta construída sobre os mesmos três princípios mereceria o mesmo argumento.
Objeções
"Preciso de um ROIC absoluto para o meu DCF." Sim — um nível alimenta um modelo de avaliação de um único nome ou uma visão de crédito. A comparação relativa alimenta a seleção e a classificação entre candidatos. São ferramentas diferentes para etapas diferentes do mesmo processo, não concorrentes.
"Se tudo é relativo, não há âncora." A âncora é o par explícito, ou o uso alternativo explícito do capital. O posicionamento RTK continua assente numa verdadeira rede geodésica de controlo — a medição relativa melhora a precisão entre dois pontos, não nega que cada ponto tenha uma localização.
"Posso simplesmente ordenar uma folha de cálculo por ROIC." Ordenar uma coluna é uma classificação absoluta de fator único. Não anula choques comuns, não pondera múltiplos fatores, e não diz se as colunas vizinhas são confirmações independentes ou o mesmo sinal contado quatro vezes.
"Comparar duas empresas é arbitrário — porquê exatamente estas duas?" Também o é definir qualquer universo para um screening absoluto. A disciplina consiste em escolher um par ou grupo de pares economicamente comparável e declarar os pesos abertamente, não em fingir que uma escala absoluta global é neutra quando carrega exatamente tantas escolhas implícitas.
Limitações
- Uma pontuação relativa não é uma previsão de retorno esperado. Nada neste texto afirma que o lado mais forte de uma comparação por pares terá melhor desempenho no futuro.
- Um par mal escolhido — duas empresas sem sobreposição económica real — produz um número de aparência precisa construído sobre ruído, o equivalente financeiro de uma fixação RTK sem satélites partilhados à vista.
- A identidade contabilística não é identidade económica. O Sloan ratio e os fatores de margem de caixa reduzem, mas não eliminam, o risco de qualidade dos resultados.
- A comparação relativa não substitui o dimensionamento de posições, a avaliação de liquidez, o preço pago ou a due diligence qualitativa.
- Qualquer afirmação de redução de fatores, incluindo o resultado de quatro componentes citado acima, é específica do conjunto de métricas e do período em que foi medida. Aplicar a mesma lógica aos rácios específicos de outra plataforma exige correr o mesmo teste nos dados próprios dessa plataforma, não assumir que o mesmo número se transfere.
- Os pesos por defeito representam um prior de especialista razoável, não um ótimo testado retrospetivamente; as próprias notas complementares da DUEL neste site são explícitas em dizer que a questão de calibração — que pesos preveem melhor os retornos futuros — permanece em aberto.
Conclusão
Um rácio absoluto mede um nível dentro de um referencial partilhado e ruidoso. Uma comparação relativa por pares mede um contraste, em que a parte partilhada desse ruído se anula por construção — a mesma aritmética que transforma uma fixação GPS errante de 10 metros num vetor RTK estável de 1 centímetro. Um painel de pontuação amplo acrescenta a ilusão adicional de que mais colunas significam mais informação, quando a maioria dessas colunas são reformulações de um pequeno número de sinais independentes, e a própria atenção do investidor acaba de qualquer forma por comprimir silenciosamente todo o painel a um ou dois eixos familiares no momento da decisão.
A solução não é mais dados. É um número menor de sinais independentes, comparados diretamente, deixando visível o desacordo entre eles em vez de o diluir até desaparecer. Para o investidor, isso é higiene intelectual, não uma nova descoberta: quando a questão do momento é Amazon contra Walmart, ou qualquer outra lista curta de dois, classifique a diferença nos fatores que realmente se movem de forma independente uns dos outros — não se limite a admirar qual dos dois nomes ultrapassa a barreira absoluta mais alta no único rácio que calhou olhar primeiro.
Referências
Hofmann-Wellenhof, B., Lichtenegger, H., & Wasle, E. (2008). GNSS – Global Navigation Satellite Systems: GPS, GLONASS, Galileo, and More. Springer.
Pinches, G. E., Mingo, K. A., & Caruthers, J. K. (1973). The Stability of Financial Patterns in Industrial Organizations. The Journal of Finance, 28(2), 389–396.
Chen, K. H., & Shimerda, T. A. (1981). An Empirical Analysis of Useful Financial Ratios. Financial Management, 10(1), 51–60.
Sloan, R. G. (1996). Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings? The Accounting Review, 71(3), 289–315.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3.ª ed.). Wiley.
DUEL Methodology: duelstocks.com/methodology
DuelStocks, "Quantos Sinais Independentes? Uma Análise de Componentes Principais de um Modelo de Ações de 8 Fatores".
Apenas para fins informativos e educativos. Não constitui aconselhamento de investimento. Dados contabilísticos passados não garantem resultados futuros. Verifique todos os números junto dos relatórios primários da SEC antes de tomar qualquer decisão.
Análise metodológica aprofundada, números reais de duelos reais, calculados e verificados do zero. Não constitui aconselhamento de investimento.
A nossa primeira nota sobre fragilidade analisava a DUEL sob a regra winner-take-all por fator: para cada um dos oito fatores derivados da SEC, o nome melhor classificado recebia todo o peso desse fator, o mais fraco nenhum, e a proximidade de um duelo reduzia-se a um único número claro, gap ÷ 2. Desde essa nota, o operador de scoring em produção da DUEL mudou. O site agora usa pontuações relativas suaves: cada fator é escalado pela dimensão do gap entre as duas empresas, não apenas pelo seu sinal. Essa mudança não se limita a comprimir os gaps de pontuação — altera a própria estrutura matemática do jogo de pontuação, o que significa que a questão da fragilidade tem de ser re-derivada, não apenas recalculada com números novos. Esta nota retoma os mesmos oito duelos da análise original, recalcula-os sob o algoritmo atual e coloca de novo as mesmas três perguntas, aos mesmos três níveis de rigor: quão próximo está cada duelo, a perturbação aleatória de pesos concorda com a álgebra, e o peso declarado de um fator corresponde de facto ao seu poder decisivo.
Nível 1: como o score funciona agora, e o que significa proximidade
Para cada fator, os valores brutos das duas empresas alimentam uma normalização suave: t = (a' − b') / (|a'| + |b'| + ε), depois N_a = 1/2 + 1/2·t e N_b = 1/2 − 1/2·t (ε é uma constante pequena que só importa quando ambos os valores são exatamente zero). O Sloan Ratio é invertido antes deste passo, já que aí menor é melhor. O score final é Score = 100 × Σ (peso × N) para cada lado, com os mesmos pesos por defeito de antes — Crescimento de receita 16%, Margem de caixa operacional 15%, ROIC 15%, Sloan Ratio 12%, Rotação de ativos 10%, Rotação de recebíveis 8%, Margem operacional 12%, Margem de FCF 12%. Recalculámos os oito scores a partir dos valores brutos atuais da SEC EDGAR, empresa a empresa; todos coincidiram com o score publicado no site em produção, dentro da margem de arredondamento.
| Duelo | Score (atual) | Score sob a antiga regra winner-take-all, mesmos dados |
|---|---|---|
| NVDA vs AMD | 67–33 | 80–20 |
| GOOGL vs META | 39–61 | 0–100 |
| AMZN vs WMT | 51–49 | 55–45 |
| CRM vs NOW | 54–46 | 59–41 |
| VRTX vs REGN | 57–43 | 61–39 |
| GFF vs WOR | 59–41 | 73–27 |
| BHE vs PLAB | 34–66 | 30–70 |
| KO vs PEP | 55–45 | 75–25 |
A coluna da direita não é o número que a nossa nota original publicou em agosto — esse número usava os filings da SEC de agosto. É um contrafactual com os mesmos dados: passámos os valores brutos atuais dos fatores pela regra winner-take-all já retirada, unicamente para isolar o efeito da própria mudança de operador, mantendo fixos os dados financeiros subjacentes. Nessa comparação controlada, o quadro é inequívoco: o vencedor é idêntico nos oito duelos. O que muda é a magnitude, não a direção. O gap absoluto médio neste painel de oito duelos cai de 43,3 pontos sob a regra antiga para 17,4 pontos sob soft scoring (mediana de 43,0 para 15,4) — grosso modo reduzido a metade, simplesmente como consequência de nenhum fator receber já a totalidade do seu peso com base numa vantagem estreita, por vezes quase impercetível.
Como o soft scoring é uma soma ponderada em vez de uma votação winner-take-all, a margem entre duas empresas decompõe-se de forma exata, sem necessidade de qualquer simulação: margem (em pontos) = 100 × Σ (peso_k × t_k), e cada termo é a contribuição exata em pontos desse único fator. Dois duelos ilustram o intervalo:
AMZN vs WMT (margem +2,4 pontos — o duelo mais apertado do painel): a margem de caixa operacional contribui com +8,8 pontos e a margem de FCF com +9,9 pontos a favor da Amazon; o Sloan Ratio contribui com uns plenos −12,0 pontos e a rotação de recebíveis com −6,2 pontos a favor da Walmart (a rotação de recebíveis da Walmart, de 64,4x contra 8,1x da Amazon, é o maior gap bruto de todo o painel). A margem final é o pequeno resto que sobra depois destas grandes contribuições fatoriais, em parte opostas — é exatamente por isso que este duelo é frágil, e é exatamente isso que um único número de gap esconde.
GOOGL vs META (margem −22,4 pontos): todos os oito fatores, sem exceção, favorecem a Meta. Essa é uma situação matematicamente distinta de um duelo como VRTX vs REGN, onde a Vertex lidera em cinco fatores e a Regeneron em três, mas o total da Vertex ainda assim vence por uns confortáveis +13,8 pontos. Um duelo em que um dos lados varre todos os fatores não pode ser invertido por nenhuma redistribuição de pesos não negativos, por mais extrema que seja — a margem é uma combinação convexa de oito números todos com o mesmo sinal, pelo que nenhum esquema de ponderação, por mais enviesado que esteja, consegue empurrar essa combinação para lá de zero. Três dos oito duelos deste painel são varreduras completas nesse sentido: GOOGL vs META, BHE vs PLAB, e CRM vs NOW não o é (CRM lidera em cinco fatores, NOW em três, daí a possibilidade de inversão explorada mais abaixo).
Nível 2: Monte Carlo — o acaso concorda com a álgebra?
Tal como na nota original, executámos 10.000 simulações por duelo, extraindo cada um dos oito pesos de forma independente e uniforme dentro de ±50% do seu valor por defeito, e depois renormalizando a extração para somar 100%. Como o soft scoring é contínuo, não precisamos de re-derivar a posição bruta de cada empresa em cada extração — os oito valores t_k de um dado duelo estão fixados pelos dados da SEC e não dependem em nada dos pesos; só a soma ponderada depende. Isso já é em si uma simplificação estrutural face ao antigo jogo winner-take-all, onde a "posse" de um fator por uma empresa já estava fixada e só o peso se movia, mas o ponto de inversão dependia do limiar, não de uma função contínua.
| Duelo | Margem | Taxa de inversão (10.000 extrações) |
|---|---|---|
| NVDA vs AMD | +34,6 | 0,00% |
| GOOGL vs META | −22,4 | 0,00% |
| AMZN vs WMT | +2,4 | 36,02% |
| CRM vs NOW | +8,0 | 1,22% |
| VRTX vs REGN | +13,8 | 0,00% |
| GFF vs WOR | +17,0 | 0,12% |
| BHE vs PLAB | −31,5 | 0,00% |
| KO vs PEP | +9,3 | 0,00% |
Seis dos oito duelos nunca se invertem em 10.000 extrações; a álgebra do Nível 1 já nos tinha dito que três desses seis não conseguem inverter-se sob nenhuma reponderação, e os outros três têm simplesmente margens suficientemente largas para que o ruído de ±50% nos pesos raramente as alcance. AMZN vs WMT é o valor atípico claro, invertendo-se em pouco mais de um terço das extrações — uma taxa de inversão nitidamente mais alta do que os 14,8% que medimos para o mesmo par sob o algoritmo antigo. Isso não é uma contradição; é o número mais honesto. Sob winner-take-all, o 55:45 da Amazon parecia uma almofada confortável de dez pontos. Sob soft scoring, os mesmos dados subjacentes produzem uma margem de 51,2:48,8, porque o winner-take-all dava à Amazon crédito total por fatores que vencia apenas por pouco (crescimento de receita, margem operacional), enquanto não dava nada à Walmart por fatores que perdia por margens enormes (rotação de recebíveis, Sloan Ratio) — um crédito assimétrico que inflacionava o gap aparente em ambas as direções antes de se compensarem. O soft scoring remove essa inflação, e o que resta é um duelo genuinamente apertado, o que o resultado de Monte Carlo confirma.
Observando especificamente qual fator tende a carregar o maior peso aleatório nas 3.602 extrações em que AMZN vs WMT se inverteu: o ROIC carrega o maior peso em 38,0% das inversões, o crescimento de receita em 27,3%, a margem de caixa operacional em 14,5%. Essa é uma resposta útil e concreta sobre qual fator está de facto a decidir aqui, distinta de perguntar apenas com que frequência ocorre uma inversão. CRM vs NOW inverte-se raramente (1,22%), mas quando acontece, o crescimento de receita é esmagadoramente o fator com o maior peso aleatório (88,5% das inversões) — nada surpreendente, dado que o CAGR de receita a três anos da ServiceNow, de 22,4% contra 9,8% da Salesforce, é o maior gap fatorial de todo o painel a jogar contra o vencedor base desse duelo.
Nível 3: o peso declarado de um fator equivale agora ao seu poder real?
O resultado mais estrutural da nota original usava o índice de Shapley-Shubik, uma ferramenta construída por Lloyd Shapley e Martin Shubik em 1954 para medir o poder de voto decisivo em jogos de maioria ponderada — a mesma matemática usada mais tarde para analisar o poder de voto no Conselho de Ministros da UE e no Conselho de Segurança da ONU. Sob winner-take-all, os oito fatores da DUEL formavam exatamente esse tipo de jogo: oito "eleitores", cada um com peso fixo, decidindo por maioria simples (mais de 50%) qual lado vence. Descobrimos que o peso declarado e o poder de Shapley-Shubik divergiam sistematicamente — o peso publicado de 8,0% da rotação de recebíveis carregava apenas 6,1% do poder decisivo real (um rácio de 0,76x), enquanto o peso de 16,0% do crescimento de receita carregava 18,2% do poder decisivo (1,14x). Os pesos menores valiam estruturalmente menos do que o seu número sugeria; os pesos maiores valiam mais. Essa divergência é uma propriedade matemática bem conhecida dos jogos de limiar maioritário, não uma falha específica desta ferramenta — qualquer sistema winner-take-all por fator com limiar de maioria herda-a.
O soft scoring elimina o limiar por completo. Já não há um ponto em que um lado ultrapassa os 50% e fica com tudo; o score é simplesmente Score = 100 × Σ (peso_k × N_k), uma função linear dos pesos. Isso reclassifica o jogo subjacente. Um jogo de maioria ponderada é aquilo a que os teóricos dos jogos chamam um jogo essencial — as coligações podem valer mais ou menos do que a soma das suas partes, o que é precisamente o que torna necessários e não triviais índices de poder de voto como Shapley-Shubik e Banzhaf. Uma soma puramente linear, sem limiar, é aquilo a que os teóricos dos jogos chamam um jogo inessencial (aditivo): o valor de qualquer coligação de fatores é exatamente a soma daquilo que cada fator contribui sozinho, sem qualquer efeito de interação entre fatores. O conceito original de valor de Shapley, de 1953, tem um corolário direto e bem conhecido para este caso: num jogo aditivo, o valor de Shapley de cada jogador equivale exatamente à contribuição individual desse jogador, pela simples razão de que adicionar o fator k a qualquer coligação — independentemente dos fatores já presentes, independentemente da ordem — altera o valor da coligação em exatamente peso_k × t_k, sempre. Quando uma contribuição marginal é constante em todas as coligações possíveis e todas as ordens possíveis, o valor de Shapley (uma média ponderada de contribuições marginais sobre todas as ordens) não tem nada para calcular a média — colapsa nessa constante.
Verificámos isto numericamente, em vez de nos limitarmos a citar o teorema. Para AMZN vs WMT, calculámos o valor de Shapley de cada um dos oito fatores por enumeração exaustiva de todas as 8! = 40.320 ordens possíveis:
| Fator | Contribuição exata em pontos (100 × peso × t) | Valor de Shapley, 40.320 ordens | Diferença |
|---|---|---|---|
| Crescimento de receita | +6,080 | +6,080 | menos de 1e-11 |
| Margem de caixa operacional | +8,829 | +8,829 | menos de 1e-11 |
| ROIC | −3,858 | −3,858 | menos de 1e-11 |
| Sloan Ratio | −12,000 | −12,000 | menos de 1e-11 |
| Rotação de ativos | −5,779 | −5,779 | menos de 1e-11 |
| Rotação de recebíveis | −6,204 | −6,204 | menos de 1e-11 |
| Margem operacional | +5,460 | +5,460 | menos de 1e-11 |
| Margem de FCF | +9,872 | +9,872 | menos de 1e-11 |
As duas colunas coincidem com precisão de vírgula flutuante, exatamente como a propriedade de aditividade prevê. Em termos práticos: o fosso entre peso e poder que o Nível 3 da nota original identificou como propriedade estrutural do winner-take-all — fatores menores como a rotação de recebíveis estruturalmente subponderados face à sua importância declarada — não existe sob soft scoring, para nenhum duelo, por construção. O peso publicado de um fator é agora, sempre, uma descrição exata e completa de quanta influência decisiva carrega nesse duelo; já não há um cálculo de poder separado a executar, porque peso e poder são o mesmo número pela estrutura do algoritmo, não por coincidência empírica.
Onde estes duelos se situam no mapa setorial
Os mapas de posicionamento setorial da DUEL, introduzidos no site após a publicação da nota original sobre fragilidade, colocam cada constituinte de um setor GICS em dois eixos — e os eixos não foram escolhidos ao acaso. São uma aplicação direta, ao produto, da nossa própria análise de componentes principais dos oito fatores da SEC (Quantos Sinais Independentes? Uma Análise de Componentes Principais de um Modelo de Ações de 8 Fatores), que constatou que os oito fatores se reduzem a quatro componentes empiricamente distintos: Conversão de Caixa (39% de peso nominal combinado), Eficiência de Capital (33%), Crescimento (16%) e Qualidade dos Accruals (12%). O mapa toma um fator representativo de cada componente e projeta os quatro em dois eixos legíveis. O eixo vertical é Quality-Adjusted Profitability: Y = Margem Operacional × m(Sloan), onde a Margem Operacional representa a Conversão de Caixa (a de maior carga entre os três fatores de margem dessa componente) e m(Sloan) é um multiplicador construído a partir do Sloan Ratio, o único fator da Qualidade dos Accruals — um Sloan Ratio positivo (resultados mais movidos a accruals) puxa Y para baixo, um negativo puxa-o para cima. O eixo horizontal é Growth Efficiency: X = Crescimento de Receita × (1 + 0,30 × z(Rotação de Ativos)), onde o Crescimento de Receita representa integralmente a componente Crescimento, e z(Rotação de Ativos) é o z-score setorial da rotação de ativos, representando a Eficiência de Capital. A Rotação de Ativos, e não o ROIC, foi escolhida como representante dessa componente: na PCA subjacente, a Rotação de Ativos carrega 0,60 na Eficiência de Capital face a 0,58 do ROIC, e o ROIC carrega ainda, de forma cruzada, 0,41 na Conversão de Caixa — o que o torna um representante mais ruidoso e menos exclusivo da eficiência de capital isoladamente, e redundante ao lado da Margem Operacional que já ancora o eixo Y. O próprio ROIC não figura em nenhum dos dois eixos; continua a ser um dos oito fatores dentro do score de duelo. Quatro dos nossos oito duelos caem em setores que o site atualmente mapeia.
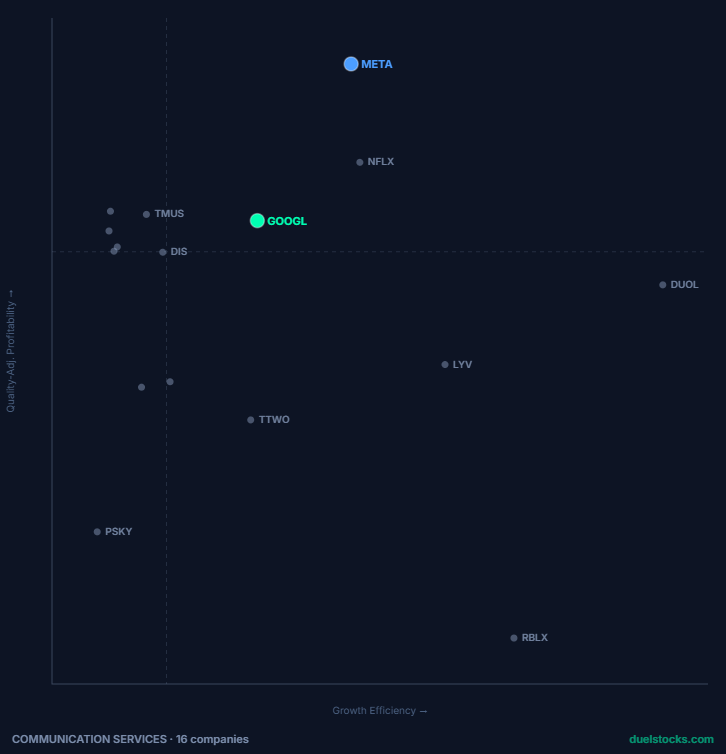
GOOGL e META são o único par neste painel em que o mapa setorial e o score de duelo contam, à primeira vista, histórias visivelmente diferentes. O score de duelo é a maior vitória estrutural da Meta no painel — uma varredura de oito fatores, impossível de inverter por qualquer reponderação. O mapa de posicionamento mostra, pelo contrário, os dois nomes próximos um do outro, perto do topo da nuvem de pares de Communication Services, ambos claramente acima da mediana setorial em ambos os eixos. Nenhuma das imagens está errada; respondem a perguntas diferentes. O score de duelo é uma comparação frente a frente limitada a estas duas empresas apenas; o mapa de posicionamento compara cada uma delas com os outros trinta e quatro constituintes do setor. A Meta vence a Google em todos os oito fatores, mas com margens por fator geralmente modestas (o Nível 1 acima mostra seis das oito contribuições em pontos abaixo de dois pontos) — suficiente para vencer um duelo a dois de forma limpa e varrê-lo algebricamente, não suficiente para separar visivelmente os dois nomes num mapa construído contra um conjunto de pares muito mais amplo. Uma varredura, por outras palavras, não é a mesma afirmação que uma goleada; significa apenas que um concorrente vence a mesma comparação seja qual for o ângulo.
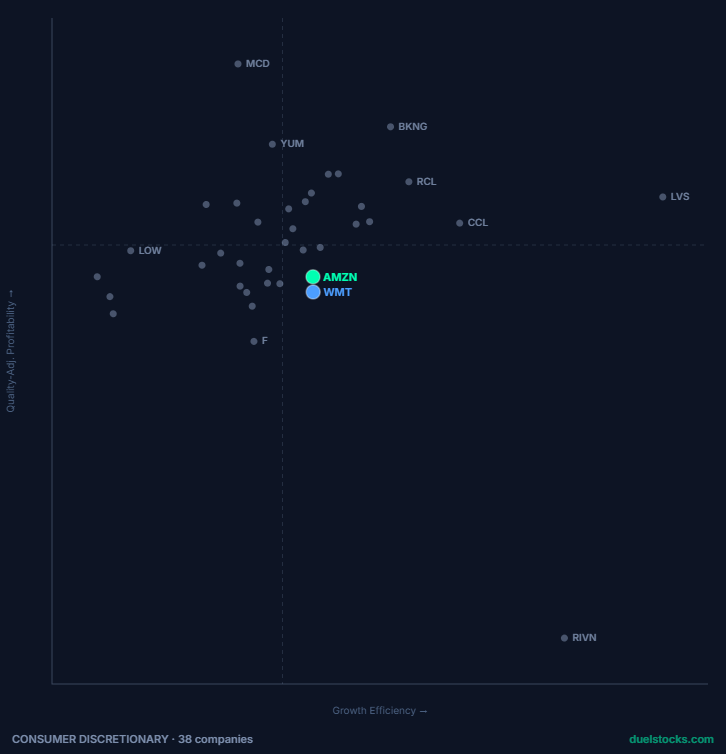
AMZN e WMT estão quase sobrepostas no mapa setorial, a cavalo da mesma fronteira de quadrante — visualmente o par mais próximo de qualquer duelo neste painel. Isso é totalmente consistente com tudo o que os Níveis 1 e 2 encontraram algebricamente: a menor margem do painel (+2,4 pontos), a maior taxa de inversão de Monte Carlo (36,02%) e um conjunto de contribuições fatoriais que na maioria se anulam em vez de se somarem. O mapa de posicionamento e a análise de fragilidade contam, para este par, através de dois métodos independentes, exatamente a mesma história.
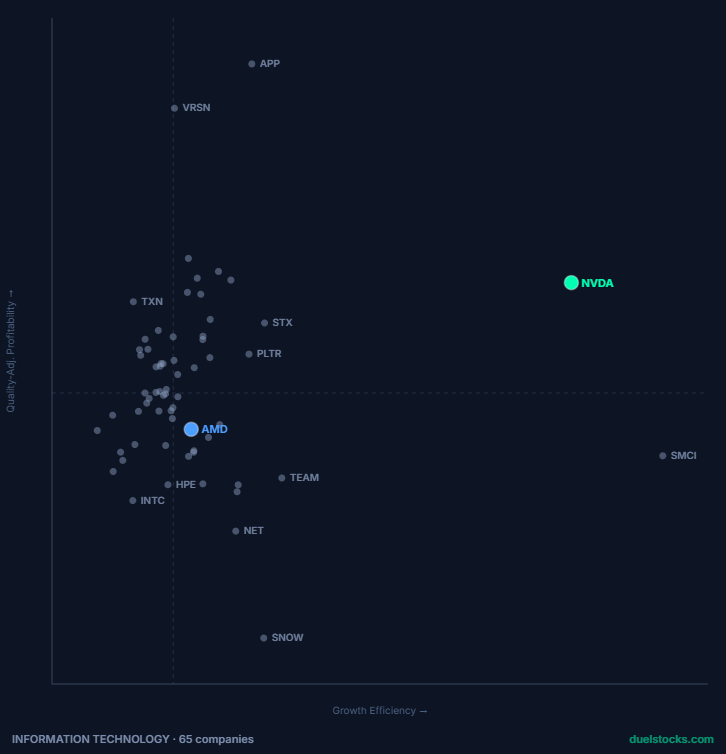
NVDA e AMD estão tão afastadas quanto duas empresas do mesmo setor podem estar. A NVDA situa-se sozinha, bem para a direita da nuvem em Growth Efficiency, confortavelmente acima da mediana em Quality-Adjusted Profitability; a AMD situa-se no aglomerado denso que atravessa ambas as medianas dos eixos, indistinguível à primeira vista de uma dúzia de outros nomes de segundo escalão. Esse fosso visual é a mesma história que o Nível 1 conta algebricamente: a maior margem de duelo individual do painel (+34,6 pontos), impulsionada por um CAGR de receita a três anos de 100,05%, que é, de longe, a maior cifra de crescimento bruto de todo este estudo. CRM e NOW, o outro duelo de Information Technology do painel, não são individualizados neste mapa, mas situam-se ambos dentro desse mesmo aglomerado central denso — consistente com uma margem real mas comparativamente modesta de +8,0 pontos e a segunda maior taxa de inversão do painel.
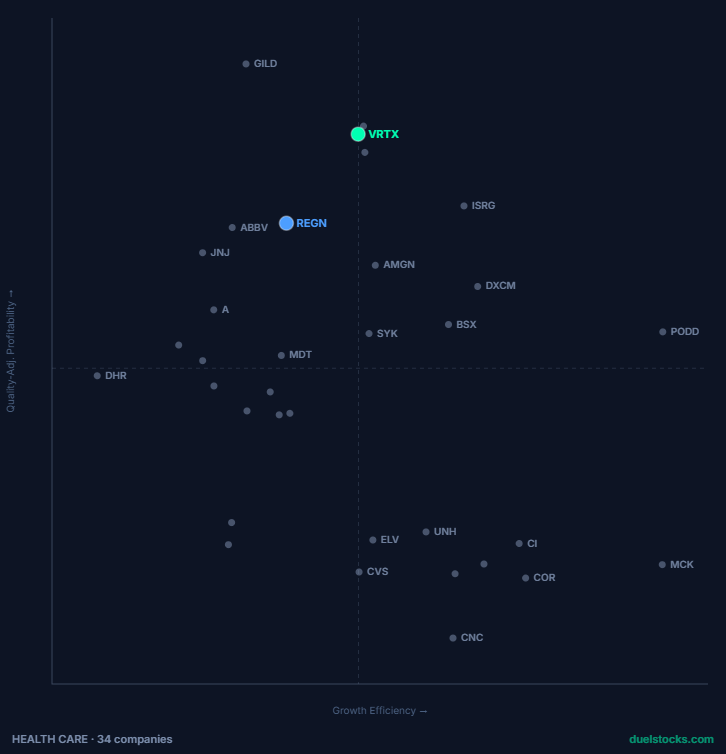
VRTX vs REGN é o duelo de Health Care do painel, e o mapa mostra as duas empresas próximas uma da outra no quadrante superior esquerdo — ambas claramente acima da mediana setorial em Quality-Adjusted Profitability, ambas do lado mais modesto de Growth Efficiency, com a Vertex posicionada ligeiramente mais acima e à direita da Regeneron. Essa separação modesta mas visível está alinhada com o que o score de duelo mostra diretamente: uma vantagem construída a partir do ROIC (+6,9 pontos) e da rotação de recebíveis (+3,5 pontos), grande o suficiente para sobreviver às vantagens da Regeneron em margem de caixa operacional e Sloan Ratio, produzindo uma margem moderada e confortavelmente não frágil de +13,8 pontos — zero inversões em 10.000 extrações de Monte Carlo. Duas empresas podem estar próximas uma da outra num mapa setorial de 34 nomes e, ainda assim, uma delas vencer de forma limpa um duelo a dois; o mapa responde "como se comparam ambas com o setor", o score de duelo responde "qual das duas é mais forte", e aqui ambas as respostas apontam, por coincidência, na mesma direção, sem serem a mesma medição.
O que esta atualização realmente resolve, e o que não resolve
A questão em aberto da nota original era se o esquema de pesos base — 16/15/15/12/10/8/12/12 — era frágil de uma forma relevante para o uso prático. Sob winner-take-all, descobrimos que não era, para qualquer duelo com um gap razoavelmente amplo, mas que o próprio mecanismo de votação subjacente precificava mal, sistematicamente, os fatores menores face aos maiores. Esta atualização responde a uma questão relacionada mas distinta: mudar a regra de agregação de uma votação maioritária para uma soma linear altera esse quadro? A resposta é sim, de duas formas distintas e independentemente verificadas. Primeiro: com dados idênticos, os dois operadores concordam quanto ao vencedor nos oito duelos deste painel — a mudança para soft scoring não reverteu silenciosamente nenhuma conclusão já publicada neste site, apenas substituiu margens inflacionadas por margens honestas. Segundo, e de forma mais estrutural: a patologia matemática específica que a nota original trouxe à luz — divergência peso-poder, fatores menores estruturalmente subponderados — não é apenas reduzida sob soft scoring, é eliminada por construção, porque a função de pontuação já não é o tipo de jogo em que essa patologia pode ocorrer. O que nem esta nota nem a original respondem é se 16/15/15/12/10/8/12/12 é o conjunto de pesos certo no sentido de prever rentabilidades futuras; essa questão de calibração permanece exatamente onde a nota original a deixou, em aberto, e é uma questão diferente da robustez.
Os mapas setoriais e o operador suave não são decisões de produto independentes entre si; ambos remontam a investigação publicada neste site. Os mapas assentam na estrutura de quatro componentes identificada pela nossa análise de componentes principais dos oito fatores da SEC — Conversão de Caixa, Eficiência de Capital, Crescimento, Qualidade dos Accruals —, com um fator representativo de cada componente a definir os dois eixos, de modo que uma estrutura empírica de 4 sinais é projetada numa nuvem de pares 2D legível sem inventar novos dados nem novos fatores. O soft scoring, por sua vez, é a resposta prática direta ao achado estrutural do estudo de fragilidade original: sob winner-take-all, o peso publicado e o poder decisivo divergiam sistematicamente. Substituir o jogo de limiar por uma soma linear elimina essa patologia por construção, como o Nível 3 acima verifica numericamente. Em ambos os casos a sequência de investigação seguiu o mesmo caminho — publicar primeiro a medição, e só depois mudar a ferramenta em produção onde a medição o justificasse.
Limitações
- Oito duelos, escolhidos para corresponder exatamente ao painel da nota original, não uma amostra aleatória ou representativa de todo o espaço de comparação da DUEL.
- Um único vintage de filing da SEC por empresa (snapshot datado de 19 de setembro de 2026); os resultados são condicionais a esse vintage e mudarão à medida que cheguem novos filings 10-Q e 10-K.
- A coluna winner-take-all contrafactual no Nível 1 é um recálculo com os mesmos dados para isolar o efeito do operador; não é o score histórico que o site mostrava em agosto, e não deve ser lida como uma reformulação desse número.
- A extração independente e renormalizada de ±50% nos pesos é um protocolo de perturbação razoável entre vários; corresponde à metodologia da nota original para permitir comparabilidade direta, mas não é a única escolha defensável.
- O argumento do valor de Shapley no Nível 3 é uma propriedade estrutural e algébrica de qualquer função de pontuação linear, aqui verificada num duelo por enumeração exaustiva; não requer reverificação duelo a duelo, aplica-se de forma idêntica aos oito, e a qualquer duelo executado neste algoritmo, por construção.
- Nada do exposto acima é uma previsão de rentabilidades, drawdowns ou revisões de analistas. É uma verificação de robustez e consistência sobre a forma como a comparação é calculada.
Referências
Shapley, L. S. (1953). "A Value for n-Person Games." Em Contributions to the Theory of Games II, Annals of Mathematics Studies 28, Princeton University Press, 307–317.
Shapley, L. S., & Shubik, M. (1954). "A Method for Evaluating the Distribution of Power in a Committee System." American Political Science Review, 48(3), 787–792.
Banzhaf, J. F. (1965). "Weighted Voting Doesn't Work: A Mathematical Analysis." Rutgers Law Review, 19, 317–343.
Sloan, R. G. (1996). "Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings?" The Accounting Review, 71(3), 289–315.
Saaty, T. L. (1980). The Analytic Hierarchy Process. McGraw-Hill.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3.ª ed.). Wiley.
DUEL Methodology: duelstocks.com/methodology
DuelStocks, "Quantos Sinais Independentes? Uma Análise de Componentes Principais de um Modelo de Ações de 8 Fatores" (duelstocks.substack.com).
Se quiser verificar tudo isto por conta própria — aplicar os seus próprios pesos, ou testar um par que não cobrimos — a ferramenta ao vivo pode ser experimentada gratuitamente em duelstocks.com; cada número desta nota remonta a um relatório que pode consultar diretamente aí.
Não constitui aconselhamento de investimento. Todos os dados provêm de filings públicos da SEC EDGAR.
Uma análise aprofundada de fundamentos da DuelStocks. Não é aconselhamento de investimento e, como o restante desta série, também não é uma previsão. Todos os números abaixo vêm de documentos públicos protocolados na SEC EDGAR (10-K/10-Q), processados pelos relatórios Battle, DCF e Resilience (STR) da DUEL.
Toda história de crescimento acaba recebendo a mesma pergunta: o crescimento está realmente se transformando em caixa, ou está se transformando em algo que só parece caixa na demonstração de resultados? Este artigo não é sobre IA, não é sobre um único setor, e não é sobre uma única empresa. É um filtro de propósito geral — construído uma vez, reutilizável em qualquer ciclo de crescimento futuro — para um padrão específico: receita crescendo em ritmo saudável enquanto o caixa que esse crescimento gera diverge do lucro contábil que deveria representar.
Este é uma extensão metodológica direta de três artigos anteriores desta série. A abordagem de construção da cesta segue [Quantos Sinais Independentes? Uma Análise de Componentes Principais]. O enquadramento de taxa base, incluindo a disciplina do intervalo de Wilson e da contagem mínima de Cochran, segue [O Sinal de que Ninguém Fala]. E a lógica subjacente de qualidade de accruals — que o crescimento de receita superando a geração de caixa é um padrão clássico de alerta precoce — vem de Sloan (1996), o mesmo artigo que fundamenta o próprio Índice de Sloan da DUEL.
Em uma cesta multissetorial de 72 empresas, onde o crescimento de receita de 3 anos permanece forte enquanto a margem operacional e a margem de FCF já divergem — e o próprio Índice de Sloan da DUEL concorda com essa divergência?
Parte 1 — Montando a Cesta
A cesta é composta por 72 empresas distribuídas em cinco setores:
- Tecnologia / Semicondutores / Software (22): AAPL, AMD, AVGO, CRM, GOOGL, META, MSFT, INTC, KLAC, LRCX, MCHP, MU, NFLX, NOW, NVDA, PLTR, QCOM, SNDK, SNPS, STX, TXN, XYZ
- Industriais (12): CAT, DE, F, FDX, GM, LMT, RTX, UPS, LIN, SHW, GE, HON
- Saúde (11): AMGN, BDX, BMY, ISRG, REGN, VRTX, JNJ, PFE, ABT, MDT, DHR
- Consumo / Varejo / Bens de Consumo Básico / Telecomunicações (22): AMZN, CCL, CL, COST, DIS, HD, HSY, KO, LOW, MDLZ, MO, PEP, PG, PM, RCL, ROST, TJX, TMUS, VZ, WMT, MCD, NKE
- Energia (5): COP, OXY, XOM, CVX, SLB
Cada empresa protocola 10-K/10-Q junto à SEC e é processada pelo pipeline padrão da DUEL. Ambos os filtros abaixo são construídos inteiramente a partir dos quatro campos disponíveis em toda essa cesta — crescimento de receita, margem operacional, margem de FCF e Índice de Sloan —, o que é exatamente o que torna possível uma comparação uniforme entre 72 empresas.
Parte 2 — Dois Filtros de Estresse Independentes
"Crescimento superando o caixa" não é uma coisa só — pode se manifestar como lucro operacional reportado correndo bem à frente do fluxo de caixa livre real, ou como acúmulo de accruals suficientemente severo para disparar a própria medida de qualidade de accruals de Sloan, e uma empresa pode mostrar um sinal sem o outro. Aplicamos dois filtros separados, definidos de forma independente, em cada empresa com CAGR de receita de 3 anos ≥ 5%:
Filtro A — Gap de Conversão de Caixa: Margem Operacional menos Margem de FCF ≥ 10 pontos percentuais. Isso pergunta se a própria rentabilidade operacional reportada de uma empresa está superando de forma significativa o caixa que essa rentabilidade está produzindo, independentemente de a margem de FCF em si parecer saudável isoladamente.
Filtro B — Índice de Sloan Elevado: Índice de Sloan > 5%, o próprio limite da DUEL para "accruals moderados detectados". Isso pergunta se o próprio lucro líquido está sendo construído mais a partir de accruals do que de fluxo de caixa operacional — um sinal diferente, de estágio mais precoce, do que o gap de margem do Filtro A.
Das 72 empresas, 34 (47%) mostram crescimento de receita de 3 anos de 5% ou mais. Ambos os filtros são aplicados apenas dentro desse grupo de alto crescimento — uma empresa com receita estável ou em declínio mostrando um amplo gap entre margem e caixa é uma história diferente, mais mundana (frequentemente apenas um item cíclico ou pontual) do que o mesmo gap aparecendo ao lado de crescimento real.
Parte 3 — Filtro A: Quem Está Crescendo Mais Rápido do que Converte em Caixa
| Ticker | Setor | Cresc. Receita (CAGR 3A) | Margem Oper. | Margem FCF | Gap (pp) | Índice de Sloan | Giro Recebíveis | FRI |
|---|---|---|---|---|---|---|---|---|
| MU | Tecnologia/Semicondutores/Software | 6,71% | 26,14% | 4,46% | 21,7 | 36,86% | 1,39x | 76 (ALTA) |
| RCL | Consumo/Varejo/Bens de Consumo Básico/Telecomunicações | 26,59% | 27,38% | 6,89% | 20,5 | -11,90% | 37,44x | 42 (MODERADA) |
| MSFT | Tecnologia/Semicondutores/Software | 12,42% | 45,62% | 25,42% | 20,2 | 6,70% | 4,69x | 81 (ALTA) |
| MCD | Consumo/Varejo/Bens de Consumo Básico/Telecomunicações | 5,06% | 46,10% | 26,73% | 19,4 | -7,61% | — | 43 (MODERADA) |
| META | Tecnologia/Semicondutores/Software | 19,89% | 41,44% | 22,94% | 18,5 | -14,00% | 11,50x | 83 (ALTA) |
| GOOGL | Tecnologia/Semicondutores/Software | 12,51% | 32,03% | 18,19% | 13,8 | 16,91% | 5,82x | 85 (ALTA) |
| NVDA | Tecnologia/Semicondutores/Software | 100,05% | 60,38% | 47,50% | 12,9 | -6,92% | 5,30x | 64 (MODERADA) |
| PM | Consumo/Varejo/Bens de Consumo Básico/Telecomunicações | 8,57% | 36,64% | 26,23% | 10,4 | -10,25% | 7,85x | 49 (MODERADA) |
Oito das 34 empresas de alto crescimento (23,5%, IC 95% de Wilson [12,4%, 40,0%]) mostram um gap de conversão de caixa de 10 pontos ou mais. O maior gap individual em toda a cesta de 72 empresas pertence à MU, com 21,7 pontos — e a MU também carrega o maior Índice de Sloan da cesta (36,86%) e, com 1,39x, o segundo Giro de Recebíveis mais lento entre as 66 empresas com esse campo disponível (apenas a AVGO, com 0,36x, é mais lenta) — três sinais independentes vindos de três partes diferentes dos mesmos protocolos, todos apontando na mesma direção. Cinco dos oito nomes sinalizados são empresas de Tecnologia/Semicondutores/Software; os outros três abrangem nomes de Consumo com negócios muito diferentes (uma empresa de cruzeiros, uma franqueadora de fast-food, uma tabagista) — um lembrete de que esse padrão não é específico de setor, mesmo que se concentre de forma desigual.
Parte 4 — O Gap Se Concentra por Setor? Uma Verificação de Taxa Base
| Setor | Alto crescimento, ambas as margens disponíveis | Gap ≥ 10pp | Taxa | IC 95% de Wilson |
|---|---|---|---|---|
| Tecnologia/Semicondutores/Software | 15 | 5 | 33,3% | [15,2%, 58,3%] |
| Consumo/Varejo/Bens de Consumo Básico/Telecomunicações | 10 | 3 | 30,0% | [10,8%, 60,3%] |
| Industriais | 3 | 0 | 0,0% | [0,0%, 56,2%] |
| Saúde | 5 | 0 | 0,0% | [0,0%, 43,4%] |
| Energia | 1 | 0 | 0,0% | [0,0%, 79,3%] |
Seguindo a mesma disciplina de nosso artigo anterior sobre taxa base: a regra prática de Cochran (1977) exige pelo menos 5 eventos observados para uma estimativa de taxa estável, e apenas Tecnologia/Semicondutores/Software supera claramente essa barra neste corte, com Consumo/Varejo/Bens de Consumo Básico/Telecomunicações logo atrás. Industriais, Saúde e Energia têm, cada um, poucos nomes de alto crescimento nesta cesta para sustentar qualquer alegação de taxa; suas leituras de 0% refletem denominadores pequenos (3, 5 e 1 empresas, respectivamente), não uma ausência demonstrada do padrão nesses setores. Os amplos intervalos de confiança sobrepostos em cada setor são a descoberta honesta aqui: com esse tamanho de cesta, ainda não podemos afirmar que o gap de conversão de caixa seja um fenômeno específico de Tecnologia — apenas que é visível com frequência suficiente em Tecnologia e Consumo para ser medido, e ainda não mensurável em outros lugares.
Parte 5 — Filtro B: Índice de Sloan Elevado entre os Nomes de Alto Crescimento
| Ticker | Setor | Cresc. Receita (CAGR 3A) | Índice de Sloan | Giro Recebíveis | FRI | Sinal ROIC-vs-Sloan da DUEL |
|---|---|---|---|---|---|---|
| MU | Tecnologia/Semicondutores/Software | 6,71% | 36,86% | 1,39x | 76 (ALTA) | OK |
| SNDK | Tecnologia/Semicondutores/Software | 6,52% | 27,58% | 2,70x | 33 (BAIXA) | OK |
| GOOGL | Tecnologia/Semicondutores/Software | 12,51% | 16,91% | 5,82x | 85 (ALTA) | OK |
| AMZN | Consumo/Varejo/Bens de Consumo Básico/Telecomunicações | 11,73% | 13,01% | 9,49x | 100 (ALTA) | OK |
| NOW | Tecnologia/Semicondutores/Software | 22,38% | 7,67% | 6,03x | 88 (ALTA) | OK |
| MSFT | Tecnologia/Semicondutores/Software | 12,42% | 6,70% | 4,69x | 81 (ALTA) | ATENÇÃO |
Seis das 34 empresas de alto crescimento (17,6%) carregam um Índice de Sloan acima de 5%. Cinco das seis estão especificamente em Tecnologia/Semicondutores/Software. Apenas uma das seis — a MSFT — de fato dispara a verificação de consistência ROIC-vs-Sloan própria da DUEL; as outras cinco, incluindo a MU com, de longe, o maior Índice de Sloan de toda a cesta, são lidas como OK nessa verificação interna específica, porque o sinal ROIC-vs-Sloan da DUEL é disparado pela combinação de um ROIC alto ao lado do Índice de Sloan elevado, não pelo Índice de Sloan isoladamente. O próprio ROIC da MU nesta fotografia não ultrapassa o limite que se combinaria com seu Índice de Sloan para disparar o sinal — um lembrete de que ler o Índice de Sloan diretamente, em vez de apenas seu sinal derivado, revela casos que o próprio sinal não mostra.
Três empresas — MU, MSFT e GOOGL — aparecem tanto no Filtro A quanto no Filtro B: um gap real entre margem e caixa e um Índice de Sloan elevado, derivados de forma independente de partes diferentes dos mesmos protocolos, apontando para a mesma história subjacente. Essa sobreposição, mais do que qualquer um dos filtros isoladamente, é o sinal mais forte desta cesta.
Parte 6 — Duas Verificações, Duas Perguntas: Crescimento-vs-FCF Contra um Filtro de Gap de Margem
A verificação de consistência Crescimento-vs-FCF integrada da DUEL e o Filtro A são ambas leituras legítimas dos mesmos protocolos, e elas discordam amplamente nesta cesta: o próprio sinal da DUEL é lido como OK em sete das oito empresas identificadas pelo Filtro A, incluindo a MU, que carrega o maior gap e o maior Índice de Sloan de toda a cesta. Apenas a RCL dispara ambas as verificações ao mesmo tempo.
Essa discordância é uma característica do que cada verificação foi construída para medir, não um defeito em nenhuma das duas. O sinal Crescimento-vs-FCF da DUEL, a julgar pela redação de suas próprias mensagens de conflito ("Crescimento de receita 18,6%, margem de FCF 5,7%: Monitorar a conversão de caixa"), parece calibrado para capturar empresas cuja margem de FCF é baixa em termos absolutos ao lado de alto crescimento — ele pergunta "esta empresa mal gera caixa apesar de crescer rápido?". O Filtro A faz uma pergunta mais estreita, autorreferencial: "o próprio lucro operacional reportado desta empresa está correndo bem à frente de sua própria geração de caixa?". Uma empresa pode ter uma margem de FCF de dois dígitos perfeitamente respeitável — os 25,42% da MSFT são um número forte isoladamente — e ainda assim mostrar um gap real em relação à sua própria margem operacional de 45,62%. Um sinal calibrado para a margem de FCF absoluta não tem motivo para disparar em uma empresa cuja margem de FCF parece boa por si só; um filtro que compara uma empresa apenas com ela mesma captura uma fatia diferente e complementar da mesma pergunta subjacente. Esta cesta é uma ilustração concreta de o quanto a própria definição de uma verificação determina o que ela encontra — a mesma lição que nosso artigo anterior sobre Fragile Score demonstrou para os pesos de classificação.
Parte 7 — O Que Isso Realmente Responde, e O Que Não Responde
Este artigo não diz, e não pode dizer, que o crescimento de qualquer empresa sinalizada seja de baixa qualidade, que sua ação esteja sobrevalorizada, ou que sua conversão de caixa vá se deteriorar ainda mais. Um amplo gap entre margem operacional e margem de FCF pode refletir o timing do capital de giro, CAPEX elevado durante uma fase genuína de investimento em crescimento, mecânica de receita diferida, ou simplesmente estrutura contábil — não necessariamente um problema. O que este artigo de fato mostra, de forma direta e reproduzível: em 72 empresas de cinco setores, um padrão específico e mensurável — alto crescimento de receita combinado com um grande gap entre a rentabilidade operacional reportada e a geração de caixa real, ou com acúmulo de accruals suficientemente severo para mover o próprio índice de Sloan — está presente em aproximadamente um quarto das empresas de alto crescimento desta cesta, concentrado em, mas não exclusivo de, Tecnologia/Semicondutores/Software, e amplamente invisível para uma das verificações de consistência integradas da própria DUEL, precisamente porque essa verificação é calibrada para capturar um sinal relacionado, mas diferente.
Limitações
Ambos os filtros usam um corte transversal uniforme, em nível de DCF, disponível em toda a cesta — crescimento de receita, margem operacional, margem de FCF e Índice de Sloan. Outros fatores do Battle Report, incluindo o Giro de Recebíveis, estão fora da definição desses dois filtros; onde o Giro de Recebíveis aparece nas Partes 3 e 5, é contexto descritivo ao lado dos nomes sinalizados, não parte dos critérios de aprovação/reprovação de nenhum dos dois filtros.
Os limites de 10 pontos percentuais de gap e 5% de Sloan são convenções construídas, não constantes universais. Um limite de gap mais rígido ou mais frouxo moveria empresas para dentro e fora do Filtro A; o mesmo vale para o corte de Sloan no Filtro B. Escolhemos números redondos e defensáveis em vez de otimizar limites para produzir um resultado específico, mas escolhas razoáveis diferentes deslocariam a lista específica de empresas sem alterar o padrão setorial mais amplo.
Três dos cinco setores têm poucas empresas de alto crescimento nesta cesta para sustentar uma alegação de taxa base, segundo a orientação de contagem mínima de Cochran (1977) — Industriais (3), Saúde (5) e Energia (1). Suas leituras de 0% na Parte 4 descrevem esta cesta, não uma ausência demonstrada do padrão nesses setores em um sentido mais amplo.
O FRI não é exibido quando o relatório de Resiliência não fez parte dos campos pontuados desta cesta para uma determinada empresa; ambos os filtros não são afetados, já que nenhum depende do FRI.
Esta é uma fotografia de um único período de protocolo que abrange várias semanas, não uma cesta longitudinal ou consistente em um ponto no tempo. O perfil de crescimento versus caixa de uma empresa pode mudar, e de fato muda, de um protocolo trimestral para o outro.
Setenta e duas empresas são uma cesta diagnóstica, não uma amostra aleatória ou representativa do mercado listado nos EUA — leia as taxas base setoriais da Parte 4 como descritivas desta cesta, não como estimativas em nível populacional.
Conclusão
Em uma cesta de cinco setores e 72 empresas, aproximadamente um quarto das empresas de alto crescimento mostra rentabilidade operacional reportada correndo significativamente à frente da geração de caixa real, e cerca de uma em seis mostra acúmulo de accruals suficientemente severo para mover seu próprio Índice de Sloan — com três empresas disparando ambos os sinais de forma independente, e uma dessas três (a MU) também ficando perto da base de toda a cesta em Giro de Recebíveis. O padrão se concentra em Tecnologia/Semicondutores/Software e, em menor grau, em Consumo, embora a cesta seja pequena demais nos outros três setores para dizer se essa concentração é real ou um artefato desta cesta específica. E, crucialmente, a maioria das empresas que este filtro sinaliza passa de forma limpa pela própria verificação Crescimento-vs-FCF integrada da DUEL — não porque uma das duas verificações esteja quebrada, mas porque foram construídas para capturar coisas diferentes. Nada disso é um sinal para agir. É um detector, construído uma vez a partir de protocolos públicos e uma fórmula documentada, projetado para ser executado novamente sobre qualquer setor que reivindique o próximo ciclo de crescimento.
Cada número deste artigo remete a um duelo que você mesmo pode consultar e reverificar em duelstocks.com.
Leituras Adicionais — Mesma Série, Mesmo Método
Este artigo estende a metodologia de construção de cesta e taxa base estabelecida nos artigos anteriores desta série, que você pode conferir logo abaixo, aqui no site.
Referências
Sloan, R. G. (1996). Do stock prices fully reflect information in accruals and cash flows about future earnings? The Accounting Review, 71(3), 289–315.
Dechow, P. M., Ge, W., Larson, C. R., & Sloan, R. G. (2011). Predicting material accounting misstatements. Contemporary Accounting Research, 28(1), 17–82.
Cochran, W. G. (1977). Sampling Techniques (3ª ed.). Wiley.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3ª ed.). Wiley.
U.S. Securities and Exchange Commission — Busca de texto completo do EDGAR e dados estruturados de protocolo XBRL, sec.gov.
Uma análise aprofundada de metodologia da DuelStocks. Não é aconselhamento de investimento. Todos os dados provêm de documentos públicos protocolados na SEC EDGAR.
Uma análise aprofundada de fundamentos da DuelStocks. Não é aconselhamento de investimento e, como o restante desta série, também não é uma previsão. Todos os números abaixo vêm de documentos públicos protocolados na SEC EDGAR (10-K/10-Q), processados pelos relatórios Battle, DCF e Resilience (STR) da DUEL.
Todo chip na construção de IA precisa ser fabricado por algo, e esse "algo" é um oligopólio genuíno: um pequeno punhado de empresas das quais os próprios fabricantes de chips dependem. Este artigo permanece dentro desse oligopólio — AMAT, LRCX, KLAC, TER e ONTO — e faz uma pergunta mais restrita e precisa do que os artigos de infraestrutura mais amplos desta série: dentro de um grupo de cinco empresas que já parece forte no papel, quem realmente se destaca ao comparar sistematicamente, e o quanto a resposta depende de como se escolhe ponderar a comparação?
Dentro do círculo restrito de fornecedores listados de equipamentos de capital para semicondutores, quem vence uma comparação relativa completa todos-contra-todos, quem tem o maior potencial de valorização modelado apesar de margens já altas, e a resiliência coincide com o líder "óbvio" do ciclo — ou a própria classificação oscila dependendo de como a pontuação é ponderada?
Parte 1 — Montando a Cesta, e uma Correção que Vale a Pena Mencionar
A cesta é composta por cinco empresas: AMAT (Applied Materials), LRCX (Lam Research), KLAC (KLA Corporation), TER (Teradyne) e ONTO (Onto Innovation). Todas as cinco protocolam 10-K/10-Q junto à SEC e são lidas de forma limpa pelo pipeline da DUEL.
Este artigo foi originalmente planejado em torno de um torneio completo de dez duelos todos-contra-todos — cada uma das cinco empresas comparada com cada uma das outras —, espelhando o método usado em nosso artigo anterior [Além do Par]. Isso acabou sendo mais coleta de dados do que a pergunta realmente exigia. A própria metodologia da DUEL publica abertamente sua fórmula de pontuação: Pontuação = Σ(Wᵢ × Nᵢ) × 100, onde Wᵢ é o peso fixo de cada fator e Nᵢ é uma simples marca de vitória/derrota/empate (1, 0 ou 0,5) para aquele fator entre exatamente duas empresas. Como os próprios valores brutos dos fatores — crescimento de receita, margens, ROIC, Índice de Sloan, índices de giro — são independentes do oponente (a mesma verificação de validade confirmada com a MU em nosso primeiro artigo e aqui com a LRCX, veja a Parte 3), o histórico completo todos-contra-todos de uma empresa em relação a cada uma das outras na cesta pode ser reconstruído analiticamente a partir das tabelas de fatores brutos. Precisávamos apenas de duelos suficientes para ver os números brutos de cada empresa uma vez, não dez confrontos diretos. Dois novos duelos — AMAT vs. TER e ONTO vs. LRCX — forneceram as três empresas ainda não cobertas por um duelo anterior LRCX vs. KLAC de 26 de julho de 2026, e todo outro pareamento neste artigo é calculado diretamente a partir das entradas divulgadas desses quatro duelos, usando a própria fórmula publicada da DUEL.
Uma consequência de reconstruir a matriz dessa forma vale a pena mencionar imediatamente: isso exige a tabela completa de oito fatores do Battle Report (Crescimento de Receita, Margem de Caixa Operacional, ROIC, Índice de Sloan, Giro de Ativos, Giro de Recebíveis, Margem Operacional, Margem de FCF) para cada empresa, e o duelo LRCX vs. KLAC de 26 de julho nos deu apenas os cinco insumos do modelo DCF da KLAC, não seu Giro de Ativos ou Giro de Recebíveis. A KLAC, portanto, aparece ao longo das seções de DCF e Resiliência deste artigo, mas é excluída da matriz de torneio todos-contra-todos reconstruída na Parte 3, onde tínhamos dados completos apenas para quatro das cinco empresas. Preferimos declarar essa lacuna claramente a aproximar dois dos oito fatores ponderados.
Uma segunda coisa que vale a pena mencionar de antemão: os números da LRCX aqui vêm de uma fotografia de protocolo de 18 de agosto de 2026, enquanto os da KLAC são de 26 de julho de 2026 — e os próprios números da LRCX se moveram substancialmente entre essas datas (crescimento de receita 2,29% → 10,06%, ROIC 42,54% → 53,69% no próprio histórico de duelos da DUEL), provavelmente refletindo um novo protocolo trimestral chegando nesse intervalo. Usamos a fotografia mais recente da LRCX ao longo do artigo e anotamos a diferença de datas em vez de misturar dois períodos de protocolo diferentes.
Parte 2 — O Placar de Oito Fatores
| Ticker | Cresc. Receita (CAGR 3A) | Margem Caixa Oper. | ROIC | Índice de Sloan | Giro Ativos | Giro Recebíveis | Margem Operacional | Margem FCF |
|---|---|---|---|---|---|---|---|---|
| AMAT | 3,23% | 28,05% | 25,84% | -3,44% | 0,70x | 4,45x | 29,22% | 20,09% |
| TER | 0,37% | 21,14% | 15,79% | 8,89% | 0,65x | 2,87x | 20,38% | 14,12% |
| ONTO | 0,00% | 32,66% | 14,89% | 2,93% | 0,27x | 2,98x | 13,22% | 29,82% |
| LRCX | 10,06% | 25,21% | 53,69% | 9,90% | 0,99x | 4,35x | 35,29% | 21,24% |
| KLAC* | 9,69% | n/d | 5,42% | 2,39% | n/d | n/d | 6,35% | 30,82% |
*Os números da KLAC vêm de um duelo de 26 de julho de 2026 e estão incompletos — Margem de Caixa Operacional, Giro de Ativos e Giro de Recebíveis não fizeram parte do resultado capturado daquele duelo. A Margem Operacional da KLAC (6,35%) e seu ROIC (5,42%) também parecem anomalamente baixos em relação à faixa histórica típica desta empresa e à sua própria margem de FCF de 30,82% na mesma fotografia; isso tem a marca de um artefato de desalinhamento de período (os próprios Battle Reports do site advertem que misturar campos trimestrais e anuais pode produzir exatamente esse tipo de incompatibilidade) em vez de uma deterioração operacional genuína. Reportamos o número como gerado e o sinalizamos em vez de corrigi-lo silenciosamente.
Nenhuma empresa vence em todos os fatores, exceto em um confronto específico (veja a Parte 3). A LRCX registra, com larga margem, o ROIC mais forte (53,69%) e a Margem Operacional mais forte (35,29%) do grupo, mas também o Índice de Sloan mais alto (9,90%) — o sinal de qualidade de accruals que o próprio Resilience Report da DUEL capta diretamente na Parte 5. A ONTO tem a menor base de receita e crescimento histórico essencialmente estável (0,00%), mas a segunda maior margem de FCF (29,82%) e o menor Giro de Ativos (0,27x) da cesta — uma empresa convertendo uma base de ativos pequena e de baixo giro em caixa de forma incomumente eficiente. AMAT e TER ficam no meio na maioria dos fatores, com a AMAT à frente da TER em todos os oito.
Parte 3 — O Todos-Contra-Todos: Quem Realmente Vence Cara a Cara
Reconstruir cada pareamento entre as quatro empresas com dados completos, usando a própria fórmula publicada da DUEL, produz um torneio todos-contra-todos completo de seis confrontos:
| Confronto | Pontuação | Vencedor |
|---|---|---|
| AMAT vs. TER | 100 — 0 | AMAT (varredura — os 8 fatores) |
| AMAT vs. ONTO | 73 — 27 | AMAT |
| TER vs. ONTO | 53 — 47 | TER |
| AMAT vs. LRCX | 35 — 65 | LRCX |
| TER vs. LRCX | 12 — 88 | LRCX |
| ONTO vs. LRCX | 39 — 61 | LRCX (confirmado diretamente pela DUEL) |
A LRCX vence todos os seus três confrontos; a AMAT vence dois de três (perdendo apenas para a LRCX); TER e ONTO dividem seu único confronto direto, com a vitória da TER sendo o resultado mais apertado de toda a tabela. Calculando a média da pontuação de cada empresa em seus três confrontos, obtém-se uma classificação composta:
| Posição | Ticker | Pontuação Méd. |
|---|---|---|
| 1 | LRCX | 71,3 |
| 2 | AMAT | 69,3 |
| 3 | ONTO | 37,7 |
| 4 | TER | 21,7 |
A LRCX supera a AMAT pelo primeiro lugar com uma margem média de dois pontos — fina o suficiente para que a Parte 6 teste se isso sobrevive a uma mudança razoável em como os oito fatores são ponderados.
Parte 4 — Quanto Crescimento Já Está no Preço
O motor de DCF da DUEL constrói um valor justo e uma projeção de preço a 3 anos apenas a partir dos documentos de cada empresa: nenhum preço de mercado como insumo, nenhuma estimativa de crescimento de analistas, apenas CAGR de receita, FCF, ROIC e Índice de Sloan processados por uma fórmula fixa (metodologia completa em nosso artigo anterior sobre [banda de confiança do DCF]).
| Ticker | Valor Justo (T0) | Preço Modelado +3A | Potencial de Valorização Modelado 3A |
|---|---|---|---|
| TER | US$ 31,63 | US$ 40,06 | 26,7% |
| ONTO | US$ 84,27 | US$ 102,62 | 21,8% |
| AMAT | US$ 118,65 | US$ 141,90 | 19,6% |
| LRCX | US$ 103,19 | US$ 117,61 | 14,0% |
| KLAC | US$ 780,69 | US$ 884,91 | 13,3% |
O vencedor do todos-contra-todos e o vencedor do DCF são duas empresas diferentes. A LRCX — o nome mais forte na classificação cara a cara — tem o segundo menor potencial de valorização modelado do grupo, pela mesma razão estrutural pela qual a NVDA mostrou o menor potencial de valorização modelado no artigo de chips/redes: o próprio valor de empresa da LRCX já é grande em relação aos seus próprios fluxos de caixa projetados, então projetar uma trajetória de crescimento fixa para frente move a estimativa de valor justo em uma porcentagem menor do que o mesmo exercício em uma base menor. A TER, o nome mais fraco no todos-contra-todos (média 21,7), mostra o maior potencial de valorização modelado — sua avaliação atual incorpora a menor parte de sua própria trajetória histórica, precisamente porque essa trajetória (0,37% de crescimento histórico de receita) é a menos impressionante da cesta. Os 13,3% de valorização da KLAC devem ser lidos junto com o sinal de qualidade de insumos da Parte 2: se sua Margem Operacional e seu ROIC estão subestimados por um artefato de dados nesta fotografia, seu potencial de valorização modelado provavelmente está subestimado em vez de superestimado, já que ambos alimentam os multiplicadores de qualidade de crescimento do modelo.
Parte 5 — Quem Realmente Tem a Blindagem de Balanço
| Ticker | Pontuação FRI | Nível | Crescimento vs FCF | ROIC vs Sloan | Dívida vs Caixa |
|---|---|---|---|---|---|
| ONTO | 100 | ALTA | OK | OK | OK |
| TER | 93 | ALTA | OK | OK | OK |
| AMAT | 78 | ALTA | OK | OK | OK |
| KLAC | 76 | ALTA | OK | OK | RISCO |
| LRCX | 63 | MODERADA | OK | ATENÇÃO | OK |
Esta é a divergência mais acentuada do artigo. A LRCX — a vencedora do todos-contra-todos e a líder em ROIC do grupo — carrega a pontuação de Resiliência mais baixa das cinco, por um único sinal específico: seu ROIC de 53,69% ao lado de um Índice de Sloan de 9,90% dispara a verificação de consistência ROIC-vs-Sloan da DUEL, o mesmo sinal de "acúmulo leve de accruals" que examinamos extensamente em nosso artigo sobre taxa base para este tipo exato de conflito. Não é um problema de Dívida-vs-Caixa — a cobertura de caixa sobre dívida da LRCX está confortavelmente acima de 1,0x — é uma nota de que parte da lucratividade reportada da LRCX está chegando via accruals em vez de caixa, algo a observar mais do que um alerta vermelho por si só. A KLAC é o caso oposto: um perfil limpo de Crescimento-vs-FCF e ROIC-vs-Sloan minado por um sinal genuíno de Dívida-vs-Caixa (relação dívida/patrimônio de 1,1x com o caixa cobrindo apenas 0,3x da dívida total) — uma história de alavancagem, não de qualidade de lucros. A ONTO, a menor empresa da cesta em receita, registra de longe o perfil de resiliência mais limpo do grupo: um balanço sem dívida (Dívida Total: US$ 0,00) e um FRI perfeito de 100.
Parte 6 — Quão Frágil É Essa Classificação? Testando os Pesos
O todos-contra-todos da Parte 3 usou os pesos de produção publicados pela DUEL (Crescimento de Receita 16%, Margem de Caixa Operacional 15%, ROIC 15%, Índice de Sloan 12%, Giro de Ativos 10%, Giro de Recebíveis 8%, Margem Operacional 12%, Margem de FCF 12%). Esses pesos são uma escolha razoável e declarada — mas não a única razoável. Seguindo o método de nosso artigo anterior sobre [Fragile Score], reexecutamos os mesmos confrontos entre as quatro empresas sob dois esquemas de ponderação alternativos, igualmente defensáveis, e verificamos se a classificação sobrevivia.
Pesos iguais (os oito fatores em 12,5% cada): o vencedor de cada confronto permanece o mesmo dos pesos de produção, mas AMAT e LRCX terminam em um empate exato pelo primeiro lugar — ambas têm média de 70,8 em seus três confrontos.
Pesos orientados à qualidade (ROIC e Índice de Sloan elevados para 25% e 20%, respectivamente, refletindo um leitor que se importa mais com eficiência de capital e qualidade de lucros do que com índices de giro; Giro de Ativos e Giro de Recebíveis reduzidos para 5% cada; fatores de crescimento e margem mantidos próximos de seus pesos originais): a AMAT assume a liderança de forma direta (média 71,7 contra 65,0 da LRCX) — a classificação de nº 1 se inverte. O confronto TER-vs-ONTO, um apertado 53-47 sob pesos de produção, torna-se um empate exato de 50-50 sob ambos os esquemas alternativos.
| Classificação | Pesos de Produção | Pesos Iguais | Pesos Orientados à Qualidade |
|---|---|---|---|
| #1 | LRCX (71,3) | AMAT / LRCX (empate, 70,8) | AMAT (71,7) |
| #2 | AMAT (69,3) | — | LRCX (65,0) |
| #3 | ONTO (37,7) | ONTO (37,5) | ONTO (40,0) |
| #4 | TER (21,7) | TER (20,8) | TER (23,3) |
As duas últimas posições são estáveis sob todos os esquemas de ponderação testados — TER e ONTO permanecem bem atrás dos líderes, independentemente de como os oito fatores sejam ponderados, embora seu próprio resultado cara a cara oscile entre uma vitória apertada da TER e um empate exato. O primeiro lugar não é estável — depende especificamente de quanto peso uma dada comparação atribui aos fatores de eficiência de capital e qualidade de lucros (ROIC, Sloan) versus os fatores de giro e crescimento. Isso não é uma falha na metodologia da DUEL — todo peso publicado é declarado e a fórmula é transparente — é uma propriedade de agregar oito sinais fundamentais distintos em um único número para um par genuinamente equilibrado. Um resultado de cinco décadas atrás na teoria da escolha social (Arrow, 1951) mostra que agregar múltiplos critérios ordenados em uma única classificação é inerentemente sensível à regra de agregação escolhida, uma vez que mais de duas opções sejam comparadas em mais de uma dimensão; a inversão das duas primeiras posições nesta cesta é uma ilustração pequena e concreta exatamente dessa sensibilidade estrutural, não um defeito específico desta comparação.
Parte 7 — O Que Isso Realmente Responde, e O Que Não Responde
Este artigo não diz, e não pode dizer, se os gastos com equipamentos de capital para semicondutores continuarão crescendo, se os pedidos de equipamentos de fabricação de wafers permanecerão fortes nos próximos trimestres, ou qual dessas cinco empresas terá melhor desempenho operacional que as outras. Essas são perguntas voltadas para o futuro, e cada número acima descreve apenas o passado e o presente.
O que os dados de fato mostram, em seus próprios termos: dentro deste oligopólio de cinco empresas, força relativa (a classificação todos-contra-todos), avaliação (a valorização do DCF) e resiliência de balanço (o FRI) apontam para três empresas diferentes como "vencedora", dependendo de qual lente é aplicada — LRCX em força relativa (por pouco, e apenas sob um esquema de ponderação razoável), TER em valorização modelada, e ONTO em resiliência. Também mostra, de forma direta e reproduzível, que a resposta para "quem é mais forte" em um oligopólio muito equilibrado não é um fato fixo esperando para ser medido uma única vez — é função de uma escolha de ponderação que uma metodologia transparente precisa tornar explícita em vez de esconder.
Limitações
A KLAC é excluída da reconstrução do todos-contra-todos na Parte 3. O duelo de 26 de julho de 2026 que forneceu os dados da KLAC não capturou seu Giro de Ativos nem seu Giro de Recebíveis, dois dos oito fatores ponderados, portanto seu histórico cara a cara contra AMAT, TER e ONTO não pôde ser reconstruído com insumos completos. Os resultados de FRI e DCF da KLAC (Partes 4-5) não dependem desses dois fatores e não são afetados.
A Margem Operacional e o ROIC da KLAC nesta fotografia parecem anomalamente baixos em relação à faixa histórica típica desta empresa e à sua própria margem de FCF no mesmo relatório, consistente com um artefato de desalinhamento de período em vez de uma deterioração genuína. Reportamos os números como gerados em vez de substituir por um valor "normal" presumido.
A LRCX e a KLAC vêm de fotografias de protocolo diferentes (18 de agosto e 26 de julho de 2026, respectivamente), e os próprios números reportados da LRCX se moveram substancialmente entre essas duas datas conforme um novo protocolo trimestral ficou disponível. Usamos os dados mais recentes da LRCX ao longo do artigo, em vez de misturar uma fotografia mais antiga da LRCX com a da KLAC.
A reconstrução do todos-contra-todos assume que a fórmula de ponderação publicada pela DUEL é aplicada exatamente como documentada. Verificamos isso contra dois resultados conhecidos (AMAT vs. TER e ONTO vs. LRCX) e reproduzimos ambos com exatidão antes de estender o método aos quatro pareamentos não confirmados; não reverificamos independentemente cada pontuação reconstruída contra um duelo ao vivo.
Cinco empresas são uma fotografia diagnóstica de um oligopólio genuíno, não uma amostra estatística. A descoberta de sensibilidade aos pesos na Parte 6 descreve esta cesta específica nesta fotografia específica; não é uma alegação de que as classificações da DUEL sejam geralmente instáveis nos centenas de outros duelos do site, a maioria dos quais — como descobriu nosso artigo anterior sobre Fragile Score — não está tão equilibrada.
Sem preço de mercado, propositalmente. O motor de DCF da DUEL ignora o preço atual da ação e as estimativas de analistas, o que é exatamente o que torna "quanto crescimento a própria trajetória de uma empresa já assume" uma pergunta limpa e verificável, em vez de uma comparação com onde o mercado atualmente precifica a ação.
Conclusão
Dentro do oligopólio de cinco empresas que constrói as ferramentas das quais os próprios fabricantes de chips dependem, nenhuma empresa vence em todas as medidas. A LRCX tem a eficiência de capital mais forte e — sob a própria ponderação de produção do site — o histórico cara a cara mais forte, mas também o único sinal de atenção em qualidade de lucros do grupo e a menor pontuação de Resiliência. A TER tem o histórico todos-contra-todos mais fraco, mas o maior espaço restante na própria matemática de avaliação da DUEL. A ONTO, a menor empresa aqui, tem o balanço mais limpo e uma pontuação de Resiliência perfeita, enquanto fica no meio da tabela em força relativa. E o próprio primeiro lugar do todos-contra-todos — LRCX à frente da AMAT — não é um fato fixo: ele se inverte para a AMAT sob uma leitura ponderada de forma diferente, igualmente defensável, dos mesmos oito números. Nada disso é uma previsão sobre o ciclo de equipamentos para semicondutores. É o que os próprios protocolos de cinco empresas dizem, processados da mesma forma, a partir de mais de um ângulo razoável.
Cada número deste artigo remete a um duelo que você mesmo pode consultar e reverificar em duelstocks.com.
Leituras Adicionais — Mesma Série, Mesmo Método
Este artigo se apoia diretamente na metodologia estabelecida nos artigos anteriores desta série, que você pode conferir logo abaixo, aqui no site.
Referências
Arrow, K. J. (1951). Social Choice and Individual Values. Wiley.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3ª ed.). Wiley.
U.S. Securities and Exchange Commission — Busca de texto completo do EDGAR e dados estruturados de protocolo XBRL, sec.gov.
Uma análise aprofundada de metodologia da DuelStocks. Não é aconselhamento de investimento. Todos os dados provêm de documentos públicos protocolados na SEC EDGAR.
Uma análise aprofundada de fundamentos da DuelStocks. Não é aconselhamento de investimento e, como o restante desta série, também não é uma previsão. Todos os números abaixo vêm de documentos públicos protocolados na SEC EDGAR (10-K/10-Q), processados pelos relatórios Battle, DCF e Resilience (STR) da DUEL.
O enquadramento de "picaretas e pás" para infraestrutura de IA tem um ponto cego: geralmente para no rack. Chips, redes e energia/refrigeração em nível de rack ganham as manchetes, mas cada um desses racks ainda precisa ser conectado a algo — capacidade de geração, transmissão e distribuição, e as empreiteiras elétricas que constroem fisicamente essa interconexão. Essa é uma cadeia diferente, com uma estrutura de capital diferente e — como este artigo mostrará — um perfil de resiliência bastante diferente do que mapeamos em [Quem Está Realmente Vendendo as Pás?].
Este é uma continuação direta, não uma repetição. Dois nomes são trazidos daquele artigo — ETN e VRT — porque ficam exatamente na fronteira entre "energia em nível de rack" e "energia em nível de rede elétrica", e sua ausência aqui deixaria uma lacuna na cadeia. Todo o resto é novo. A pergunta continua sendo a mesma que fazemos ao longo desta série: não para onde o ciclo está indo, mas o que os números já registrados nos livros dizem sobre quem está realmente capturando essa construção agora — e quanto dessa captura já está precificado na própria matemática de avaliação da DUEL.
O que os 10-K/10-Q já protocolados dizem sobre quem, na cadeia de "energia para IA" listada nos EUA, está capturando atualmente crescimento, margem e força de balanço — e quanto disso já está refletido na matemática de DCF da DUEL, sem qualquer previsão de crescimento de carga?
Parte 1 — Montando a Cesta
Fornecer energia para um data center de IA não é um único negócio. São pelo menos três: a empresa que gera ou adquire a eletricidade, a empresa que fabrica os equipamentos de comutação, transformadores e gestão térmica entre a rede e os servidores, e a empresa que constrói e faz a fiação física das subestações, linhas de transmissão e salas elétricas que conectam as duas. Construímos uma cesta de dez empresas nessas três camadas, mais os mesmos quatro compradores hiperescala usados como grupo de controle no artigo anterior:
- Geração / Concessionárias: VST, CEG, NEE, SO
- Energia / Industrial (equipamentos elétricos da rede ao edifício): ETN, VRT, EMR, ROK
- Construção / Empreiteiras Elétricas e de T&D: PWR, EME
- Compradores (grupo de controle, não pontuados como "beneficiários"): MSFT, GOOGL, AMZN, META
Isso dá dez nomes únicos do lado da oferta e quatro compradores — 14 empresas no total, cada uma processada pelo Battle Report, DCF Report e Resilience Report da DUEL exatamente como qualquer outro duelo no site. Os dez novos duelos por trás deste artigo foram gerados em 17 de agosto de 2026. Os quatro perfis de compradores são reutilizados da janela de 26 de julho a 13 de agosto de 2026 usada no artigo anterior — os resultados da DUEL por empresa são independentes do oponente, o que não afeta a comparabilidade, mas as fotografias de protocolo subjacentes estão separadas por várias semanas, algo que vale destacar claramente.
Parte 2 — Crescimento e Margem: Onde o Capital Está Realmente Aterrissando
| Ticker | Camada | Crescimento de Receita (CAGR 3A) | Margem de FCF | Margem Operacional | ROIC | Índice de Sloan |
|---|---|---|---|---|---|---|
| VST | Geração | 4,31% | 7,43% | 10,75% | 5,80% | -3,42% |
| CEG | Geração | 1,47% | 5,04% | 12,09% | 4,16% | 3,02% |
| NEE | Geração | -3,05% | 11,67% | 58,08% | 4,21% | 0,23% |
| SO | Geração | 0,31% | -9,93% | 24,65% | 5,07% | -3,20% |
| ETN | Energia/Industrial | 9,77% | 12,94% | 13,39% | 6,83% | 15,80% |
| VRT | Energia/Industrial | 21,59% | 18,51% | 17,89% | 27,99% | -2,80% |
| EMR | Energia/Industrial | -2,82% | 14,80% | n/d | n/d | -1,98% |
| ROK | Energia/Industrial | 2,44% | 16,58% | 20,41% | 20,37% | -2,49% |
| PWR | Construção/T&D | 18,60% | 5,69% | 5,66% | 8,30% | -0,70% |
| EME | Construção/T&D | 15,32% | 6,77% | 10,09% | 40,70% | -4,33% |
A primeira coisa que esta tabela mostra é que "energia" não é uma única história de crescimento — são pelo menos três histórias não correlacionadas. A camada de geração/concessionárias praticamente não cresce em base histórica: VST (4,31%), CEG (1,47%), SO (0,31%) e NEE (-3,05%) — um negócio regulado, fortemente contratado, de ciclo de capital, cuja receita simplesmente não se move como a de chips ou redes, independentemente de quanta demanda incremental apareça nas filas de interconexão. A camada de equipamentos de energia/industrial é o oposto: a VRT cresce a receita em 21,59%, mais próxima dos nomes de infraestrutura de IA do artigo anterior do que de seus próprios pares do setor, enquanto ETN (9,77%) e ROK (2,44%) crescem muito mais lentamente, e a EMR está de fato encolhendo (-2,82%) em base histórica. A camada de construção/T&D fica no meio, mas inclinada para cima — PWR (18,60%) e EME (15,32%) — consistente com um boom de construção física no segmento da cadeia que literalmente derrama concreto e passa cabos.
A margem conta uma segunda história, separada. A margem de FCF de 18,51% da VRT e seu ROIC de 27,99% parecem um perfil de margem de fornecedor de infraestrutura, não de concessionária — estruturalmente mais próximo da camada de computação/rede do artigo anterior do que de seu próprio rótulo de "energia". A margem de FCF da SO é negativa (-9,93%): o CAPEX está atualmente correndo na frente do fluxo de caixa operacional, um padrão que se repete em toda a camada de geração e que, como a Parte 3 abaixo mostra, tem consequências reais para a modelagem de DCF. A margem operacional de 58,08% da NEE merece ser marcada como um outlier em vez de aceita ao pé da letra — a contabilidade de concessionárias reguladas (reconhecimento de retorno permitido, ativos regulatórios diferidos) pode produzir números de margem operacional que não são comparáveis, fator a fator, aos de uma empresa industrial ou de software, mesmo que a mesma fórmula (Resultado Operacional / Receita) seja aplicada de forma idêntica. Nós expomos isso em vez de suavizá-lo.
Parte 3 — Quanto Crescimento Já Está no Preço
Aqui é onde as duas metades desta cesta se divergem fortemente — e onde as próprias premissas do modelo se tornam parte da descoberta. O motor de DCF da DUEL constrói um valor justo e uma projeção de preço a 3 anos apenas a partir dos documentos de cada empresa: nenhum preço de mercado como insumo, nenhuma estimativa de crescimento de analistas, apenas CAGR de receita, FCF, ROIC e Índice de Sloan processados por uma fórmula fixa (metodologia completa em nosso artigo anterior sobre [banda de confiança do DCF]).
| Ticker | Valor Justo (T0) | Preço Modelado +3A | Potencial de Valorização Modelado 3A |
|---|---|---|---|
| VST | US$ 30,74 | US$ 43,55 | 29,4% |
| EMR | US$ 45,99 | US$ 59,51 | 29,4% |
| ROK | US$ 190,30 | US$ 229,33 | 20,5% |
| ETN | US$ 184,92 | US$ 216,43 | 17,0% |
| PWR | US$ 270,35 | US$ 316,30 | 17,0% |
| EME | US$ 641,92 | US$ 749,20 | 16,7% |
| VRT | US$ 203,50 | US$ 226,82 | 11,5% |
| CEG | US$ 0,00* | US$ 11,21 | piso do modelo — veja abaixo |
| NEE | US$ 0,00* | US$ 2,25 | piso do modelo — veja abaixo |
| SO | US$ 0,00* | -US$ 8,03 | piso do modelo — veja abaixo |
Sete dos dez nomes produzem um número de potencial de valorização comum e interpretável, indo dos 11,5% da VRT (o mesmo número do artigo anterior — confirmando que os resultados por empresa do modelo são de fato independentes do oponente) até os 41,7% da VST. Mas três nomes — CEG, NEE e SO, todos na camada de geração/concessionárias — não produzem. Esta é a principal descoberta deste artigo, e merece ser declarada com precisão em vez de suavizada em uma categoria de "baixo potencial de valorização".
O que realmente está acontecendo: o DCF da DUEL define FCF como CFO menos CAPEX. Para as três empresas, o CAPEX atual é grande o suficiente em relação ao fluxo de caixa operacional (e, no caso da SO, na verdade o excede) para que projetar essa base de FCF para frente sob a fórmula fixa do modelo empurre o valor de empresa modelado abaixo da dívida total. O modelo não reporta um valor justo negativo; ele estabelece um piso de US$ 0,00 no valor de patrimônio exibido e sinaliza o caso explicitamente ("dívida total excede o valor de empresa modelado... sinaliza risco significativo de balanço, não uma avaliação precisa"). O caso da SO é o mais extremo: sua trajetória de preço modelada a 3 anos é negativa (US$ 0,00 → -US$ 2,67 → -US$ 5,34 → -US$ 8,03), porque sua própria base de FCF é negativa e o modelo não tem mecanismo para distinguir "FCF temporariamente negativo durante um ciclo de construção aprovado pelo regulador" de "negócio estruturalmente consumidor de caixa". Ambos produziriam o mesmo resultado.
Isso não é uma alegação de que Vistra, Constellation, NextEra ou Southern estejam sobre-endividadas ou mal administradas — concessionárias de geração reguladas e quase reguladas rotineiramente financiam programas de capital plurianuais com dívida apoiada em uma base tarifária ou fluxos de caixa contratados de longo prazo, algo que um DCF puro baseado em FCF histórico nunca foi projetado para captar. É uma descoberta sobre o modelo, aplicada honestamente: um motor de fluxo de caixa descontado calibrado em CFO menos CAPEX, sem tratamento de base tarifária, ativos regulatórios ou desconto de dividendos, estruturalmente não pode produzir um valor justo utilizável para esse tipo de balanço. Preferimos relatar essa limitação claramente do que forçar um número que implique mais precisão do que o modelo pode sustentar.
Parte 4 — Quem Realmente Tem a Blindagem de Balanço
| Ticker | Pontuação FRI | Nível | Crescimento vs FCF | ROIC vs Sloan | Dívida vs Caixa |
|---|---|---|---|---|---|
| EMR | 100 | ALTA | OK | OK | OK (veja nota de completude de dados) |
| VRT | 94 | ALTA | OK | OK | OK |
| PWR | 76 | ALTA | ATENÇÃO | OK | OK |
| EME | 64 | MODERADA | ATENÇÃO | OK | OK |
| ETN | 68 | MODERADA | OK | OK | RISCO |
| CEG | 53 | MODERADA | OK | OK | ATENÇÃO |
| ROK | 50 | MODERADA | OK | OK | ATENÇÃO |
| VST | 49 | MODERADA | OK | OK | RISCO |
| NEE | 44 | MODERADA | OK | OK | RISCO |
| SO | 42 | MODERADA | OK | OK | RISCO |
Esta tabela é o contraste mais forte com o artigo anterior. Na cesta de chips/redes/refrigeração, 55% das empresas passaram nas três verificações de consistência interna com um OK/OK/OK limpo. Aqui, apenas duas de dez conseguem — VRT e, com uma ressalva abaixo, EMR. Cada um dos quatro nomes de geração/concessionárias carrega um sinal de Dívida-vs-Caixa, e três dos quatro carregam o nível mais severo de RISCO em vez de ATENÇÃO. Isso se alinha diretamente com a Parte 3: a mesma intensidade de capital financiada por dívida que trava os valores justos de DCF de CEG, NEE e SO em US$ 0,00 também é o que está gerando seus sinais de Dívida-vs-Caixa aqui. As duas descobertas não são achados independentes — é a mesma estrutura de balanço subjacente aparecendo em duas partes diferentes do modelo da DUEL.
A pontuação FRI de 100 da EMR precisa de sua própria ressalva, no mesmo espírito da GEV no artigo anterior. Seu Relatório de Resiliência mostra vários componentes brutos de balanço — caixa, dívida total, resultado operacional, patrimônio — como não disponíveis ("—") no período de protocolo capturado, deixando apenas a subpontuação de Autossuficiência de Investimento (FCF/CAPEX) calculada; as outras três submétricas (Cobertura Caixa-Dívida, Qualidade de Resultados, Prazo de Liquidez) não puderam ser pontuadas de forma alguma. Um 100 construído sobre uma de quatro submétricas preenchidas é um tipo diferente de 100 do que o da VRT, construído sobre quatro submétricas totalmente preenchidas que pontuaram de forma limpa. A explicação mais provável é uma incompatibilidade de calendário fiscal — o ano fiscal da Emerson termina em setembro em vez de dezembro, o que pode deixar certos campos marcados em XBRL escassamente preenchidos em relação a pares de ano civil em um determinado momento — mas até que um período de protocolo com dados completos seja capturado, o FRI da EMR deve ser lido como provisório, não definitivo.
PWR e EME carregam ambas um único sinal de ATENÇÃO em Crescimento vs. FCF: ambas estão crescendo a receita na faixa média-alta de dez por cento (18,60% e 15,32%) enquanto a margem de FCF fica na faixa média de um dígito (5,69% e 6,77%) — um sinal direto de atraso na conversão de caixa, típico de empreiteiras que ampliam pessoal e capital de giro antes do faturamento, não uma preocupação de qualidade contábil.
Parte 5 — O Placar: Potencial de Valorização vs. Resiliência
Colocando as Partes 3 e 4 na mesma página, os sete nomes com um resultado de DCF interpretável se organizam em uma grade 2×2. O ponto de corte em cada eixo é a mediana calculada apenas sobre esses sete nomes (mediana de valorização 17,0%, mediana de FRI 68); CEG, NEE e SO são totalmente excluídos dessa grade em vez de forçados a um quadrante que seu valor justo modelado na verdade não sustenta; eles recebem sua própria categoria abaixo.
Precificado de forma atrativa e estruturalmente sólido: EMR, PWR (ambas acima da mediana de FRI; a valorização da PWR fica quase exatamente na linha mediana de 17,0%)
Valorização modelada, colchão mais fino: VST, ROK (valorização acima da mediana, resiliência abaixo da mediana)
Já precificado, mas muito sólido: VRT (valorização abaixo da mediana, mas o FRI totalmente preenchido mais alto da cesta)
Já precificado, colchão comparativamente mais fino: EME
Exatamente no cruzamento: ETN, cuja valorização de 17,0% e FRI de 68 caem quase exatamente em ambas as linhas medianas, tornando-a o ponto de pivô desta cesta em vez de um membro claro de qualquer quadrante.
Casos de piso do modelo (excluídos da grade): CEG, NEE, SO — veja Parte 3. As três carregam um sinal de RISCO ou ATENÇÃO de Dívida-vs-Caixa na Parte 4 e um valor justo modelado de US$ 0,00 na Parte 3; lidos juntos, este é o sinal mais claro nesta cesta, e pertence especificamente à camada de geração/concessionárias, não a energia/industrial ou construção/T&D.
O contraste com o placar do artigo anterior é, em si, uma descoberta. Em Pás, apenas dois dos onze nomes caíram no quadrante menos favorável, e nenhum dos onze quebrou totalmente o modelo de DCF. Aqui, três dos dez nomes quebram o modelo totalmente antes mesmo de uma conversa sobre quadrante ser possível, e eles se concentram exatamente em uma camada da cadeia — geração. A história de "energia para IA", no nível dos fundamentos, não é uma única história; é uma camada de equipamentos/empreiteiras resiliente sentada sobre uma camada de geração fortemente endividada.
Parte 6 — O Grupo de Controle: Como São os Compradores
| Ticker | Potencial de Valorização Modelado 3A | Pontuação FRI | Nível |
|---|---|---|---|
| GOOGL | 20,6% | 85 | ALTA |
| AMZN | 18,6% | 100 | ALTA |
| MSFT | 18,6% | 81 | ALTA |
| META | 16,2% | 83 | ALTA |
Os quatro compradores hiperescala ficam todos no nível de resiliência ALTA da DUEL — o mesmo resultado do artigo anterior, e os mesmos números, reutilizados em vez de recalculados (veja a nota sobre a janela reutilizada na Parte 1). O que é diferente desta vez é o contraste do outro lado da transação. Em Pás, os onze fornecedores de chips/redes/refrigeração variavam de FRI 11 a 100 com mediana de 75 — próximo da própria faixa de 81–100 dos compradores. Aqui, os dez fornecedores da cadeia elétrica variam de FRI 42 a 100 com mediana de 68, e três deles não passam de forma alguma pelo modelo de DCF da DUEL. Os compradores que financiam essa construção estão, por essa medida, com balanços dramaticamente mais fortes do que as empresas do lado da geração que realmente estão construindo a energia para ela.
Parte 7 — O Que Isso Realmente Responde, e O Que Não Responde
Para ser preciso quanto aos limites deste exercício, já que exagerar aqui prejudicaria todo o propósito: este artigo não diz, e não pode dizer, se a capacidade da rede elétrica dos EUA vai acompanhar o crescimento de carga impulsionado pela IA, se projetos específicos de geração ou transmissão serão construídos no cronograma, ou se os planos de capital dessas empresas terão sucesso. Essas são perguntas voltadas para o futuro, e cada número acima descreve apenas o passado e o presente.
O que os dados de fato mostram, em seus próprios termos: crescimento e margem nesta cadeia são genuinamente três histórias separadas em camadas — uma camada de geração de crescimento lento e alta intensidade de capital; uma camada de equipamentos de crescimento rápido e alta margem; e uma camada de construção de crescimento rápido e margem fina. Também mostra que a resiliência, medida da mesma forma nas 14 empresas deste artigo e do anterior, não está distribuída uniformemente nesta cadeia — está concentrada na camada de equipamentos e amplamente ausente na camada de geração, onde o modelo de DCF da DUEL quebra completamente para três de quatro nomes. Isso é uma afirmação sobre a estrutura de balanço dessas empresas específicas hoje, processada por um modelo específico, não uma previsão sobre o mercado de energia de amanhã.
Limitações
Três dos dez nomes não produziram um valor justo de DCF utilizável. CEG, NEE e SO todas atingiram o piso do modelo da DUEL (valor de patrimônio exibido de US$ 0,00, detalhe completo na Parte 3). Isso reflete uma incompatibilidade entre a definição fixa de FCF do modelo (CFO menos CAPEX) e a estrutura de capital financiada por dívida e orientada por base tarifária, típica de concessionárias de geração reguladas e quase reguladas — não uma alegação sobre a saúde financeira real ou o mérito de investimento dessas empresas.
A pontuação de Resiliência da EMR é construída sobre dados brutos incompletos, sinalizada diretamente na Parte 4 — três de quatro submétricas não puderam ser calculadas no período de protocolo capturado, provavelmente devido a uma incompatibilidade de fim de ano fiscal (setembro para a Emerson versus dezembro para a maioria dos pares). Seu FRI de 100 deve ser tratado como provisório até que um período de protocolo com dados de balanço completos seja capturado.
Fotografia, não um ranking ao vivo, e não uma única janela temporal. Os dez duelos do lado da oferta foram gerados em 17 de agosto de 2026. Os quatro perfis de compradores são reutilizados da janela de 26 de julho a 13 de agosto de 2026 usada no artigo anterior desta série; os resultados da DUEL por empresa não dependem do oponente, mas as fotografias de protocolo subjacentes estão separadas por várias semanas.
Sem preço de mercado, propositalmente — e isso funciona nos dois sentidos. O motor de DCF da DUEL ignora deliberadamente o preço atual da ação e as estimativas de analistas, o que é exatamente o que torna "quanto crescimento a própria trajetória de uma empresa já assume" uma pergunta limpa e verificável. Também significa que o "potencial de valorização modelado" aqui não é uma expectativa implícita de mercado e não deve ser lido como tal.
A montagem da cesta é uma decisão de julgamento, não um censo. Dez nomes do lado da oferta e quatro compradores são um recorte razoável da cadeia elétrica de IA listada nos EUA, não exaustivo; uma cesta diferente, igualmente razoável, poderia mudar quais nomes caem em qual parte desta análise.
Catorze empresas são uma fotografia diagnóstica, não uma amostra estatística — leia os padrões acima como descritivos, não como evidência generalizável para além desta cesta específica.
Conclusão
Em dez empresas que fornecem energia para infraestrutura de IA e quatro dos compradores hiperescala que financiam essa construção, crescimento e margem se dividem claramente em três histórias separadas por camada — geração lenta e intensiva em capital; equipamentos rápidos e de alta margem; construção rápida e de margem fina. A resiliência se divide de forma ainda mais acentuada: a camada de equipamentos parece ser a parte mais forte de toda a cadeia de infraestrutura de IA examinada nos dois artigos desta série até agora, enquanto três dos quatro nomes de geração/concessionárias carregam um sinal genuíno de alavancagem e nenhum dos três produz um valor justo de DCF utilizável sob o modelo da DUEL. Nada disso é uma previsão sobre a construção da rede, o crescimento de carga, ou quais projetos serão financiados. É o que os protocolos já dizem, processados pela mesma fórmula para cada empresa na sala — incluindo um relato honesto de onde essa fórmula deixa de funcionar.
Cada número deste artigo remete a um duelo que você mesmo pode consultar e reverificar em duelstocks.com.
Leituras Adicionais — Mesma Série, Mesmo Método
Este artigo é uma continuação direta que se apoia na metodologia estabelecida nos artigos anteriores desta série, que você pode conferir logo abaixo, aqui no site.
Referências
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3ª ed.). Wiley.
Damodaran, A. (2018). Valuing regulated and capital-intensive businesses: why standard DCF assumptions break down for rate-based utilities. Nota de trabalho, NYU Stern School of Business.
U.S. Securities and Exchange Commission — Busca de texto completo do EDGAR e dados estruturados de protocolo XBRL, sec.gov.
Uma análise aprofundada de metodologia da DuelStocks. Não é aconselhamento de investimento. Todos os dados provêm de documentos públicos protocolados na SEC EDGAR.
Uma análise aprofundada de fundamentos da DuelStocks. Não é aconselhamento de investimento e, ao contrário da maioria dos comentários sobre o ciclo da IA, também não é uma previsão. Todos os números abaixo vêm de documentos públicos protocolados na SEC EDGAR (10-K/10-Q), processados pelos relatórios Battle, DCF e Resilience (STR) da DUEL.
Pergunte a dez pessoas se a construção de infraestrutura de IA está em seus estágios iniciais, intermediários ou finais, e você obterá dez respostas confiantes e nenhuma evidência compartilhada. Isso acontece porque a pergunta, como costuma ser feita, é uma pergunta de previsão — "quanto mais capex ainda está por vir" — e previsão não é algo que esta ferramenta faz ou alega fazer. A DUEL não tem opinião sobre gastos futuros em IA, nenhuma estimativa de analistas e nenhum modelo macroeconômico.
O que a DUEL de fato tem é algo mais restrito e verificável: uma leitura padronizada do que os dados financeiros já publicados das empresas que constroem infraestrutura de IA dizem sobre crescimento, margem, eficiência de capital, matemática de avaliação e resiliência de balanço — todos provenientes da mesma fonte (documentos da SEC) e processados pelas mesmas fórmulas para cada empresa envolvida. Assim, em vez de perguntar "em que ponto do ciclo estamos", este artigo faz uma versão dessa pergunta que a DUEL pode realmente responder com dados, e não com opinião:
O que os números já registrados nos livros dizem sobre quem está realmente capturando agora a construção da infraestrutura de IA — e quanto dessa captura já está precificado na própria matemática de avaliação da DUEL?
Parte 1 — Montando a Cesta
"Picaretas e pás" é o enquadramento natural para investir em infraestrutura de IA: em vez de apostar em qual aplicação de IA vencerá, compram-se as empresas que fornecem a computação, a rede, a energia e o armazenamento de que toda carga de trabalho de IA precisa, independentemente de quem vença. Construímos uma cesta em quatro camadas de fornecimento, mais um quinto grupo que fica do outro lado da transação — os compradores hiperescala — como grupo de controle, não como um conjunto de "beneficiários":
- Computação: NVDA, AMD, AVGO, MU
- Rede / interconexão: ANET, CIEN
- Energia e refrigeração: VRT, ETN, MOD, GEV
- Memória e armazenamento: MU (compartilhado com Computação), WDC
- Compradores (grupo de controle, não pontuados como "beneficiários"): MSFT, GOOGL, AMZN, META
Um nome está visivelmente ausente. A TSM foi excluída por completo. Como emissora privada estrangeira sediada em Taiwan, a TSMC protocola na SEC um relatório anual 20-F, não um 10-K, e não protocola 10-Qs. Todo o modelo da DUEL é construído exclusivamente com base em dados de 10-K/10-Q, por design — então uma empresa que, estruturalmente, não protocola esses formulários fica fora do que esta ferramenta pode medir, por mais central que seja para a cadeia de valor real. Preferimos sinalizar essa lacuna claramente a preenchê-la silenciosamente com um número vindo de outro lugar.
Isso deixa 11 "vendedoras de pás" únicas e 4 compradoras — 15 empresas no total, cada uma processada pelo Battle Report, DCF Report e Resilience Report da DUEL exatamente como qualquer outro duelo no site. Todos os duelos por trás deste artigo foram gerados entre 26 de julho e 13 de agosto de 2026. Isto é uma fotografia dessa janela, não um ranking permanente — a metodologia continua válida muito depois que qualquer número individual ficar desatualizado.
Parte 2 — Crescimento e Margem: Onde o Capital Está Realmente Aterrissando
| Ticker | Camada | Crescimento de Receita (CAGR 3A) | Margem de FCF | Margem Operacional | ROIC | Índice de Sloan |
|---|---|---|---|---|---|---|
| NVDA | Computação | 100,1% | 47,5% | 60,4% | 51,0% | -6,9% |
| AMD | Computação | 13,6% | 19,4% | 10,7% | 4,5% | -4,7% |
| AVGO | Computação | 24,4% | 42,1% | 39,9% | 14,1% | -11,9% |
| MU | Computação / Armazenamento | 6,7% | 4,5% | 26,1% | 9,0% | 36,9% |
| ANET | Rede | 27,2% | 48,4% | 42,8% | 23,1% | 1,3% |
| CIEN | Rede | 9,5% | 14,0% | 4,1% | 4,4% | -4,0% |
| VRT | Energia/Refrigeração | 21,6% | 18,5% | 17,9% | 28,0% | -2,8% |
| ETN | Energia/Refrigeração | 9,8% | 12,9% | 13,4% | 6,8% | 15,8% |
| MOD | Energia/Refrigeração | 11,5% | 3,3% | 10,8% | 16,2% | -4,6% |
| GEV | Energia/Refrigeração | 8,7% | 2,4% | 3,7% | n/d | 5,6% |
| WDC | Armazenamento | -20,3% | 13,4% | 24,5% | 19,0% | 32,3% |
Nenhum número aqui sugere que "o ciclo acabou". Nove dos onze nomes ainda crescem a receita em dois dígitos, e os dois nomes de rede — ANET (27,2%) e CIEN (9,5%) — ficam em extremos opostos dessa faixa dentro da mesma camada, o que já é informativo por si só: a demanda de interconexão não impulsiona todos os nomes de rede igualmente. O número de 100% da NVDA é um outlier de uma ordem de grandeza em relação aos seus próprios pares da camada de computação — um lembrete de que "demanda de computação de IA" e "crescimento de receita da NVIDIA" não são a mesma variável, mesmo que as manchetes frequentemente as fundam em uma só.
O quadro de margens é onde a cesta se divide em dois negócios visivelmente diferentes. Nomes de computação e rede (NVDA, AVGO, ANET) registram margens de FCF na faixa de 42–48% — uma conversão de caixa semelhante à de software, apesar de serem empresas de hardware, em grande parte porque a fabricação em si é terceirizada. Nomes de energia e refrigeração (VRT, ETN, MOD, GEV) registram margens de FCF entre 2% e 19% — negócios intensivos em capital e de margem mais baixa por natureza, mais próximos de industriais tradicionais do que do design de chips. A WDC é o único nome com crescimento de receita negativo em toda a cesta (-20,3%), refletindo um vale cíclico nos preços de NAND/HDD que não tem relação com a demanda específica de IA — um lembrete de que "armazenamento" como categoria está exposto a mais de um ciclo de demanda ao mesmo tempo.
Parte 3 — Quanto Crescimento Já Está no Preço
Esta é a parte que realmente aborda a questão do "estágio do ciclo" — indiretamente, e nos próprios termos da DUEL. O motor de DCF da DUEL constrói um valor justo e uma projeção de preço a 3 anos apenas a partir dos documentos de cada empresa: nenhum preço de mercado como insumo, nenhuma estimativa de crescimento de analistas, apenas CAGR de receita, FCF, ROIC e Índice de Sloan processados por uma fórmula fixa (metodologia completa em nosso artigo anterior sobre [banda de confiança do DCF]). O potencial de valorização modelado em 3 anos resultante não é um preço-alvo — é uma medida de quanto da própria trajetória histórica de uma empresa, projetada segundo as regras fixas do modelo, já está refletido na própria estimativa de valor justo do modelo, versus quanto espaço a matemática ainda mostra.
| Ticker | Valor Justo (T0) | Preço Modelado +3A | Potencial de Valorização Modelado 3A |
|---|---|---|---|
| WDC | US$ 30,68 | US$ 39,14 | 27,6% |
| AMD | US$ 67,72 | US$ 83,98 | 24,0% |
| GEV | US$ 57,82 | US$ 69,81 | 20,7% |
| GOOGL | US$ 106,91 | US$ 128,91 | 20,6% |
| CIEN | US$ 88,73 | US$ 105,80 | 19,2% |
| AMZN | US$ 254,94 | US$ 302,36 | 18,6% |
| MSFT | US$ 200,09 | US$ 237,23 | 18,6% |
| MOD | US$ 41,28 | US$ 48,82 | 18,3% |
| ANET | US$ 105,29 | US$ 123,88 | 17,6% |
| ETN | US$ 184,92 | US$ 216,43 | 17,0% |
| META | US$ 524,18 | US$ 609,31 | 16,2% |
| NVDA | US$ 176,47 | US$ 202,24 | 14,6% |
| AVGO | US$ 205,67 | US$ 233,87 | 13,7% |
| MU | US$ 38,29 | US$ 43,06 | 12,5% |
| VRT | US$ 203,50 | US$ 226,82 | 11,5% |
A NVIDIA — de longe o nome de crescimento mais rápido e maior ROIC de toda a cesta — fica em 12º lugar entre 15 no potencial de valorização modelado. Isso não é coincidência do modelo; é a consequência aritmética direta do fato de que o próprio valor de empresa da NVDA já é grande o suficiente, em relação aos seus próprios fluxos de caixa projetados, para que projetar um caminho de crescimento fixo de 3 anos produza um movimento percentual menor do que fazer o mesmo exercício sobre uma base menor. Esse é o mesmo padrão que nosso primeiro artigo desta série encontrou em um único duelo NVDA-vs-AMD no início de agosto; aplicá-lo a uma cesta de infraestrutura de 11 empresas em vez de um único par mostra que não é um artefato daquela comparação específica.
Duas notas de validade que vale a pena destacar claramente. Primeiro, o valor justo da MU (US$ 38,29), seu preço a 3 anos (US$ 43,06) e cada insumo por trás deles aparecem de forma idêntica, seja a MU comparada com a AMD ou com a WDC — confirmação direta, comprovada na prática, de que os resultados de DCF da DUEL por empresa não dependem de quem é o oponente, exatamente como o modelo foi projetado para funcionar. Segundo, o potencial de valorização modelado da GEV (20,7%) fica perto do topo desta tabela, mas deve ser lido junto com a Parte 4 abaixo antes de se tirar qualquer conclusão isolada dele.
Parte 4 — Quem Realmente Tem a Blindagem de Balanço
| Ticker | Pontuação FRI | Nível | Crescimento vs FCF | ROIC vs Sloan | Dívida vs Caixa |
|---|---|---|---|---|---|
| AMD | 100 | ALTA | OK | OK | OK |
| ANET | 97 | ALTA | OK | OK | OK |
| VRT | 94 | ALTA | OK | OK | OK |
| CIEN | 90 | ALTA | OK | OK | OK |
| MU | 76 | ALTA | OK | OK | OK |
| AVGO | 75 | ALTA | OK | OK | ATENÇÃO |
| WDC | 69 | MODERADA | OK | OK | OK |
| ETN | 68 | MODERADA | OK | OK | RISCO |
| NVDA | 64 | MODERADA | OK | OK | OK |
| MOD | 31 | BAIXA | OK | OK | OK |
| GEV | 11 | BAIXA | OK | OK | OK |
É aqui que a narrativa do "beneficiário" fica mais complicada do que um único gráfico de crescimento sugere. Dois dos quatro nomes de energia e refrigeração — MOD (31) e GEV (11) — caem no nível de resiliência BAIXA da DUEL, a mesma categoria que o modelo reserva para empresas cujo colchão de balanço parece fino em relação às suas demandas de fluxo de caixa, independentemente da força da narrativa de crescimento subjacente. A GEV, em particular, merece uma ressalva de qualidade de dados em vez de um veredito: vários de seus componentes brutos de balanço (caixa, dívida total, resultado operacional, patrimônio) não estavam disponíveis no período de protocolo consultado, mais provavelmente porque o histórico de protocolos da GE Vernova junto à SEC ainda é curto desde sua cisão da GE em 2024. Seu nível BAIXO deve ser tratado como provisório até que protocolos mais completos pós-cisão se acumulem — uma empresa com histórico de protocolo curto aparecerá mecanicamente mais fina em componentes que o modelo ainda não consegue ver, independentemente de sua real condição financeira.
A ETN é um caso mais claro: sua verificação de consistência Dívida-vs-Caixa disparou um sinal genuíno de RISCO — relação dívida/patrimônio acima de 1,0x, com o caixa cobrindo essencialmente nada da dívida total — um sinal simples de alavancagem em um balanço industrial já maduro, não uma preocupação de qualidade contábil. O único sinal de ATENÇÃO da AVGO é a mesma história em escala menor.
Enquanto isso, as maiores pontuações de resiliência da cesta não pertencem aos nomes de maior crescimento nem aos de menor potencial de valorização — pertencem à AMD, ANET e VRT, três empresas com perfis de crescimento e estruturas de margem significativamente diferentes, unificadas apenas por balanços limpos e sem contradições nas três verificações internas de consistência da DUEL.
Parte 5 — O Placar: Potencial de Valorização vs. Resiliência
Colocando as Partes 3 e 4 na mesma página — potencial de valorização modelado a 3 anos em um eixo, nível de resiliência no outro — os nomes de infraestrutura se dividem em quatro grupos que nenhuma tabela isolada acima mostra sozinha. O ponto de corte em cada eixo é a mediana calculada apenas sobre as 11 empresas do lado da oferta (17,65% de valorização, FRI 75); os quatro compradores hiperescala são deliberadamente excluídos desse cálculo e mostrados separadamente na Parte 6, para que seus balanços muito maiores e mais diversificados não distorçam silenciosamente a mediana dos fornecedores.
Precificado de forma atrativa e estruturalmente sólido (valorização acima da mediana, resiliência acima da mediana): AMD, ANET, CIEN
Valorização modelada, colchão mais fino (valorização acima da mediana, resiliência abaixo da mediana): WDC, GEV, MOD
Já precificado, mas muito sólido (valorização abaixo da mediana, resiliência acima da mediana): AVGO, MU, VRT
Já precificado, colchão comparativamente mais fino (valorização abaixo da mediana, resiliência abaixo da mediana): NVDA, ETN
Apenas dois nomes caem nesse último quadrante, o menos favorável — e a NVIDIA é um deles, ao lado da ETN, uma industrial madura que essa mesma análise sinalizou com um autêntico alerta de RISCO de alavancagem na Parte 4. Essa é a verdadeira surpresa aqui: o nome que toda manchete trata como o óbvio "vencedor da IA" está no quadrante que a própria matemática desta cesta associa ao menor espaço modelado restante e ao menor colchão de resiliência — não porque haja algo errado com o negócio, mas porque tanto seu crescimento quanto seu valor de empresa já avançaram o suficiente para que a própria aritmética do modelo tenha, em ambos os eixos, menos distância a percorrer do que para nove dos outros dez fornecedores da cadeia em cujo centro ela está.
Parte 6 — O Grupo de Controle: Como São os Compradores
| Ticker | Potencial de Valorização Modelado 3A | Pontuação FRI | Nível |
|---|---|---|---|
| GOOGL | 20,6% | 85 | ALTA |
| AMZN | 18,6% | 100 | ALTA |
| MSFT | 18,6% | 81 | ALTA |
| META | 16,2% | 83 | ALTA |
Os quatro compradores hiperescala ficam todos no nível de resiliência ALTA da DUEL, ao contrário de seus fornecedores, cuja resiliência variou de 11 a 100. Isso é esperado — são quatro dos maiores e mais diversificados geradores de caixa de todo o mercado, comprando infraestrutura de IA como mais um item entre muitos, em vez de depender dela como um fornecedor puro depende. O que é menos esperado: seu potencial de valorização modelado (16,2%–20,6%) fica exatamente na mesma faixa da cesta de fornecedores — nem visivelmente maior nem menor. Ser o comprador nessa transação não produz estruturalmente uma assinatura de matemática de avaliação diferente da de ser o fornecedor — pelo menos não uma que esta fotografia consiga detectar.
Parte 7 — O Que Isso Realmente Responde, e o Que Não Responde
Para ser preciso quanto aos limites deste exercício, já que exagerar aqui prejudicaria todo o propósito: este artigo não diz, e não pode dizer, se os gastos com infraestrutura de IA têm mais espaço para crescer, estão estabilizando, ou já atingiram o pico. Essa é uma pergunta sobre o futuro, e cada número acima descreve apenas o passado e o presente.
O que os dados de fato mostram, em seus próprios termos: as taxas de crescimento passadas nesta cesta continuam altas e continuam dispersas — nada aqui se assemelha a um setor onde o crescimento se sincronizou e se estabilizou, o que tipicamente é como um ciclo "tardio e amadurecendo" se parece nos fundamentos, em vez de nas manchetes. Também mostra que a resiliência é genuinamente desigual sob uma história de crescimento contada como se se aplicasse igualmente a todos os envolvidos, e que a própria matemática de DCF da DUEL, sem preço de mercado, já está atribuindo menos espaço modelado restante ao nome mais discutido do setor do que à maior parte do resto da cadeia ao seu redor — o que é uma afirmação sobre o ponto de partida atual dessa empresa específica, não uma previsão sobre o amanhã.
Limitações
TSM totalmente excluída, e por um motivo estrutural, não de qualidade de dados: como emissora privada estrangeira, a empresa protocola um 20-F em vez de um 10-K, o que a coloca fora do que o pipeline da DUEL, baseado exclusivamente em SEC EDGAR, foi projetado para ler, independentemente de sua real importância para a camada de computação.
Fotografia, não um ranking ao vivo. Cada duelo subjacente foi gerado entre 26 de julho e 13 de agosto de 2026; os números específicos acima mudarão a cada novo protocolo trimestral, embora o método comparativo do qual vieram não mude.
Sem preço de mercado, propositalmente — e isso funciona nos dois sentidos. O motor de DCF da DUEL ignora deliberadamente o preço atual da ação e as estimativas de analistas, o que é exatamente o que torna "quanto crescimento a própria trajetória da empresa já assume" uma pergunta limpa e verificável. Também significa que o "potencial de valorização modelado" aqui não é uma expectativa implícita de mercado e não deve ser lido como tal.
A montagem da cesta é uma decisão de julgamento, não um censo. Onze nomes de infraestrutura e quatro compradores são um recorte razoável da cadeia de valor da IA, não exaustivo; uma cesta diferente e igualmente razoável poderia mudar quais nomes caem em qual quadrante do placar.
A pontuação de resiliência da GEV deve ser lida com uma ressalva de completude de dados, sinalizada diretamente na Parte 4 — vários insumos brutos de balanço não estavam disponíveis dado o curto histórico de protocolos da empresa desde sua cisão em 2024, e seu nível BAIXO pode refletir parcialmente essa lacuna, em vez de um quadro totalmente resolvido de sua condição financeira.
Quinze empresas são uma fotografia diagnóstica, não uma amostra estatística — leia os padrões acima como descritivos, não como evidência generalizável para além desta cesta específica.
Conclusão
Em onze fornecedores de infraestrutura de IA e quatro de seus maiores compradores, o crescimento continua amplamente forte e continua distribuído de forma desigual — não um quadro de um setor estabilizado. A resiliência, por outro lado, não acompanha a história do crescimento de forma alguma: alguns dos nomes de crescimento mais hypados carregam os colchões de balanço mais finos da cesta, e alguns dos nomes menos discutidos carregam os mais sólidos. E o número que mais diretamente aborda a questão de "quanto já está precificado" — o potencial de valorização modelado da própria DUEL, independente do oponente e sem preço de mercado — atualmente atribui o menor espaço restante ao nome que a maioria das pessoas chamaria de centro óbvio de todo esse ciclo. Nada disso é uma previsão. É o que os protocolos já dizem, processados pela mesma fórmula para cada empresa na sala.
Cada número deste artigo remete a um duelo que você mesmo pode consultar e reverificar em duelstocks.com.
Leituras Adicionais — Mesma Série, Mesmo Método
Este artigo se apoia diretamente na metodologia estabelecida em seis análises aprofundadas anteriores desta série, que você pode conferir logo abaixo, aqui no site.
Referências
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3ª ed.). Wiley.
U.S. Securities and Exchange Commission — Requisitos de relato para Emissores Privados Estrangeiros (Formulário 20-F vs. Formulário 10-K), sec.gov.
Uma análise aprofundada de metodologia da DuelStocks. Não é aconselhamento de investimento. Todos os dados provêm de documentos públicos protocolados na SEC EDGAR.
A alavancagem do balanço, e não a qualidade dos lucros, é responsável pela maioria das penalizações de resiliência financeira.
A pergunta
O Resilience Report (STR) do DUEL verifica cada empresa em três pares de consistência interna: o crescimento de receita realmente se converte em fluxo de caixa livre (Crescimento vs FCF), um ROIC forte se sustenta depois que você verifica a qualidade dos accruals (ROIC vs Sloan), e a dívida do balanço realmente corresponde ao colchão de caixa disponível (Dívida vs Caixa). Qualquer par que falhe aciona uma penalização de pontuação e uma nota sinalizada.
O sinal ROIC-vs-Sloan da Oracle (ORCL) — um ROIC de manchete de 84% ao lado de um Sloan Ratio sinalizando possível inflação de lucros — foi convincente o suficiente para justificar um texto inteiro de cobertura em torno dele. Mas um caso dramático levanta uma pergunta óbvia: essa é a forma normal como uma empresa falha nessa verificação de consistência do modelo, ou é a rara excessão vestida de norma só porque foi o caso que cobrimos?
Pergunta de pesquisa: em um recorte transversal real de empresas, qual é a taxa base de cada um dos três conflitos da matriz de consistência, e qual deles realmente impulsiona a maioria das penalizações de resiliência?
Este é um animal estatístico diferente do nosso texto anterior de PCA sobre redundância de métricas. Aquele estudo perguntava como métricas contínuas se correlacionam entre si. Este pergunta com que frequência um limiar binário de aprovado/reprovado é acionado — um problema de estimativa de taxa base, que exige um conjunto de ferramentas totalmente diferente.
Literatura
Sloan (1996) é a âncora teórica para por que ROIC-vs-Sloan deveria se comportar como um sinal de alerta precoce, em primeiro lugar: empresas com accruals elevados em relação ao fluxo de caixa tendem a ver a qualidade dos lucros — e, eventualmente, os retornos — decepcionar. Mas a questão da taxa base está em uma literatura diferente, ainda que relacionada: quão comuns são os sinais de alerta de qualidade dos lucros em uma população geral, não filtrada, de empresas de capital aberto? Beneish (1999), ao construir o M-Score original, trabalhou com uma amostra deliberadamente desequilibrada — 50 manipuladores de lucros conhecidos pareados com 1.708 não manipuladores — precisamente porque manipuladores reais são raros na prática; seu desenho precisou sobreamostrá-los para ter sequer casos positivos suficientes para modelar. Dechow, Ge, Larson e Sloan (2011), estudando ações de fiscalização da SEC por erro contábil ao longo de 23 anos, chegam à mesma conclusão a partir de dados populacionais reais: erro material é um evento de taxa base baixa, não um cara ou coroa. Nossa expectativa prévia sobre o conflito ROIC-vs-Sloan, antes de começar, deveria ser "raro" — e a pergunta é se os dados do DUEL concordam com isso, e se os outros dois tipos de conflito compartilham ou não essa raridade.
Para a estatística da própria estimativa de uma taxa: Cochran (1977) fornece a fórmula padrão de tamanho de amostra para estimar uma proporção com uma margem de erro alvo. Mas, uma vez estimada a taxa, especialmente perto dos limites (muito baixa ou muito alta), o intervalo de confiança comum por aproximação normal ("Wald") tem desempenho ruim — pode até produzir limites inferiores negativos sem sentido. Wilson (1927) propôs um intervalo baseado em escore que se mantém bem comportado em proporções extremas, e Newcombe (1998) confirma-o como a escolha mais confiável para proporções de amostra pequena ou evento raro, como as tratadas diretamente neste artigo. Todos os intervalos de confiança abaixo usam o método de Wilson por esse motivo.
Dados e método
Painel: as mesmas 60 empresas (30 duelos) usadas em nosso texto de PCA anterior, agora com o STR Resilience Report de cada empresa extraído em vez de seu Battle Report — a mesma população subjacente, um artefato de relatório diferente, o que permite que os dois estudos fiquem lado a lado em um painel consistente.
Variáveis: para cada empresa, os três resultados da matriz de consistência conforme reportados (OK / ATENÇÃO / RISCO), além da pontuação FRI geral, o nível de resiliência (ALTO/MODERADO/BAIXO), a pontuação base e a penalização.
Método: taxa base = contagem de resultados não-OK ÷ 60, calculada separadamente para (a) qualquer sinal não-OK (ATENÇÃO ou RISCO combinados) e (b) especificamente RISCO, para cada uma das três verificações. Intervalos de confiança de 95% via método de escore de Wilson. A diretriz de célula mínima esperada de Cochran (1977) (≥5 eventos para uma estimativa de taxa estável) é aplicada explicitamente para sinalizar quais das três taxas são confiáveis nesse tamanho de amostra e quais ainda não são.
Resultados
Taxa base por tipo de conflito
| Verificação | Não-OK (ATENÇÃO+RISCO) | Taxa | IC 95% de Wilson | Somente RISCO | Taxa |
|---|---|---|---|---|---|
| Crescimento vs FCF | 2 / 60 | 3,3% | [0,9%, 11,4%] | 0 / 60 | 0,0% |
| ROIC vs Sloan | 2 / 60 | 3,3% | [0,9%, 11,4%] | 1 / 60 | 1,7% |
| Dívida vs Caixa | 26 / 60 | 43,3% | [31,6%, 55,9%] | 19 / 60 | 31,7% |
Essa não é uma diferença sutil. Dívida vs Caixa é acionada aproximadamente treze vezes mais do que qualquer uma das outras duas verificações. Crescimento vs FCF e ROIC vs Sloan — o tipo de conflito que inspirou toda essa linha de investigação — chegam exatamente à mesma taxa, 3,3%, empatadas como o resultado mais raro de toda a matriz.
Quantas empresas carregam mais de um sinal
| Conflitos simultâneos | Empresas | Percentual |
|---|---|---|
| 0 (limpo) | 33 | 55,0% |
| 1 | 24 | 40,0% |
| 2 | 3 | 5,0% |
| 3 (todas as verificações falham) | 0 | 0,0% |
55% das empresas deste painel passam nas três verificações sem nenhuma ressalva. Nenhuma empresa da amostra falhou nas três simultaneamente — o pior caso teórico nunca apareceu. Das 27 empresas (45,0%, IC 95% [33,1%, 57,5%]) que carregam pelo menos um sinal, a grande maioria (24 de 27) carrega exatamente um, e é quase sempre o mesmo.
O que "Dívida vs Caixa" realmente sinaliza
Toda nota de nível RISCO de Dívida vs Caixa neste painel segue o mesmo padrão: uma relação dívida/patrimônio bem acima de 1x combinada com caixa que cobre apenas uma fração da dívida total (por exemplo: HD: D/PL 3,3, o caixa cobre 0,0x da dívida; CAT: D/PL 1,9, o caixa cobre 0,1x da dívida). Isso é um sinal de alavancagem — quanta dívida está no balanço em relação ao colchão de caixa disponível para servi-la — não um sinal de qualidade contábil. É mecanicamente muito mais comum que um negócio maduro e intensivo em capital carregue alavancagem significativa do que que seus lucros mostrem manipulação aguda de accruals, e a diferença de frequência de 13 vezes nestes dados é consistente com essa distinção básica.
Nem toda empresa de baixa resiliência tem um conflito
Sete empresas neste painel caem no nível de resiliência BAIXO. Apenas três delas (STX, casos parecidos com HD, SHW/KO com RISCO em Dívida vs Caixa, STX com dois sinais simultâneos) chegaram lá por meio de uma penalização da matriz de consistência. As outras quatro — INTC, OXY, SNDK, e mais uma — chegaram à resiliência BAIXA com uma pontuação base fraca e zero conflitos: cada componente individual (Cobertura Caixa/Dívida, Autossuficiência de Investimento, Qualidade dos Resultados, Prazo de Liquidez) simplesmente pontuou baixo por seus próprios méritos, sem que nada contradissesse mais nada. Essa é uma situação significativamente diferente do caso da Oracle: "consistentemente fraco em todos os aspectos" e "internamente contraditório" são dois modos de falha diferentes, e este painel mostra que ambos ocorrem, sendo a falha impulsionada por contradição a menos comum das duas.
Discussão
A descoberta inverte a intuição que motivou todo este projeto. O sinal estilo Oracle — uma métrica de aparência dramática ao lado de um sinal de alerta de qualidade dos lucros — é genuinamente raro, na mesma taxa de 3,3% que a outra verificação de "qualidade" (Crescimento vs FCF). Também é, não por coincidência, o tipo de sinal mais interessante narrativamente, que é exatamente por que se prestou, em primeiro lugar, a uma cobertura em vídeo convincente. Mas o conflito que de fato impulsiona quase todas as penalizações de resiliência em um amplo recorte transversal de grandes empresas de capital aberto bem conhecidas é o menos dramático: alavancagem comum do balanço. A superamostragem de manipuladores por Beneish (1999) para obter um conjunto de dados viável, e a confirmação em nível populacional de Dechow et al. (2011) de que erros são raros, ambas apontam na mesma direção que nossos dados: a história dramática sobre qualidade contábil é o evento de cauda, não a norma — e um modelo construído para capturá-la deveria esperar sinalizá-la raramente, que é exatamente o que aconteceu aqui.
Conclusão prática para a DuelStocks
Isso provavelmente muda a forma como os próprios sinais do Resilience Report deveriam ser discutidos, e é uma oportunidade genuína de conteúdo, não apenas uma nota de rodapé de pesquisa:
- Reformular o ângulo de marketing. A história estilo Oracle de "inflação de lucros escondida" é um ótimo gancho, mas é a exceção, não o que o modelo captura na maioria das vezes. O posicionamento honesto, e possivelmente mais útil, é: "Nosso modelo captura principalmente risco comum de alavancagem — o tipo que aparece em aproximadamente 4 de cada 10 empresas que verificamos — não apenas o drama raro de qualidade contábil." Esse é um sinal de confiança mais forte do que sugerir que todo sinal é uma história do calibre da Oracle, e é apoiado por esses dados, e não por um único caso.
- Uma linha de calibração no próprio relatório STR — algo como "sinais de Dívida vs Caixa ocorrem em ~43% das empresas que analisamos; sinais de ROIC vs Sloan ocorrem em ~3%" — permitiria a um leitor julgar imediatamente se um determinado sinal é comum ou genuinamente inusual, em vez de ler cada nota de ATENÇÃO/RISCO como igualmente alarmante. Essa é uma sugestão de produto que vale a pena considerar, não uma mudança sendo feita com base em um único piloto.
- Um próximo Short natural: "O Verdadeiro Motivo da Maioria das Penalizações de Resiliência (Dica: Não É Fraude Contábil)" — a estatística de 43% de Dívida vs Caixa é um gancho forte, honesto e nada sensacionalista, diretamente defensável com números reais, diferente de um vídeo genérico de "cuidado com os sinais de alerta".
Limitações
Duas das três taxas ainda não são estimadas de forma confiável. Crescimento vs FCF e ROIC vs Sloan têm, cada uma, apenas 2 eventos observados em 60 empresas — abaixo do mínimo de referência de Cochran (1977), de 5, para uma estimativa de taxa estável. Seus intervalos de Wilson (ambos [0,9%, 11,4%]) são amplos em relação à sua estimativa pontual, e a taxa populacional real de qualquer uma das métricas poderia plausivelmente ser o dobro ou a metade do que observamos aqui. A estimativa de Dívida vs Caixa, com 26 eventos, está em base muito mais sólida.
Transversal, uma única fotografia. Se essas taxas base se mantêm daqui a um ano, ou em um conjunto diferente de 60 empresas, não foi testado.
A composição setorial importa e não é controlada. Este painel tende a empresas grandes e estabelecidas de capital aberto; um painel mais ponderado para empresas menores ou recém-listadas poderia mostrar uma mistura de alavancagem/accruals completamente diferente.
O mesmo painel do texto de PCA, propositalmente — isso permite que os dois estudos sejam lidos juntos, mas também significa que nenhum dos dois é uma replicação totalmente independente da população do outro.
Nada disso muda a pontuação real do DUEL ou a lógica de penalização no produto. É uma descoberta de taxa base sobre a frequência com que cada sinal dispara no mundo real, não uma proposta para alterar os limiares subjacentes.
Conclusão
Das três verificações de consistência no modelo de resiliência do DUEL, uma — Dívida vs Caixa — dispara em aproximadamente 4 de cada 10 empresas verificadas. As outras duas, incluindo exatamente o tipo de sinal que inspirou esta pesquisa (ROIC vs Sloan), disparam cada uma em cerca de 1 em 30. A história dramática é a rara. A comum é a alavancagem ordinária — que é, de sua própria forma, a coisa mais útil para uma verificação de resiliência estar capturando de forma confiável.
Como sempre: o Resilience Report completo de cada duelo, com cada número bruto por trás desses sinais, está disponível no duelstocks.
Referências
Beneish, M. D. (1999). The detection of earnings manipulation. Financial Analysts Journal, 55(5), 24–36.
Cochran, W. G. (1977). Sampling Techniques (3ª ed.). Wiley.
Dechow, P. M., Ge, W., Larson, C. R., & Sloan, R. G. (2011). Predicting material accounting misstatements. Contemporary Accounting Research, 28(1), 17–82.
Newcombe, R. G. (1998). Two-sided confidence intervals for the single proportion: comparison of seven methods. Statistics in Medicine, 17(8), 857–872.
Sloan, R. G. (1996). Do stock prices fully reflect information in accruals and cash flows about future earnings? The Accounting Review, 71(3), 289–315.
Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212.
Uma análise metodológica em profundidade da DuelStocks. Não é aconselhamento financeiro. Todos os dados vêm de relatórios públicos da SEC EDGAR.
Uma nova pesquisa mostra que um modelo de ações com 8 fatores se reduz a quatro sinais: conversão de caixa, eficiência de capital, qualidade dos accruals e crescimento.
A pergunta
O DUEL pontua cada duelo com base em oito métricas fundamentais, cada uma com um peso fixo: Crescimento de Receita (16%), Margem de Caixa Operacional (15%), ROIC (15%), Sloan Ratio (12%, invertido), Giro de Ativos (10%), Giro de Recebíveis (8%), Margem Operacional (12%) e Margem de FCF (12%). O desenho de "vencedor leva tudo" trata implicitamente cada métrica como uma evidência independente.
Índices financeiros raramente cooperam com essa suposição. Pinches, Mingo e Caruthers (1973) foram os primeiros a mostrar, usando análise fatorial, que um grande conjunto de índices financeiros colapsa em um punhado de dimensões subjacentes — não no número de índices com que se começou. Chen e Shimerda (1981) levaram o ponto mais adiante com uma ilustração clara: patrimônio líquido/dívida, dívida/patrimônio líquido, patrimônio líquido/ativos e dívida/ativos parecem quatro índices, mas carregam entre si exatamente uma única informação. Se duas das oito métricas do DUEL se movem juntas entre empresas, um peso nominal combinado de 24-27% pode, na verdade, estar votando uma vez, não duas.
Pergunta de pesquisa: quantos sinais estatisticamente independentes estão realmente codificados nas oito métricas do DUEL, e como eles se agrupam?
Dados e método
Painel: 30 novos duelos realizados neste ciclo, nenhum repetido de coberturas anteriores — 60 empresas de tecnologia, saúde, industriais, bens de consumo básico, varejo, energia, telecomunicações, semicondutores, materiais e viagens & lazer. A diversidade setorial aqui é um recurso, não ruído: ela testa se a estrutura de correlação se mantém em modelos de negócio muito diferentes, não apenas dentro de um setor.
Variáveis: os oito valores brutos de métrica por empresa, retirados diretamente do detalhe de cálculo de cada Battle Report (não o resultado de vitória/derrota).
Dados faltantes: ROIC e Margem Operacional não estavam disponíveis para OXY e COP (lacunas de itens específicos do setor), e o Giro de Recebíveis não estava disponível para NFLX e PEP. As correlações de Pearson e Spearman usam observações completas em pares (prática padrão); a PCA usa as 56 empresas com registros completos nas oito métricas.
Correlação: tanto Pearson (linear) quanto Spearman (baseada em ranques) foram calculadas. Spearman é relevante aqui porque várias métricas — Sloan Ratio, Margem de FCF, ROIC em alguns casos — apresentam outliers e assimetria (o ano de ROIC de -34% da Ford (F), o Giro de Recebíveis de 82x da MO), e Pearson isoladamente pode ser distorcida por um punhado de valores extremos.
PCA: entradas padronizadas (escores z), análise de componentes principais baseada em correlação, critério de Kaiser (autovalor > 1) como primeiro corte, variância explicada acumulada como segundo, e uma rotação varimax (Kaiser, 1958) nos componentes necessários para atingir 80% da variância, para uma estrutura de cargas mais interpretável.
Tamanho da amostra, com honestidade: 56-60 observações ainda estão abaixo do conforto dos livros-texto, embora tenham se aproximado de forma significativa desde a primeira rodada desta análise (46-50). Comrey e Lee (1992) classificam N=50 como "muito pobre" e N=100 como "pobre" para trabalho fatorial-analítico; a regra de 10 observações por variável de Nunnally (1978) exigiria 80. O que temos a nosso favor: Guadagnoli e Velicer (1988) descobriram que o tamanho de amostra necessário cai bruscamente quando as cargas são fortes e claramente separadas — e, como os resultados abaixo mostram, as nossas são, em sua maioria. Este é um piloto exploratório, no mesmo espírito do nosso estudo setorial Bradley-Terry anterior — uma primeira rodada destinada a ser expandida, não um resultado confirmatório. (Vale notar desde já que adicionar essas 10 empresas mudou a estrutura da resposta — ver abaixo. Isso não é uma falha do método; é exatamente o tipo de instabilidade que um piloto de N pequeno deve revelar.)
Resultados
Estrutura de correlação
As relações par-a-par mais fortes no painel de 60 empresas (Pearson / Spearman):
| Par | Pearson r | Spearman ρ |
|---|---|---|
| Margem de Caixa Operacional ↔ Margem Operacional | 0,76 | 0,75 |
| Margem de Caixa Operacional ↔ Margem de FCF | 0,70 | 0,75 |
| Margem Operacional ↔ Margem de FCF | 0,66 | 0,60 |
| Giro de Ativos ↔ Giro de Recebíveis | 0,56 | 0,56 |
| Margem de Caixa Operacional ↔ Giro de Ativos | -0,49 | -0,53 |
| ROIC ↔ Margem Operacional | 0,49 | 0,53 |
| ROIC ↔ Giro de Ativos | 0,46 | 0,62 |
| Crescimento de Receita ↔ Margem Operacional | 0,45 | 0,23 |
| Crescimento de Receita ↔ Margem de FCF | 0,45 | 0,26 |
Três das métricas baseadas em margem do DUEL — Margem de Caixa Operacional, Margem Operacional e Margem de FCF — correlacionam-se entre si em r ≈ 0,66-0,76. Isso não é coincidência de nomenclatura: as três são, mecanicamente, numeradores diferentes (fluxo de caixa operacional, resultado operacional, fluxo de caixa operacional menos CapEx) divididos pelo mesmo denominador (receita). Uma empresa que opera com uma margem operacional ampla tende a converter isso em caixa em uma taxa semelhante. Separadamente, Giro de Ativos e Giro de Recebíveis — ambos índices de receita sobre um item de balanço — se movem juntos em r ≈ 0,56, exatamente o tipo de agrupamento de "mesmo denominador" que Chen e Shimerda (1981) documentaram quarenta anos atrás em um conjunto de dados diferente. O ROIC agora mostra uma relação mais clara tanto com o grupo de margem quanto com o grupo de giro do que mostrava na amostra menor — um ponto ao qual voltamos abaixo.
A única métrica que se destaca isoladamente em ambas as matrizes, em ambos os tamanhos de amostra: o Sloan Ratio. Sua correlação mais forte com qualquer outra coisa no painel é -0,30 (Spearman, versus Giro de Recebíveis) — mais fraca do que quase todos os pares na tabela acima. O Sloan Ratio mede algo que as outras sete métricas não medem: se os lucros contábeis estão sendo gerados com accruals incomumente grandes em vez de caixa. Essa é uma pergunta genuinamente diferente de "quão lucrativo" ou "quão eficiente", e a matriz de correlação reflete isso tanto com 50 quanto com 60 empresas.
Quantos componentes? (e por que a resposta mudou)
| CP | Autovalor | Variância Explicada | Acumulada |
|---|---|---|---|
| CP1 | 3,17 | 39,0% | 39,0% |
| CP2 | 2,15 | 26,4% | 65,4% |
| CP3 | 0,91 | 11,1% | 76,6% |
| CP4 | 0,73 | 8,9% | 85,5% |
| CP5–CP8 | cada <0,5 | — | 100% |
Pelo critério de Kaiser (autovalor > 1), dois componentes ainda importam — consistente com a primeira rodada. Mas o corte de 80% de variância acumulada agora recai em quatro componentes (76,6% em três, 85,5% em quatro), não três. Adicionar 10 empresas não apenas acrescentou precisão — mudou qual corte o terceiro componente ultrapassa.
Vale a pena ser transparente sobre isso em vez de suavizar silenciosamente. É uma ilustração de livro-texto exatamente da instabilidade sobre a qual Guadagnoli e Velicer (1988) e Comrey e Lee (1992) alertam nesse tamanho de amostra: soluções de componentes com N pequeno podem mudar à medida que os dados se acumulam, e um componente situado exatamente em um limiar (o CP3 estava em 80,0% com 46 empresas, 76,6% com 56) é o primeiro a se mover. Estamos relatando a solução de 4 componentes abaixo porque é a que de fato satisfaz o critério declarado de 80% na amostra maior e mais atual — não porque conte uma história mais organizada.
O que os componentes realmente medem
Rotação varimax dos quatro componentes necessários para 80%+ de variância, nas 56 empresas com registros completos:
| Métrica | RC1 "Conversão de Caixa" | RC2 "Eficiência de Capital" | RC3 "Qualidade dos Accruals" | RC4 "Crescimento" |
|---|---|---|---|---|
| Margem Operacional | 0,59 | 0,08 | 0,04 | -0,07 |
| Margem de Caixa Operacional | 0,50 | -0,17 | 0,04 | 0,05 |
| Margem de FCF | 0,43 | -0,12 | -0,22 | 0,17 |
| ROIC | 0,41 | 0,58 | 0,12 | -0,24 |
| Giro de Ativos | -0,14 | 0,60 | 0,08 | 0,06 |
| Giro de Recebíveis | -0,14 | 0,49 | -0,23 | 0,11 |
| Sloan Ratio | -0,02 | -0,03 | 0,93 | 0,05 |
| Crescimento de Receita | 0,07 | 0,09 | 0,04 | 0,94 |
A amostra maior separou o Crescimento de Receita do grupo de margem em vez de fundi-lo com ele — com 50 empresas, a carga dominante do Crescimento de Receita era de 0,42 no fator de margem; com 60, é de 0,94 em seu próprio fator e essencialmente zero em qualquer outro lugar. Em retrospecto, isso faz sentido econômico: uma empresa pode estar crescendo rápido com margens finas (muitos dos nomes mais novos de software e viagens nesta atualização — CCL, RCL, XYZ — são exatamente essa combinação), então crescimento e qualidade de margem não precisam se mover juntos, e com mais empresas no painel, os dados tornaram essa distinção clara em vez de borrá-la em um único fator.
O quadro do ROIC também se tornou mais nítido: ele agora carrega de forma cruzada tanto no fator de Conversão de Caixa (0,41) quanto na Eficiência de Capital (0,58, ainda dominante) — um lembrete de que o ROIC é, por construção, uma mistura de um elemento semelhante a margem (retorno) e um elemento semelhante a giro (intensidade de capital), então alguma carga cruzada é esperada, não um artefato dos dados.
Mapeados nos pesos de pontuação reais do DUEL, as oito métricas agora se resolvem em quatro blocos efetivos em vez de três:
| Fator Empírico | Métricas | Peso Nominal Combinado |
|---|---|---|
| RC1 — Conversão de Caixa | Margem de Caixa Operacional, Margem Operacional, Margem de FCF | 39% |
| RC2 — Eficiência de Capital | ROIC, Giro de Ativos, Giro de Recebíveis | 33% |
| RC4 — Crescimento | Crescimento de Receita | 16% |
| RC3 — Qualidade dos Accruals | Sloan Ratio | 12% |
39/33/16/12 — visivelmente mais equilibrado do que a divisão de três fatores 55/33/12 da amostra menor, e isso surgiu por conta própria, a partir de mais dados, não de qualquer ajuste no modelo.
Discussão
A descoberta aponta em uma direção fácil de perder se você pensar em "redundância" apenas como uma falha. Duas coisas são verdadeiras ao mesmo tempo:
Primeiro, cerca de 72% do peso nominal do modelo (o bloco de 39% de Conversão de Caixa mais o bloco de 33% de Eficiência de Capital) está apoiado em dois sinais empíricos, não seis. Quando Margem Operacional, Margem de Caixa Operacional e Margem de FCF favorecem todas a mesma empresa — o que a estrutura de correlação diz que acontecerá com mais frequência do que o acaso — essa empresa não está coletando três votos independentes. Está coletando um voto forte, contado três vezes. Isso não necessariamente produz um vencedor "errado"; a qualidade de margem é genuinamente mais informativa do que qualquer índice único que a mede. Mas significa que a distribuição prática de peso se comporta como um modelo de 4 fatores (39/33/16/12) em vez do modelo de 8 fatores que o placar exibe.
Segundo, e esta é a parte que vale a pena examinar com cuidado: a métrica que um leitor casual poderia supor ser o "acréscimo mais redundante" — o Sloan Ratio, aquela que a maioria das pessoas não reconhece pelo nome — é estatisticamente a métrica menos redundante de todo o modelo, em ambos os tamanhos de amostra que já testamos. Ela compartilha quase nenhuma variância com qualquer outra coisa que o DUEL mede. Em nossa cobertura de duelos anterior, o Sloan Ratio apareceu como a única métrica responsável por sinalizar risco de qualidade de lucros em uma empresa que, de outra forma, parecia forte. Esta análise diz que isso não é coincidência de um único caso: estruturalmente, o Sloan Ratio está fazendo um trabalho para o qual nenhuma das outras sete métricas está equipada, o que é exatamente por que ele não é correlacionado com elas.
Uma nota prática, para leitores que veem "39/33/16/12" e pensam "só ajustar os pesos"
Duas reações intuitivas a uma descoberta como essa merecem ser tratadas diretamente, porque ambas estão erradas da mesma forma sutil.
Reação um: "Se a estrutura real é de quatro fatores, basta reduzir o modelo para quatro métricas." Isso confunde sobreposição estatística com desperdício. Quando três métricas de margem concordam sobre uma empresa, isso não significa que as três métricas não estejam dizendo nada de novo — significa que três números calculados de forma independente (a partir do fluxo de caixa operacional, do resultado operacional, do fluxo de caixa operacional menos CapEx) convergem para a mesma conclusão. Essa convergência está mais próxima de uma segunda e terceira opinião a partir de testes diferentes do que de um único teste feito três vezes. Um médico que solicita pressão arterial, frequência cardíaca em repouso e um ECG não está desperdiçando dois exames apenas porque os três geralmente se movem juntos em um paciente saudável — a concordância em si é informativa, e na rara empresa em que discordam, essa discordância é exatamente o tipo de sinal que um modelo de métrica única perderia completamente. Reduzir para quatro métricas removeria essa verificação cruzada, não apenas a redundância.
Reação dois: "Se o Sloan Ratio é o menos redundante, dê a ele ~30% de peso para que os fatores fiquem em aproximadamente 33/33/33." Esta é uma versão de aparência mais sofisticada do mesmo erro. A PCA diz o quanto uma métrica se sobrepõe às outras — não diz nada sobre o quão confiável ou preditiva essa métrica é por si só. O Sloan Ratio é calculado a partir de apenas uma relação contábil (lucro líquido versus fluxo de caixa versus ativos totais), é mais sensível ao problema de descompasso de período trimestre/ano sinalizado no próprio aviso de cada Battle Report, e — como este mesmo painel mostra (o Sloan Ratio de +27,6% da SNDK, impulsionado por um ano incomum de venda de ativos, é o valor mais extremo em todo o conjunto de dados) — ele pode oscilar fortemente devido a eventos contábeis pontuais. Triplicar seu peso só porque ele por acaso é estatisticamente não correlacionado com tudo mais significaria apostar um terço da pontuação final na métrica mais ruidosa e menos diversificada do modelo. Ser "independente" e ser "confiável em peso alto" não são a mesma propriedade, e confundi-las é um erro maior do que a redundância com que este artigo começou.
O que isso realmente argumenta, concretamente:
- Nenhuma mudança nas oito métricas publicadas ou em seus pesos no duelstocks.com. Cada métrica ainda é um cálculo real, distinto, derivado da SEC, visível por completo no detalhe de cálculo de cada relatório — nada aqui sugere que algum número seja fabricado, duplicado ou errado. Esta é uma descoberta sobre comportamento estatístico em muitas empresas, não um defeito em nenhum duelo individual.
- A leitura honesta de "39/33/16/12" é um mapa, não um veredito. Ela diz que, se você quiser mudar de forma significativa o resultado de um duelo, mover uma das três métricas de Conversão de Caixa ou uma das três métricas de Eficiência de Capital fará menos do que se esperaria (suas métricas-irmãs puxam para a mesma conclusão), enquanto Sloan Ratio e Crescimento de Receita carregam, cada um, seu peso nominal completo, não diluído.
- O verdadeiro próximo teste é uma verificação de robustez, não uma reponderação. A pergunta aberta e testável que isso levanta para cobertura futura: reduzir de fato à metade o peso combinado das três métricas de Conversão de Caixa muda o vencedor de algum duelo passado? Se a resposta for "raramente", isso é tranquilizador — significa que a sobreposição é corroboração, não manipulação da pontuação por contagem tripla. Se muda vários resultados, isso também vale a pena saber. De qualquer forma, essa é uma pergunta para um artigo de acompanhamento com infraestrutura de backtesting que este projeto ainda não tem — não um motivo para ajustar manualmente uma fórmula com base em uma única rodada exploratória de PCA.
Limitações
Este é um piloto, e deve ser lido como tal:
- Tamanho da amostra. 56-60 empresas estão mais próximas de um nível confortável do que nossa primeira rodada (46-50), mas ainda abaixo do limiar "pobre" de 100 de Comrey e Lee (1992). A estrutura de componentes já mudou uma vez entre 50 e 60 empresas (três fatores → quatro) — evidência direta de que pode mudar de novo com o próximo lote. Trate a divisão 39/33/16/12 como a melhor estimativa atual, não como um número definitivo.
- Transversal, não longitudinal. Isto é um retrato de um momento. Se a mesma estrutura de quatro fatores se mantém dentro de um ano, ao longo de um ciclo completo de mercado, é uma pergunta aberta — e provavelmente o próximo passo natural para essa linha de trabalho.
- Períodos de reporte mistos. Várias empresas neste painel misturam períodos trimestrais e anuais para métricas individuais (conforme sinalizado em cada Battle Report). Não aplicamos aqui uma correção de harmonização TTM; se essa correção deslocar significativamente os valores de empresas individuais, ela também poderia deslocar a estrutura de correlação na margem. Essa é uma questão metodológica separada, que podemos abordar diretamente em um texto futuro.
- Quatro empresas com métricas ausentes. OXY e COP foram excluídas da PCA (faltam dados de ROIC/Margem Operacional), e NFLX/PEP foram incluídas nas correlações, mas não na PCA (falta Giro de Recebíveis). Nenhuma foi excluída por seus resultados — apenas por lacunas de dados.
Nada disso muda a pontuação real do DUEL no produto. É uma descoberta metodológica, não uma decisão de produto — a mesma distinção que temos tentado manter em cada texto desta série.
Conclusão
Oito métricas, um esquema de ponderação fixo, e — neste piloto agora com 60 empresas — quatro sinais empiricamente distinguíveis por trás dele: conversão de caixa, eficiência de capital, qualidade dos accruals e crescimento, cada um se comportando separadamente dos demais. A divisão nominal de 16/15/15/12/10/8/12/12% está, na prática, mais próxima de uma divisão de 39/33/16/12% quando se leva em conta o que as métricas realmente medem versus como são nomeadas — e esse número se moveu em direção a mais equilíbrio, não menos, à medida que a amostra crescia, sem que ninguém tocasse na fórmula. Isso é um motivo para continuar coletando dados, não um motivo para começar a ajustar pesos manualmente com base em uma única rodada.
Como sempre: calcule os números você mesmo em duelstocks.com — cada relatório de duelo mostra seu detalhe de cálculo completo, que é exatamente o que tornou esta análise possível em primeiro lugar.
Referências
Chen, K. H., & Shimerda, T. A. (1981). An empirical analysis of useful financial ratios. Financial Management, 10(1), 51–60.
Comrey, A. L., & Lee, H. B. (1992). A First Course in Factor Analysis (2ª ed.). Erlbaum.
Gombola, M. J., & Ketz, J. E. (1983). A note on cash flow and classification patterns of financial ratios. The Accounting Review, 58(1), 105–114.
Guadagnoli, E., & Velicer, W. F. (1988). Relation of sample size to the stability of component patterns. Psychological Bulletin, 103(2), 265–275.
Jolliffe, I. T. (2002). Principal Component Analysis (2ª ed.). Springer.
Kaiser, H. F. (1958). The varimax criterion for analytic rotation in factor analysis. Psychometrika, 23(3), 187–200.
Nunnally, J. C. (1978). Psychometric Theory (2ª ed.). McGraw-Hill.
Pinches, G. E., Mingo, K. A., & Caruthers, J. K. (1973). The stability of financial patterns in industrial organizations. Journal of Finance, 28(2), 389–396.
Sloan, R. G. (1996). Do stock prices fully reflect information in accruals and cash flows about future earnings? The Accounting Review, 71(3), 289–315.
Não é aconselhamento financeiro. Todos os dados vêm de relatórios públicos da SEC EDGAR.
Nota histórica. Este texto descreve a regra winner-take-all já retirada da DUEL, segundo a qual o nome com melhor pontuação em cada métrica levava todo o peso daquela métrica. A DUEL agora usa pontuações relativas suaves, que escalam cada métrica pela dimensão da diferença, não apenas pelo seu sinal — veja «Quão frágil é o novo placar relativo de ações?» mais acima.
Análise metodológica em profundidade, números reais de duelos reais, calculados e verificados do zero. Não é aconselhamento financeiro.
Nosso primeiro texto desta série sinalizou algo que merece ser revisitado: os pesos por trás do nosso placar relativo de "duelo" — Crescimento de Receita 16%, Margem de Caixa Operacional 15%, ROIC 15%, Sloan Ratio 12%, Giro de Ativos 10%, Giro de Recebíveis 8%, Margem Operacional 12%, Margem de FCF 12% — são um ponto de partida razoável definido por especialistas, não algo testado retroativamente contra retornos realizados. A ferramenta permite que qualquer usuário os substitua por pesos personalizados, o que levanta uma pergunta que vale a pena testar de fato em três níveis diferentes de rigor: o quanto o vencedor muda se uma pessoa razoável escolher pesos diferentes, igualmente defensáveis?
Nível 1: como o placar funciona, e um número de fragilidade limpo
Para cada uma das oito métricas, as duas empresas são comparadas, e a que obtém a pontuação mais alta (a mais baixa, no caso do Sloan Ratio, que é invertido) leva todo o peso daquela métrica — vencedor leva tudo por métrica, sem gradação pelo tamanho da diferença. O placar final é a soma dos pesos associados às métricas que cada empresa vence. Validamos isso reconstruindo o placar exato dos 8 duelos publicados até hoje a partir dos valores brutos das métricas — todos coincidiram exatamente.
Essa estrutura oferece, de graça, uma medida de fragilidade limpa e independente do modelo: mover um peso Δ de qualquer métrica que o vencedor venceu para qualquer métrica que o perdedor venceu altera a diferença de placar em 2Δ, então a realocação mínima necessária para virar um duelo é simplesmente diferença ÷ 2.
| Duelo | Placar | Diferença | Pontos de peso para virar |
|---|---|---|---|
| NVDA vs AMD | 92:8 | 84 | 42,0 |
| GOOGL vs META | 10:90 | 80 | 40,0 |
| AMZN vs WMT | 55:45 | 10 | 5,0 |
| CRM vs NOW | 32:68 | 36 | 18,0 |
| VRTX vs REGN | 61:39 | 22 | 11,0 |
| GFF vs WOR | 73:27 | 46 | 23,0 |
| BHE vs PLAB | 30:70 | 40 | 20,0 |
| KO vs PEP | 75:25 | 50 | 25,0 |
AMZN vs WMT é o outlier claro — frágil em uma ordem de magnitude comparado a tudo mais no conjunto de dados.
Nível 2: Monte Carlo — a aleatoriedade concorda com a álgebra?
O número diferença÷2 é exato, mas estático — ele não diz o quão provável é uma virada se os pesos forem sorteados de um intervalo realista em vez de deliberadamente projetados. Executamos 10.000 simulações por duelo, cada uma sorteando cada peso de forma independente dentro de ±50% de seu valor padrão, depois renormalizando para somar 100% — uma abordagem padrão de perturbação para testar sensibilidade em sistemas de pontuação multicritério.
| Duelo | Diferença | Taxa de virada por Monte Carlo (10.000 sorteios) |
|---|---|---|
| NVDA vs AMD | 84 | 0,0% |
| GOOGL vs META | 80 | 0,0% |
| AMZN vs WMT | 10 | 14,8% |
| CRM vs NOW | 36 | 0,0% |
| VRTX vs REGN | 22 | 1,3% |
| GFF vs WOR | 46 | 0,0% |
| BHE vs PLAB | 40 | 0,0% |
| KO vs PEP | 50 | 0,0% |
A simulação e a álgebra concordam completamente: todo duelo com diferença ≥36 não virou em nenhum dos 10.000 sorteios aleatórios. Os dois duelos mais estreitos (diferença ≤22) são os únicos que chegam a virar, e a taxa escala conforme o quão próxima de zero está a diferença. Essa concordância já é, por si só, digna de nota — um simples atalho combinatório (diferença÷2) previu o resultado empírico da simulação sem executar um único sorteio aleatório.
Outra coisa que a simulação revela e que a álgebra por si só não pode: qual métrica tende a causar a virada. Olhando especificamente para os 14,8% das simulações de AMZN-vs-WMT em que o vencedor mudou, podemos perguntar qual fator carregava o maior peso, por acaso, nesses sorteios específicos:
- ROIC foi o maior peso em 64,6% das viradas
- Sloan Ratio em 12,4%
- Crescimento de Receita em 9,6%
- Tudo o mais, combinado, abaixo de 14%
O ROIC domina o mecanismo de virada para esse par por uma margem ampla — uma resposta útil e específica para "o que realmente decide isso", não apenas "quão provável é uma virada".
Nível 3: o peso de uma métrica realmente equivale ao seu poder? (índices de Shapley-Shubik e Banzhaf)
Aqui está uma pergunta mais sutil que os dois primeiros níveis não abordam de forma alguma: o peso declarado de uma métrica é a mesma coisa que sua influência real sobre quem vence? Em 1954, Lloyd Shapley e Martin Shubik fizeram exatamente essa pergunta sobre órgãos de votação ponderada (é a mesma matemática usada depois para analisar o poder de voto no Conselho de Ministros da UE e no Conselho de Segurança da ONU) — e mostraram que a participação nominal no voto e o poder decisivo real frequentemente não são o mesmo número. Um bloco de votação pode ter 20% dos votos e quase nenhum poder de mudar qualquer resultado, ou ter 10% e ser constantemente decisivo, dependendo de como os demais votos estão distribuídos.
Nossa estrutura de "vencedor leva tudo por métrica" é, matematicamente, exatamente esse tipo de jogo de votação ponderada: oito "eleitores" (as métricas), cada um com um peso fixo, decidindo por maioria simples (>50%) qual lado vence. Então calculamos o índice Shapley-Shubik (e, como verificação cruzada, o índice Banzhaf relacionado) para cada métrica sob os pesos padrão — avaliando, em todas as 2⁸ = 256 formas possíveis de dividir as oito métricas entre dois lados, com que frequência cada métrica é a que faz o resultado pender para um lado.
| Métrica | Peso Declarado | Poder Shapley-Shubik | Poder ÷ Peso |
|---|---|---|---|
| Crescimento de Receita | 16,0% | 18,2% | 1,14x |
| Margem de Caixa Operacional | 15,0% | 16,1% | 1,07x |
| ROIC | 15,0% | 16,1% | 1,07x |
| Sloan Ratio | 12,0% | 11,8% | 0,98x |
| Margem Operacional | 12,0% | 11,8% | 0,98x |
| Margem de FCF | 12,0% | 11,8% | 0,98x |
| Giro de Ativos | 10,0% | 8,2% | 0,82x |
| Giro de Recebíveis | 8,0% | 6,1% | 0,76x |
O padrão é real, ainda que limitado em vez de dramático: métricas maiores carregam sistematicamente mais poder decisivo do que seu peso declarado sugere, e as menores carregam sistematicamente menos. O Giro de Recebíveis é o caso mais claro — seu peso publicado (8%) superestima sua influência real sobre os resultados mais do que qualquer outra métrica, e o mesmo padrão (menor peso, mais superestimado) se manteve quando repetimos o cálculo sob os quatro perfis de ponderação alternativos oficialmente documentados do DUEL (Crescimento, Qualidade, Valor, Dividendo e Estabilidade). Isso não é uma falha específica desta ferramenta — é uma propriedade estrutural de qualquer sistema de pontuação ponderada em que o vencedor leva tudo, formalizada por primeira vez há 70 anos em um campo completamente diferente (teoria da votação), e ela se aplica aqui sem que ninguém a tenha projetado assim de propósito.
Testando contra os perfis reais e publicados de investidores
O DUEL documenta quatro perfis de ponderação nomeados para diferentes estilos de investidor. Aplicando os quatro aos nossos 8 duelos:
| Duelo | Padrão | Crescimento | Qualidade | Valor | Dividendo |
|---|---|---|---|---|---|
| NVDA vs AMD | 92:8 | 95:5 | 95:5 | 85:15 | 92:8 |
| GOOGL vs META | 10:90 | 8:92 | 8:92 | 18:82 | 10:90 |
| AMZN vs WMT | 55:45 | 67:33 | 44:56 (vira) | 40:60 (vira) | 60:40 |
| CRM vs NOW | 32:68 | 37:63 | 17:83 | 32:68 | 40:60 |
| VRTX vs REGN | 61:39 | 64:36 | 56:44 | 65:35 | 56:44 |
| GFF vs WOR | 73:27 | 72:28 | 74:26 | 80:20 | 66:34 |
| BHE vs PLAB | 30:70 | 21:79 | 31:69 | 48:52 | 28:72 |
| KO vs PEP | 75:25 | 72:28 | 84:16 | 72:28 | 71:29 |
Somente AMZN vs WMT vira — o mesmo duelo que todos os outros métodos deste texto sinalizaram, de forma independente, como o frágil. BHE vs PLAB merece menção separada: ele se comprime de uma goleada de 40 pontos para um quase cara-ou-coroa (48:52) sob o perfil Valor, sem tecnicamente virar, porque a BHE vence especificamente as duas métricas — Giro de Ativos e Giro de Recebíveis — nas quais o perfil Valor concentra peso.
O que isso realmente resolve, e o que não resolve
A limitação original era que os pesos-base são uma escolha heurística, não uma escolha testada retroativamente. Nenhum dos três métodos aqui responde se 16/15/15/12/10/8/12/12 prevê melhor os retornos futuros do que qualquer alternativa — essa questão de calibração permanece aberta. O que agora podemos afirmar com três métodos independentes e mutuamente concordantes é o seguinte: a ponderação-base não é frágil de uma forma que importe para o uso prático. Um placar de duelo amplo (diferença ≥30, aproximadamente) sobreviveu a toda perturbação aleatória que aplicamos e a todo perfil alternativo real e nomeado. Um placar estreito é exatamente o ponto em que os três métodos convergem para o mesmo alerta — e, graças à camada de Shapley-Shubik, agora também sabemos que a estrutura de pontuação subjacente subestima sistematicamente métricas menores como o Giro de Recebíveis, independentemente do duelo observado. Essa é uma descoberta genuinamente nova e estrutural sobre o próprio mecanismo, não apenas sobre uma comparação específica — o tipo de resultado que só se obtém testando os fundamentos do modelo com ferramentas construídas exatamente para essa pergunta, em vez de testar pesos um perfil por vez.
Referências
Shapley, L. S., & Shubik, M. (1954). "A Method for Evaluating the Distribution of Power in a Committee System." American Political Science Review, 48(3), 787–792.
Banzhaf, J. F. (1965). "Weighted Voting Doesn't Work: A Mathematical Analysis." Rutgers Law Review, 19, 317–343.
Sloan, R. G. (1996). "Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings?" The Accounting Review, 71(3), 289–315.
Saaty, T. L. (1980). The Analytic Hierarchy Process. McGraw-Hill.
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3ª ed.). Wiley.
Se você quiser reproduzir qualquer parte disso por conta própria — substituir por seus próprios pesos, ou testar um par que não cobrimos — a ferramenta ao vivo pode ser testada gratuitamente em duelstocks.com; todo número deste texto remete a um relatório que você pode obter diretamente lá.
Não é aconselhamento financeiro. Todos os dados vêm de relatórios públicos da SEC EDGAR.
Análise metodológica em profundidade, números reais de duelos reais. Não é aconselhamento financeiro.
Dois textos atrás, na nossa lista de limitações honestas, sinalizamos esta: nosso modelo DCF produz um único número — US$ 176,47, não "US$ 165–190" — sem qualquer noção de o quanto confiar nessa precisão. Damodaran vem apontando isso há décadas: só o valor terminal costuma representar de 60% a 80% do valor da empresa, construído sobre um pressuposto não verificável de crescimento perpétuo. Um número preciso ao centavo, apoiado em uma base que não é tão precisa assim.
Este texto trata de fechar essa lacuna específica — transformar um único número de valor justo em uma faixa defensável, sem usar nada que o modelo já não publique.
Por que não Monte Carlo
Uma simulação completa precisa de distribuições de probabilidade assumidas para cada input — formatos que não conseguimos justificar honestamente com os dados disponíveis. Por isso, usamos algo mais antigo e mais simples: a estimativa de três pontos (PERT), desenvolvida para o programa de míssseis Polaris da Marinha dos EUA em 1959 e ainda padrão na estimativa de custos de projetos.
A lógica: construir um cenário Bear (baixista) e um cenário Bull (altista) a partir dos próprios níveis de qualidade já publicados pelo modelo, e depois combinar:
Esperado ≈ (Bear + 4×Base + Bull) / 6 DP ≈ (Bull − Bear) / 6
Essa construção trata o intervalo (Bear, Bull) como aproximadamente ±3 desvios-padrão, produzindo uma faixa de 1 sigma interpretável sem inventar nenhum input novo. Para Bear/Bull, deslocamos os próprios níveis documentados do modelo em um degrau em cada direção — o multiplicador de crescimento por ROIC, o multiplicador de margem de FCF e o nível de beta baseado em ROIC que determina o WACC — de forma simétrica, usando apenas limiares que o modelo já divulga.
O resultado: 16 empresas, um método
| Ticker | Valor Justo T0 | Valorização em 3A (Estimativa Pontual) | Valorização Ajustada por PERT | Faixa 1σ |
|---|---|---|---|---|
| NVDA | US$ 176,50 | +14,6% | 12,0% ± 2,6% | [9,4%, 14,6%] |
| AMD | US$ 67,77 | +24,0% | 26,1% ± 3,9% | [22,2%, 30,0%] |
| GOOGL | US$ 129,53 | +18,2% | 18,8% ± 5,2% | [13,6%, 24,0%] |
| META | US$ 524,34 | +16,2% | 15,9% ± 4,8% | [11,1%, 20,7%] |
| AMZN | US$ 255,02 | +18,6% | 18,6% ± 4,8% | [13,8%, 23,4%] |
| WMT | US$ 77,87 | +18,7% | 19,1% ± 4,5% | [14,6%, 23,6%] |
| CRM | US$ 416,84 | — | 13,1% ± 4,5% | [8,6%, 17,6%] |
| NOW | US$ 113,89 | — | 18,4% ± 5,4% | [13,0%, 23,8%] |
| VRTX | US$ 257,98 | — | 18,5% ± 4,1% | [14,4%, 22,6%] |
| REGN | US$ 728,55 | — | 22,0% ± 4,4% | [17,6%, 26,4%] |
| GFF | US$ 0,00 | — | — | ver nota abaixo |
| WOR | US$ 17,68 | — | 44,1% ± 0,9% | [43,2%, 45,0%] |
| BHE | US$ 26,76 | — | 25,4% ± 1,9% | [23,5%, 27,3%] |
| PLAB | US$ 19,78 | — | 16,0% ± 1,7% | [14,3%, 17,7%] |
| KO | US$ 18,70 | — | 20,4% ± 1,5% | [18,9%, 21,9%] |
| PEP | US$ 117,24 | — | 21,3% ± 0,3% | [21,0%, 21,6%] |
A largura da faixa já é informativa por si só: ativos de alto crescimento e múltiplos elevados (NVDA, GOOGL, NOW) apresentam faixas mais largas do que geradores de caixa lentos e estáveis (KO, PEP, PLAB) — exatamente o que um método de sensibilidade deveria mostrar, já que um pressuposto mais voltado para o futuro significa mais espaço para divergência sobre ele.
A pergunta que isso foi realmente construído para responder
Nosso primeiro texto desta série afirmava algo que chamou atenção: a NVIDIA venceu seu "duelo" de fundamentos relativos contra a AMD por 92-8, mas a valorização de DCF modelada da AMD (+24,0%) era maior do que a da NVIDIA (+14,6%) — apesar de perder disparado nas métricas operacionais. A pergunta de acompanhamento óbvia: essa diferença era real, ou apenas ruído de uma estimativa pontual que nunca teve margens de erro?
Com as faixas PERT aplicadas, a faixa da NVIDIA é [9,4%, 14,6%] e a da AMD é [22,2%, 30,0%]. As duas não se sobrepõem. A conclusão original resiste a um escrutínio direto sob incerteza de parâmetros — o tipo de verificação que acreditamos que mais conteúdo de avaliação deveria estar dispostos a aplicar às suas próprias afirmações anteriores, em vez de repetir uma estimativa pontual com mais confiança do que ela merece.
Um benefício discreto desta série de pesquisa
Um dos propósitos de conduzir esta série no duelstocks.com é que ela também funciona como uma auditoria do nosso próprio modelo — e este texto já gerou duas melhorias pequenas e concretas na ferramenta em produção. Construir as faixas de sensibilidade exigiu reconstruir manualmente a fórmula do DCF contra relatórios reais, o que revelou um caso extremo em como o valor patrimonial é limitado por baixo para empresas altamente endividadas (agora tratado de forma mais transparente, em vez de por meio de uma substituição de placeholder) e um limite de segurança de crescimento não documentado, agora explicitado diretamente na própria seção de metodologia do relatório. Revisamos os limites reais desse teto em relação ao teto matemático próprio do sistema de níveis e deixamos os números em si inalterados — eles já estavam bem calibrados, situando-se quase exatamente no nível que o próprio sistema de níveis pode produzir por conta própria. Nenhuma das duas mudanças altera qualquer número neste texto; ambas são divulgadas aqui por completude, não porque sejam o ponto central do texto.
Como uma "faixa" poderia se parecer no próprio produto
Atualmente, obter essa faixa significa fazer manualmente a aritmética de deslocamento de níveis contra um relatório DCF publicado — que é exatamente o que este texto demonstra, passo a passo, sem usar nada além do que já está em qualquer relatório DCF que você pode obter hoje. Um próximo passo natural — não um compromisso, apenas uma direção que vale a pena mencionar — seria o próprio relatório DCF eventualmente mostrar esse corredor diretamente: um limite superior e inferior ao lado da projeção pontual de cada ano no gráfico, além de uma pequena tabela suplementar com os mesmos valores Bear/Base/Bull mostrados acima. Seja implementado ou não, o método aqui é totalmente reproduzível manualmente a partir do relatório que você já tem.
O quanto isso realmente resolve da crítica original
Vale a pena ser preciso aqui, já que exagerar isso anularia o propósito do exercício. A limitação original era que o modelo não oferecia forma de avaliar o quanto confiar em um único número de DCF. Este texto fecha essa lacuna no nível metodológico: agora existe uma forma reproduzível, sem necessidade de novos dados, de construir uma faixa defensável em torno de qualquer saída de DCF, e mostramos que ela se sustenta sob um teste de estresse real (a comparação NVDA/AMD). Ela ainda não fecha a lacuna no nível do produto — o relatório em si ainda mostra um único número, e construir a faixa ainda exige que o leitor faça a aritmética descrita aqui. Também não resolve uma terceira pergunta, mais difícil, que não afirmamos ter respondido: se essas faixas, uma vez construídas, realmente contêm os preços futuros realizados a uma taxa próxima dos ~68% declarados — isso requer validação contra resultados ao longo do tempo, o que este texto não tenta fazer. Progresso parcial e honesto sobre uma limitação específica e anteriormente não abordada.
Referências
Damodaran, A. (2012). Investment Valuation: Tools and Techniques for Determining the Value of Any Asset (3ª ed.). Wiley.
Malcolm, D. G., Roseboom, J. H., Clark, C. E., & Fazar, W. (1959). "Application of a Technique for Research and Development Program Evaluation (PERT)." Operations Research, 7(5), 646–669.
Howard, R. A. (1988). "Decision Analysis: Practice and Promise." Management Science, 34(6), 679–695.
Sloan, R. G. (1996). "Do Stock Prices Fully Reflect Information in Accruals and Cash Flows about Future Earnings?" The Accounting Review, 71(3), 289–315.
Project Management Institute — PMBOK Guide, Three-Point Estimating Technique.
Não é aconselhamento financeiro. Todos os dados vêm de relatórios públicos da SEC EDGAR. Divulgação: mantenho uma posição de longa data (~5 anos) em NVDA; nenhuma posição em qualquer outra ação mencionada.
Um estudo piloto da DuelStocks — Avaliação Absoluta vs. Relativa, Parte 2
1. A pergunta em aberto da Parte 1
A Parte 1 desta série separou duas perguntas que rotineiramente são tratadas como uma só:
- Avaliação relativa: a Empresa A está barata ou cara em comparação com a Empresa B?
- Avaliação absoluta (DCF): quanto vale a Empresa A por si só, a partir dos seus próprios fluxos de caixa projetados?
Aplicar ambas a duelos reais (NVDA contra AMD, GOOGL contra META, AMZN contra WMT), mais uma terceira lente — nosso Índice de Resiliência Fundamental (FRI), que pontua a qualidade do balanço e do fluxo de caixa independentemente do preço ou do crescimento — mostrou que o "vencedor" segundo um método não é, de forma confiável, o vencedor segundo outro. Três perguntas diferentes e legítimas; três respostas diferentes e legítimas.
Também registramos uma limitação honesta naquele texto (seção 2.4): um duelo sempre compara apenas duas empresas. A avaliação relativa clássica compara uma empresa a um grupo de pares, não a um rival arbitrário escolhido para uma manchete. Um "vencedor" em pares pode parecer completamente diferente contra outro adversário.
Este texto é uma tentativa direta de fechar essa lacuna — e, igualmente importante, de medir o quanto ela realmente é fechada, em vez de simplesmente afirmar isso.
2. O que esperávamos encontrar, declarado antes de olhar
Antes de calcular os números, escrevemos três expectativas testáveis, para que os resultados abaixo possam ser verificados contra elas, em vez de ajustados a elas depois do fato:
- H1 — Persistência da divergência. Se a divisão relativo/absoluto/resiliência da Parte 1 fosse uma propriedade real dos dados (e não um artefato da escolha de um par específico), ela deveria reaparecer em escala setorial: várias empresas deveriam ficar perto do topo em uma lente e perto do fundo em outra.
- H2 — A resiliência é ortogonal. O FRI mede algo estruturalmente diferente (qualidade do balanço) dos fatores de crescimento e margem (pontuação relativa) ou do valor implícito pelo fluxo de caixa (DCF). Esperávamos que seu ranking correlacionasse fracamente, não fortemente, com os outros dois.
- H3 — Amostras pequenas são ruidosas, mesmo com um modelo "criterioso". Um piloto de 2 rodadas dá a cada empresa apenas 2 pontos de dados. Esperávamos que a ordem de classificação resultante — não importa quão sofisticado matematicamente seja o método de agregação — fosse consideravelmente menos estável do que parece, e projetamos uma forma de quantificar exatamente o quão instável, em vez de apenas sinalizar isso com a palavra "piloto".
As três se confirmaram, inclusive de formas que não antecipamos totalmente (ver seção 6).
3. Método
3.1 Desenho do torneio
Executar um round-robin completo entre 12 empresas (todas contra todas) exigiria 66 duelos — demais para um piloto de conteúdo. Usamos o método do círculo, o algoritmo padrão para programar round-robins parciais em esportes e psicometria, para construir um calendário de 2 rodadas em que o grafo resultante de "quem jogou contra quem" é um único ciclo conectado que toca as 12 empresas (a SWKS foi removida do grupo original de 13 nomes — menor peso no índice, menor distorção ao removê-la).
Rodada 1: NVDA–ON, AVGO–MCHP, MU–MPWR, AMD–MRVL, INTC–QCOM, TXN–ADI Rodada 2: NVDA–MCHP, ON–MPWR, AVGO–MRVL, MU–QCOM, AMD–ADI, INTC–TXN
A conectividade aqui não é uma formalidade, mas algo essencial: as estimativas de força de Bradley–Terry se propagam pelo grafo de quem venceu quem, então, se o grafo se dividisse em dois grupos desconectados, o modelo não teria base para comparar uma empresa de um grupo com uma do outro. Um único ciclo conectado é a estrutura mínima necessária para classificar as 12 empresas umas contra as outras, mesmo que a maioria dos pares nunca tenha jogado diretamente.
3.2 Agregando vitórias/derrotas em uma classificação
A partir dos 12 resultados, calculamos duas medidas de força relativa:
- Pontuação Copeland — vitórias menos derrotas. Transparente, mas grosseira: com apenas 2 jogos, a maioria das empresas cai em um de três grupos (+2, 0 ou −2), gerando muitos empates.
- Classificação Bradley–Terry (BT) — o modelo padrão para dados de comparação pareada (1952; ancestral matemático do sistema Elo). Sob o BT, a probabilidade de i vencer j é s_i / (s_i + s_j), onde s_i é a força estimada de i. Ajustamos as forças por máxima verossimilhança iterativa (o algoritmo MM/Zermelo), o que permite que a força se propague de forma transitiva: vencer uma equipe que ela mesma venceu uma equipe forte conta mais do que vencer uma equipe sem nenhum histórico, mesmo sem comparação direta entre as duas empresas ligadas indiretamente.
Dois históricos neste conjunto de dados são "perfeitos" no sentido matemático relevante para o BT: uma empresa que vence todos os jogos que disputou tem, sem correção, uma força estimada infinita; uma empresa que perde todos os jogos tem uma força estimada de zero. Ambos quebram o modelo. Usamos uma regularização padrão — um pequeno número de jogos fictícios contra um adversário de força média da liga, adicionados a cada empresa — que mantém cada estimativa finita. Isso não é um ajuste cosmético; é o mecanismo que torna a classificação possível com tão poucos dados, e significa que a diferença numérica exata entre posições adjacentes não deve ser sobre-interpretada (mais sobre isso na seção 6).
Em seguida, adicionamos duas classificações que vêm dos próprios relatórios de cada empresa, independentemente de contra quem ela foi pareada:
- Múltiplo de avaliação implícito por DCF — Valor da Empresa ÷ Receita, um resultado do motor DCF do DUEL para cada empresa individualmente (verificado como idêntico em ambos os relatórios de duelo de uma empresa, confirmando que não depende do adversário). Um valor mais alto significa que o motor de fluxo de caixa do modelo atribui mais valor de empresa por dólar de receita, dados os próprios inputs de crescimento, margem e ROIC daquela empresa. Isso não é "potencial de valorização em relação ao preço de mercado" — nenhum preço de mercado ao vivo é usado — é uma leitura transversal de quais perfis de fluxo de caixa o modelo premia.
- Índice de Resiliência Fundamental (FRI) — nosso composto de qualidade de balanço, também específico de cada empresa.
4. Resultados
4.1 Resultados do round-robin
| Duelo | Placar | Vencedor |
|---|---|---|
| NVDA vs ON | 80–20 | NVDA |
| AVGO vs MCHP | 100–0 | AVGO |
| MU vs MPWR | 27–73 | MPWR |
| AMD vs MRVL | 73–27 | AMD |
| INTC vs QCOM | 12–88 | QCOM |
| TXN vs ADI | 57–43 | TXN |
| NVDA vs MCHP | 100–0 | NVDA |
| ON vs MPWR | 12–88 | MPWR |
| AVGO vs MRVL | 100–0 | AVGO |
| MU vs QCOM | 31–69 | QCOM |
| AMD vs ADI | 34–66 | ADI |
| INTC vs TXN | 8–92 | TXN |
4.2 Quatro classificações, lado a lado
| Empresa | Histórico | Copeland | Posição BT | DCF VE/Receita | Posição DCF | Pontuação FRI | Posição FRI |
|---|---|---|---|---|---|---|---|
| TXN | 2-0 | +2 | 1 | 1,90x | 9 | 60 (Moderado) | 11 |
| QCOM | 2-0 | +2 | 2 | 3,54x | 5 | 89 (Alto) | 3 (empate) |
| MPWR | 2-0 | +2 | 3 | 5,27x | 3 | 98 (Alto) | 2 |
| NVDA | 2-0 | +2 | 4 | 19,84x | 1 | 64 (Moderado) | 10 |
| AVGO | 2-0 | +2 | 5 | 16,06x | 2 | 75 (Alto) | 8 |
| ADI | 1-1 | 0 | 6 | 3,87x | 4 | 87 (Alto) | 6 |
| AMD | 1-1 | 0 | 7 | 3,12x | 7 | 100 (Alto) | 1 |
| INTC | 0-2 | -2 | 8 | n/d (VE negativo) | 12 | 32 (Baixo) | 12 |
| MU | 0-2 | -2 | 9 | 0,64x | 11 | 76 (Alto) | 7 |
| ON | 0-2 | -2 | 10 | 1,93x | 8 | 88 (Alto) | 5 |
| MCHP | 0-2 | -2 | 11 | 1,71x | 10 | 73 (Alto) | 9 |
| MRVL | 0-2 | -2 | 12 | 3,45x | 6 | 89 (Alto) | 3 (empate) |
5. Onde as três lentes divergem
A TXN venceu os dois duelos e ocupa a posição #1 no BT, mas fica em #9 de 12 no múltiplo DCF e em #11 na resiliência (sinalizada por alavancagem elevada — dívida/patrimônio próxima de 0,9, cobertura de caixa sobre dívida fraca). O melhor histórico de avaliação relativa do torneio pertence a uma das histórias mais fracas de valor absoluto e balanço do grupo.
A MRVL é quase o espelho disso: última no BT, mas empatada em #3 na resiliência (FRI 89) e no meio da tabela (#6) no múltiplo DCF. Uma leitura puramente relativa não diz quase nada de preciso sobre o balanço da MRVL.
A AMD fica no meio tanto no histórico relativo (1-1) quanto no múltiplo DCF (#7), mas tem a melhor pontuação de resiliência isolada do setor (FRI 100 — nenhuma contradição sinalizada, nota máxima em cada submétrica). Nada disso é visível a partir de quem a AMD venceu.
NVDA e AVGO são os dois nomes em que a camada DCF coincide com a camada relativa (#1 e #2 em ambas) — mas a resiliência diverge. A NVDA cai para #10 no FRI, impulsionada por uma métrica de Prazo de Liquidez bem abaixo do limite de "colchão forte": uma troca real entre força de crescimento/avaliação e colchão de balanço, não ruído.
A INTC é o caso de controle: última ou quase última em todas as lentes, e a única empresa em que o motor DCF retorna um valor de empresa diretamente negativo (fluxo de caixa livre negativo quebra o modelo em vez de apenas baixar o número). Quando o quadro subjacente é genuinamente fraco em todos os aspectos, os três métodos concordam — o que é, por si só, informativo: sugere que a divergência vista em outros lugares é um sinal de fundamentos genuinamente mistos, não o modelo discordando de si mesmo aleatoriamente.
6. O quanto você deveria confiar na posição #1?
Antes de tratar "a TXN está em #1" como uma descoberta sobre a TXN, vale a pena precisar o que realmente está impulsionando esse número.
As duas vitórias da TXN foram contra a INTC (0-2, sem vitórias em nenhum lugar da rede) e a ADI (1-1 — cuja única credencial é uma única vitória sobre a AMD). Em um modelo Bradley–Terry, uma vitória sobre uma equipe que ela mesma já venceu alguém conta mais do que uma vitória sobre uma equipe com histórico vazio, porque a força se propaga de forma transitiva pelo grafo. NVDA, AVGO, QCOM e ADI — as outras quatro equipes 2-0 — cada uma venceu dois adversários que estavam 0-2 sem nenhuma vitória em qualquer lugar da rede. A TXN é a única equipe 2-0 cuja segunda vitória veio contra um adversário (ADI) que carregava uma vitória própria e ativa. Esse único elo indireto é o que separa a posição #1 da TXN no BT de um empate quádruplo no topo.
Isso não é uma falha no método — é exatamente o que o Bradley–Terry foi projetado para fazer. Mas também é exatamente o tipo de resultado que deveria deixá-lo cauteloso em ler demais em uma classificação baseada em 2 jogos por empresa. Para quantificar essa cautela em vez de apenas afirmá-la, executamos uma verificação de Monte Carlo: simular 12 empresas com "forças reais" aleatórias, executar o mesmo calendário do método do círculo, e perguntar com que frequência o #1 do Bradley–Terry e o #1 simples do Copeland discordam, puramente por variação amostral, em diferentes durações de calendário (4.000 torneios simulados por ponto de dados):
| Rodadas por empresa | BT e Copeland discordam sobre o #1 |
|---|---|
| 2 (este piloto) | 64,4% |
| 4 | 34,4% |
| 6 | 25,2% |
| 11 (round-robin completo) | 4,9% |
Com 2 rodadas, qual método você usa para "quem é #1" está próximo de cara ou coroa em termos de concordar com o método mais simples baseado em contagem — mostrando que a sofisticação do Bradley–Terry ainda não compra uma resposta estável nesse tamanho de amostra, apenas uma instável de forma diferente. Essa instabilidade é uma propriedade do tamanho da amostra, não específica da TXN, e é exatamente por isso que apresentamos isso como uma descoberta piloto a ser revisitada com mais dados, não como uma afirmação confirmada de liderança setorial.
7. Quantas rodadas seriam realmente necessárias?
A seção 6 mostra que a posição #1 é instável em 2 rodadas. A próxima pergunta natural — e a que este texto se propôs a responder quantitativamente, não qualitativamente — é: quantas rodadas seriam suficientes, e o que se ganha em cada etapa?
Simulamos torneios round-robin do mesmo desenho de 12 empresas pelo método do círculo, em durações de calendário de 1 rodada até o round-robin completo de 11 rodadas (cada empresa joga contra cada outra exatamente uma vez), atribuindo forças "reais" aleatórias em cada um dos 3.000 torneios simulados por linha. Em seguida, medimos o quão de perto a classificação Bradley–Terry resultante correspondia à ordem de força real (conhecida, na simulação):
| Rodadas por empresa | Duelos totais (12 empresas) | Correlação de posição com a ordem real (Spearman) | Taxa de identificação do top 3 | % de empresas com histórico "perfeito" |
|---|---|---|---|---|
| 1 | 6 | 0,32 | 37,0% | 100% |
| 2 (este piloto) | 12 | 0,47 | 48,5% | 56,7% |
| 3 | 18 | 0,55 | 51,1% | 34,5% |
| 4 | 24 | 0,60 | 55,9% | 22,8% |
| 5 | 30 | 0,65 | 59,4% | 16,1% |
| 6 | 36 | 0,68 | 60,6% | 11,2% |
| 8 | 48 | 0,74 | 64,2% | 6,4% |
| 11 (round-robin completo) | 66 | 0,78 | 66,9% | 3,1% |
Duas coisas se destacam. Primeiro, o desenho piloto usado aqui (2 rodadas) fica em uma correlação de posição de aproximadamente 0,47 com a ordem "real" — útil para sinalizar camadas amplas, não confiável para afirmar um #1 específico. Segundo, mais da metade do campo (56,7%) termina um torneio de 2 rodadas com um histórico matematicamente "perfeito" de 2-0 ou 0-2 — o que parece decisivo, mas, segundo a seção 6, é exatamente a condição que torna instável a ordem de posição individual, já que um histórico perfeito não contém informação sobre o quanto uma empresa é melhor, apenas que ela venceu todos os jogos que por acaso disputou.
Lendo a tabela como um guia de planejamento para futuros torneios deste tipo:
- 1–2 rodadas: barato, rápido, bom para sinalizar camadas amplas (vencedores claros vs. retardatários claros) em conteúdo construído em torno de um piloto ou um único ciclo de publicação. A posição individual dentro da camada superior ou inferior não deve ser tratada como definitiva.
- 3–4 rodadas: significativamente melhor (correlação ~0,55–0,60) a um custo adicional moderado (18–24 duelos); um mínimo razoável se a classificação em si, não apenas a história de divergência com o DCF, for o ponto do texto.
- 5–6 rodadas: um meio-termo viável (correlação ~0,65–0,68) entre o rigor completo em nível de grupo e o custo de produção de dezenas de duelos.
- 8+ rodadas, até o round-robin completo de 66 duelos: retornos decrescentes por rodada adicional, mas o único regime em que se pode defender uma posição numerada específica (e não apenas uma camada) com confiança real.
8. Isso resolve a crítica da Parte 1?
Estruturalmente, sim, em parte: agregar 12 duelos pareados em uma rede conectada, e pontuar cada empresa contra a força implícita de todo o grupo em vez de contra um adversário arbitrário, é uma melhoria metodológica genuína em relação a um único duelo — é o que o "comparar com um grupo de pares" da avaliação relativa clássica realmente exige, traduzido para estatística de comparação pareada.
Empiricamente, a resposta é mais qualificada, e a tabela da seção 7 é a versão honesta dessa qualificação. O desenho específico de 2 rodadas usado aqui reduz — mas não elimina — a crítica original. A posição de uma empresa na classificação deste piloto é mais informativa do que o vencedor de um único duelo, mas, segundo as seções 6 e 7, ainda está mais próxima de uma estratificação grosseira do que de uma posição precisa e estável. A crítica da Parte 1 (seção 2.4) agora se lê melhor como: "resolvida em tipo, ainda não em grau" — o método para comparar com um grupo de pares existe e funciona; executá-lo em um tamanho de amostra que torne as posições individuais confiáveis é um custo separado e quantificável, mostrado acima.
9. Conclusões
A divergência relativo/absoluto/resiliência da Parte 1 não é um artefato da escolha de um par específico. Ela reaparece em escala setorial: TXN (#1 relativo, #9 DCF, #11 resiliência) e MRVL (#12 relativo, #6 DCF, #3 resiliência) mostram diferenças de 6 a 8 posições entre lentes que medem coisas genuinamente diferentes.
A resiliência é, como esperado (H2), a mais independente das três lentes. A pontuação #1 em resiliência da AMD coexiste com um histórico relativo e um múltiplo DCF medianos; a posição compartilhada #1/#2 de NVDA e AVGO em relativo e DCF coexiste com posições de resiliência #10 e #8. Uma pontuação alta em fatores de crescimento e margem, ou em um múltiplo de fluxo de caixa DCF, quase nada diz sobre o colchão de balanço.
O único caso sem divergência (INTC) é também o único caso de dificuldade inequívoca — última ou quase última em todas as lentes, e a única empresa em que a saída do motor DCF é degenerada (valor de empresa negativo), não apenas baixa. Isso é evidência de que a divergência vista em outros lugares reflete quadros subjacentes genuinamente mistos, não ruído nos próprios métodos de pontuação.
Um piloto de 2 rodadas é útil direcionalmente e instável individualmente, e isso agora é medido em vez de afirmado. A simulação mostra uma correlação de posição de ~0,47 com a ordem "real" nesse tamanho de desenho, uma probabilidade de 64,4% de que um método de contagem mais simples (Copeland) teria coroado um #1 diferente por pura variação amostral, e que 56,7% do campo termina com um histórico "perfeito" de 2-0 ou 0-2, pobre em informação. A posição #1 neste piloto (TXN) repousa sobre um único elo indireto no grafo de comparação (sua vitória sobre a ADI, cuja única credencial é uma única vitória sobre a AMD) — uma ilustração de livro-texto exatamente dessa instabilidade, não um defeito específico da TXN.
A crítica de par-contra-grupo-de-pares da Parte 1 está estruturalmente endereçada, mas apenas parcialmente resolvida na prática. O método para agregar muitos duelos em uma classificação relativa ao grupo existe e funciona; segundo a tabela da seção 7, tornar as posições de rank individuais (não apenas as de camada) confiáveis exige aproximadamente 5–8 rodadas (30–48 duelos) em vez de 2 — um número concreto e reutilizável para dimensionar o próximo torneio deste tipo, em vez de um vago chamado por "mais dados".
Este é um artigo de metodologia, não é aconselhamento financeiro. Todos os números vêm de relatórios públicos da SEC EDGAR (10-K/10-Q).
Toda avaliação de uma ação, no fim, responde a uma de duas perguntas diferentes, e a maioria dos debates sobre "qual método está certo" acontece porque as pessoas não percebem que estão discutindo perguntas diferentes.
Este texto passa primeiro pela teoria e depois a testa com números reais — NVIDIA (NVDA) contra AMD (AMD), Google (GOOGL) contra Meta (META), Amazon (AMZN) contra Walmart (WMT) — usando uma ferramenta que desenvolvi e que extrai dados fundamentais diretamente dos relatórios 10-K/10-Q da SEC. Sem estimativas de analistas, sem sentimento de mercado, sem movimento de preço — apenas os relatórios oficiais.
Parte 1 — Duas formas de perguntar "Quanto vale esta empresa?"
A avaliação intrínseca (absoluta) constrói o valor de uma empresa de dentro para fora — projeta os fluxos de caixa futuros, desconta-os a uma taxa que reflita o risco, e pronto. Isso remonta a The Theory of Investment Value (1938), de John Burr Williams: um ativo vale o valor presente do que vai pagar a você. O DCF, os modelos de desconto de dividendos e os modelos de lucro residual pertencem a esta categoria.
A avaliação relativa nunca avalia a empresa isoladamente — avalia-a em relação aos seus pares, partindo do pressuposto de que o mercado precificou negócios comparáveis de forma aproximadamente correta; a diferença entre o seu alvo e o grupo é o sinal. Múltiplos (P/L, EV/EBITDA) e sistemas de ranking entre pares pertencem a esta categoria.
Nenhuma das duas é "mais correta". Ambas se apoiam em pressupostos diferentes sobre o que se pode saber. A avaliação absoluta pressupõe que você consegue prever melhor do que o mercado. A avaliação relativa pressupõe que o mercado está, em média, aproximadamente certo, e que o seu trabalho é identificar a anomalia.
Onde o DCF se destaca, e onde falha
É o único método que deriva o valor do verdadeiro motor gerador de caixa do negócio, independentemente do que alguém está pagando por uma empresa comparável. Isso é poderoso quando setores inteiros enlouquecem (2000, 2021). O problema — bem documentado por Aswath Damodaran — é que os resultados do DCF são absurdamente sensíveis a três variáveis: taxa de crescimento, taxa de desconto e valor terminal. Só o valor terminal costuma representar de 60% a 80% do valor total da empresa, construído sobre uma única estimativa pontual de crescimento perpétuo. Você obtém um número preciso ao centavo, construído sobre um pressuposto que ninguém consegue verificar.
Onde os múltiplos se destacam, e onde falham
São rápidos, escalam para centenas de empresas e capturam informações que uma planilha não consegue capturar facilmente — qualidade da gestão, risco regulatório, sentimento setorial. A fragilidade estrutural é a circularidade: a avaliação relativa só funciona se o grupo de pares estiver precificado corretamente, em média. Se um setor inteiro estiver inflado, a avaliação relativa vai confirmar alegremente que o seu alvo está "barato em relação aos pares", mesmo que todo o grupo esteja caro em relação à realidade.
Tabela 1 — Comparação direta
| Critério | Avaliação Absoluta (DCF / DDM / RIM) | Avaliação Relativa (Múltiplos / Pontuação por Pares) |
|---|---|---|
| Base teórica | Valor presente dos fluxos de caixa futuros (Williams, 1938) | Lei do preço único, eficiência de mercado em forma fraca |
| Fonte de dados | Projeções do desempenho futuro da própria empresa | Dados atuais/históricos de empresas comparáveis |
| Dependência do mercado | Independente do preço atual | Totalmente dependente — o valor é função dos preços dos pares |
| Número de pressupostos críticos | Alto (crescimento, WACC, crescimento terminal) | Baixo (escolha do grupo de pares, pesos) |
| Sensibilidade a erros | Muito alta — o valor terminal domina o EV | Moderada — distribuída pelo grupo de pares |
| Risco de viés sistemático | Otimismo dos analistas nas projeções de crescimento | Circularidade — um setor mal precificado se autoconfirma |
| Risco específico da empresa | Explícito (via WACC, qualidade do fluxo de caixa) | Geralmente implícito ou ausente |
| Velocidade / escalabilidade | Baixa — intensiva em trabalho por empresa | Alta — aplicável trivialmente a dezenas de empresas |
| Transparência para o usuário | Baixa, a menos que os pressupostos sejam divulgados | Alta — "mais barato que os pares" é intuitivo |
| Resiliência a bolhas setoriais | Teoricamente resiliente | Vulnerável — herda a má precificação do setor |
| Usuário típico | Avaliadores, investidores de valor de longo prazo | Analistas sell-side, triagem de varejo |
Parte 2 — Testando os dois métodos nas mesmas empresas, ao mesmo tempo
Em vez de escolher um método, desenvolvi uma ferramenta que executa os dois lado a lado sobre os mesmos dados da SEC, mais uma terceira camada que mede a resiliência do balanço. Três relatórios separados, três perguntas separadas:
- Battle Report (relativo) — 8 métricas fundamentais (Crescimento de Receita, Margem de Caixa Operacional, ROIC, Sloan Ratio, Giro de Ativos, Giro de Recebíveis, Margem Operacional, Margem de FCF), ponderadas em uma pontuação de 0 a 100 para cada lado.
- DCF Report (absoluto) — um DCF completo de 3 anos com crescimento ajustado pela qualidade: uma penalização por Sloan Ratio para contabilidade de competência agressiva, um multiplicador de ROIC que escala o crescimento projetado pela eficiência de capital, e um multiplicador de margem de FCF pela qualidade da conversão em caixa. O WACC é derivado de um nível de ROIC, não da volatilidade histórica do preço.
- Resilience Report — um Índice de Resiliência Fundamental (0–100) construído a partir da cobertura caixa/dívida, autossuficiência de investimento (FCF/CapEx), qualidade dos resultados (fluxo de caixa operacional/resultado operacional) e prazo de liquidez, com uma matriz de consistência que sinaliza contradições internas.
Sendo transparente sobre os limites dessa abordagem: não há tabela de sensibilidade nem intervalo de Monte Carlo na saída do DCF (uma limitação conhecida frente a um modelo completo de estimativa pontual), não há prêmio de risco-país explícito (sem problema para grandes empresas dos EUA, uma lacuna para empresas internacionais), e a camada relativa compara um par por vez, em vez de uma mediana de um grupo completo de pares. Nada disso torna os números inúteis — apenas significa que devem ser lidos como evidência direcional, não como verdade absoluta.
Parte 3 — O estudo de caso: NVIDIA contra AMD
A pontuação relativa: 92–8, "Dominante", a favor da NVIDIA.
| Métrica | NVDA | AMD | Peso |
|---|---|---|---|
| Crescimento de Receita (CAGR 3A) | 100,05% | 13,64% | 16% |
| Margem de Caixa Operacional | 47,57% | 22,26% | 15% |
| ROIC | 51,01% | 4,46% | 15% |
| Margem Operacional | 60,38% | 10,66% | 12% |
| Margem de FCF | 47,50% | 19,44% | 12% |
| Giro de Ativos | 0,83x | 0,43x | 10% |
| Giro de Recebíveis | 5,30x | 5,74x | 8% |
Uma diferença de ROIC de 51% contra 4,5% não é erro de arredondamento. Em termos puramente operacionais, isso não é disputado.
O número absoluto conta uma história diferente:
| Parâmetro | NVDA | AMD |
|---|---|---|
| Valor da Empresa (T0) | US$ 4.285,24 B | US$ 108,03 B |
| Valor Justo por ação (T0) | US$ 176,47 | US$ 67,72 |
| WACC (do nível de ROIC) | 8,95% | 11,56% |
| Valor Justo, +3 anos | US$ 202,24 (+14,6%) | US$ 83,98 (+24,0%) |
Apesar de perder o duelo por 8 a 92, o potencial de valorização modelado em 3 anos da AMD é maior. O domínio da NVIDIA já está precificado em um valor de empresa de ~US$ 4,3 trilhões; mesmo na taxa de crescimento máxima do modelo, de 35%, a valorização percentual a partir de uma base já enorme é menor do que o crescimento composto mais modesto da AMD a partir de uma base muito menor. A avaliação relativa diz quem está ganhando agora. O DCF diz quanto você já pagou por essa vitória.
A camada de resiliência adiciona uma terceira reviravolta inesperada:
| Métrica | NVDA | AMD |
|---|---|---|
| Índice de Resiliência (FRI) | 64 — Moderado | 100 — Alto |
| Cobertura Caixa/Dívida | 12,24x | 4,12x |
| Autossuficiência de Investimento (FCF/CapEx) | 739,39x | 6,91x |
| Qualidade dos Resultados (CFO/Resultado Operacional) | 0,79x — sinalizado | 2,09x |
| Prazo de Liquidez | 0,5 ano — sinalizado | Infinito |
Uma empresa que acabou de vencer o duelo por 92–8 e carrega um valor de empresa derivado do DCF de US$ 4,28 trilhões pontua mais baixo em resiliência do que a empresa que ela demoliu. Vale uma ressalva: com US$ 102,7 bilhões em fluxo de caixa operacional, ninguém acha seriamente que a NVIDIA tem um problema de liquidez — a métrica de prazo aqui é quase certamente um artefato de fórmula sobre uma estrutura de balanço para a qual a métrica não foi projetada. Mas o sinal de qualidade dos resultados (resultado operacional superando o fluxo de caixa operacional) é um sinal real, mesmo que pequeno, que vale a pena conhecer.
Verificado de forma cruzada em mais dois pares, no mesmo dia:
| Par | Pontuação Relativa do Duelo | Índice de Resiliência (FRI) | Valorização DCF (+3A) |
|---|---|---|---|
| NVDA vs AMD | 92 : 8 (NVDA) | 64 vs 100 — AMD maior | NVDA +14,6% vs AMD +24,0% |
| GOOGL vs META | 10 : 90 (META) | 85 vs 83 — praticamente igual | GOOGL +18,2% vs META +16,2% |
| AMZN vs WMT | 55 : 45 (AMZN) | 100 vs 71 — AMZN maior | AMZN +18,6% vs WMT +18,7% — igual |
Mesmo padrão, verificado três vezes separadamente: uma pontuação relativa desequilibrada não prevê de forma confiável nem o ranking de resiliência, nem o ranking de retorno absoluto.
Conclusão
A avaliação relativa responde "qual negócio está operacionalmente mais forte agora" — e faz bem esse trabalho. A avaliação absoluta responde "quanto dessa força já está precificado". Uma camada de resiliência responde "o que acontece se as condições piorarem". São três perguntas diferentes, e tratar qualquer uma delas como resposta completa é onde a maioria dos debates de avaliação — tanto entre profissionais quanto entre investidores de varejo — dá errado.
Este é um artigo de metodologia, não é aconselhamento financeiro. Todos os números vêm de relatórios públicos da SEC EDGAR (10-K/10-Q).